香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


Linux 重启后补执行任务,关键是把“业务结果”和“进度游标”放进同一个持久化事务:结果提交成功,进度才前移;进程在提交前中断,事务回滚,未提交的批次重跑;提交后即使来不及记录日志,重启时也会从新游标继续。再由 systemd 在开机时启动任务,就能恢复处理,而不是从头重复已提交的数据。
下面以不可变的 JSONL 输入文件和 SQLite 结果库为例。每行包含稳定的业务标识 id 和待处理数值 value。实现适用于结果能写入同一 SQLite 数据库、处理逻辑本身没有外部副作用的场景。输入文件、状态库及所在磁盘必须在重启后仍可用;同一条逻辑数据在不同批次中也必须使用相同的标识。
处理流程是:读取当前字节偏移 → 解析一行 → 检查业务标识是否已完成 → 计算结果并写入结果表 → 更新偏移 → 提交事务。结果表和偏移表处于同一事务中,避免出现“进度已前移但结果没保存”或“结果已保存但进度没前移”的不一致。
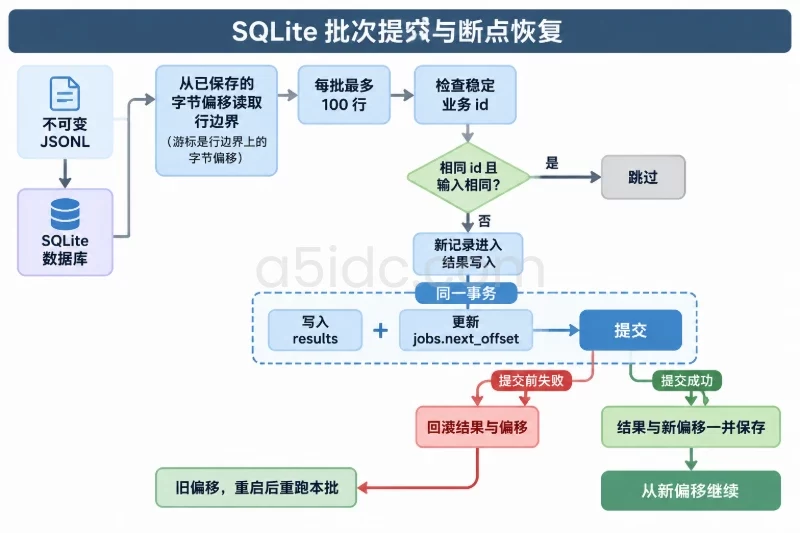
代码按每批 100 行提交。若进程在批次提交前退出,该批的数据库写入和游标更新一起回滚;若提交已完成,重启后从已保存的字节偏移继续。JSONL 按二进制方式读取,游标记录的是行边界上的字节位置,不是字符数。
将下面内容保存为 /opt/resume/worker.py。示例中的 transform() 只进行本地计算;生产环境应替换为实际处理逻辑,并避免在事务中调用外部服务。
#!/usr/bin/env python3

import hashlib
import json
import sqlite3
import sys
from pathlib import Path


BATCH_SIZE = 100


def sha256_file(path: Path) -> str:
    digest = hashlib.sha256()
    with path.open("rb") as file:
        for chunk in iter(lambda: file.read(1024 * 1024), b""):
            digest.update(chunk)
    return digest.hexdigest()


def transform(record: dict) -> dict:
    value = record.get("value")
    if isinstance(value, bool) or not isinstance(value, (int, float)):
        raise ValueError("字段 value 必须是数字")

    return {
        "id": record["id"],
        "value": value * 2,
    }


def main() -> None:
    if len(sys.argv) != 4:
        raise SystemExit(
            "用法:worker.py INPUT_JSONL SOURCE_ID STATE_DB"
        )

    input_path = Path(sys.argv[1])
    source_id = sys.argv[2]
    db_path = Path(sys.argv[3])

    if not input_path.is_file():
        raise SystemExit(f"输入文件不存在:{input_path}")

    input_hash = sha256_file(input_path)

    conn = sqlite3.connect(db_path, timeout=30)
    conn.execute("PRAGMA journal_mode=WAL")
    conn.execute("PRAGMA synchronous=FULL")
    conn.execute("PRAGMA busy_timeout=30000")

    conn.execute(
        """
        CREATE TABLE IF NOT EXISTS jobs (
            source_id TEXT PRIMARY KEY,
            input_sha256 TEXT NOT NULL,
            next_offset INTEGER NOT NULL DEFAULT 0,
            updated_at TEXT NOT NULL DEFAULT CURRENT_TIMESTAMP
        )
        """
    )
    conn.execute(
        """
        CREATE TABLE IF NOT EXISTS results (
            item_key TEXT PRIMARY KEY,
            input_json TEXT NOT NULL,
            result_json TEXT NOT NULL,
            created_at TEXT NOT NULL DEFAULT CURRENT_TIMESTAMP
        )
        """
    )

    # 为本次不可变输入登记游标;已有 source_id 必须对应相同文件内容。
    try:
        conn.execute("BEGIN IMMEDIATE")
        job = conn.execute(
            "SELECT input_sha256 FROM jobs WHERE source_id = ?",
            (source_id,),
        ).fetchone()

        if job is None:
            conn.execute(
                "INSERT INTO jobs (source_id, input_sha256, next_offset) "
                "VALUES (?, ?, 0)",
                (source_id, input_hash),
            )
        elif job[0] != input_hash:
            raise ValueError(
                "source_id 已绑定到不同输入文件;请使用新的 source_id,"
                "不要直接替换处理中或已登记的输入文件"
            )

        conn.commit()
    except Exception:
        conn.rollback()
        conn.close()
        raise

    try:
        with input_path.open("rb") as file:
            while True:
                conn.execute("BEGIN IMMEDIATE")
                try:
                    job = conn.execute(
                        "SELECT next_offset, input_sha256 "
                        "FROM jobs WHERE source_id = ?",
                        (source_id,),
                    ).fetchone()

                    if job is None or job[1] != input_hash:
                        raise RuntimeError("任务状态与输入文件不匹配")

                    file.seek(job[0])
                    next_offset = job[0]
                    line_count = 0
                    inserted_count = 0
                    reached_eof = False

                    while line_count < BATCH_SIZE:
                        raw_line = file.readline()
                        if raw_line == b"":
                            reached_eof = True
                            break

                        line_count += 1
                        next_offset = file.tell()

                        if not raw_line.strip():
                            continue

                        record = json.loads(raw_line.decode("utf-8"))
                        if not isinstance(record, dict):
                            raise ValueError("每行 JSON 须为对象")

                        item_key = record.get("id")
                        if not isinstance(item_key, str) or not item_key:
                            raise ValueError("每行都必须包含非空字符串 id")

                        # 固定序列化方式,便于核对同一业务标识对应的输入。
                        input_json = json.dumps(
                            record,
                            ensure_ascii=False,
                            sort_keys=True,
                            separators=(",", ":"),
                        )

                        existing = conn.execute(
                            "SELECT input_json FROM results WHERE item_key = ?",
                            (item_key,),
                        ).fetchone()

                        if existing is not None:
                            if existing[0] != input_json:
                                raise ValueError(
                                    f"id={item_key!r} 已有不同输入记录;"
                                    "须先确认业务上的更正或版本策略"
                                )
                            # 相同业务数据已完成,不重复写入结果。
                            continue

                        result = transform(record)
                        result_json = json.dumps(
                            result,
                            ensure_ascii=False,
                            sort_keys=True,
                            separators=(",", ":"),
                        )

                        conn.execute(
                            """
                            INSERT INTO results
                                (item_key, input_json, result_json)
                            VALUES (?, ?, ?)
                            """,
                            (item_key, input_json, result_json),
                        )
                        inserted_count += 1

                    conn.execute(
                        """
                        UPDATE jobs
                        SET next_offset = ?, updated_at = CURRENT_TIMESTAMP
                        WHERE source_id = ?
                        """,
                        (next_offset, source_id),
                    )
                    conn.commit()

                except Exception:
                    conn.rollback()
                    raise

                if line_count:
                    print(
                        f"source_id={source_id} "
                        f"本批读取={line_count} "
                        f"新增结果={inserted_count} "
                        f"next_offset={next_offset}",
                        flush=True,
                    )

                if reached_eof:
                    break
    finally:
        conn.close()


if __name__ == "__main__":
    main()
输入文件示例:
{"id":"order-1001","value":12}
{"id":"order-1002","value":8}
{"id":"order-1003","value":25}
运行方式:
python3 /opt/resume/worker.py \
  /data/import.jsonl \
  import-20250308 \
  /var/lib/resume/state.db
source_id 标识一份不可变输入。同一份文件重跑时使用相同 source_id;文件内容变化时使用新的 source_id。id 是结果去重的业务键,必须稳定且能唯一表示一条逻辑数据。若标识只在某个租户或业务范围内唯一,应将范围纳入标识,例如 tenant-a:order-1001。相同标识对应不同输入时,程序会报错停止,而不是静默跳过更正数据。
程序启动时会计算输入文件的 SHA-256,因此每次启动都要读取完整文件;大文件可在生产流程中预先生成可信的内容摘要并校验。输入应先完整写入临时文件,再原子发布为正式文件,并避免任务运行期间修改。否则文件内容和已保存游标可能不再对应。
将下面配置保存为 /etc/systemd/system/resume-job.service。示例中的用户、路径和 source_id 需要按实际环境替换,并确保运行用户能读取输入文件、写入状态库所在目录。
[Unit]
Description=Resume interrupted JSONL job
After=local-fs.target
StartLimitIntervalSec=5min
StartLimitBurst=5

[Service]
Type=oneshot
User=worker
Group=worker
WorkingDirectory=/opt/resume
ExecStart=/usr/bin/python3 /opt/resume/worker.py /data/import.jsonl import-20250308 /var/lib/resume/state.db
Restart=on-failure
RestartSec=15s
RemainAfterExit=yes

[Install]
WantedBy=multi-user.target
启用并启动服务:
sudo systemctl daemon-reload
sudo systemctl enable --now resume-job.service
查看执行状态和程序输出:
sudo systemctl status resume-job.service
sudo journalctl -u resume-job.service
服务成功退出后,状态通常显示为 active (exited)。机器重启后 systemd 会重新启动该任务,程序读取数据库中的偏移继续处理;若任务在运行中失败,systemd 会按配置重试,达到启动频率限制后需先检查日志和输入再处理。
这套事务边界只覆盖同一个 SQLite 数据库。若 transform() 内部发起付款、发送邮件、调用远程接口或写入另一台数据库,远程操作成功而本地事务未提交时,重启后仍可能再次调用;网络超时也无法仅凭本地游标判断对端是否已完成操作。因此不能把本地检查点描述成跨系统的“恰好一次”。
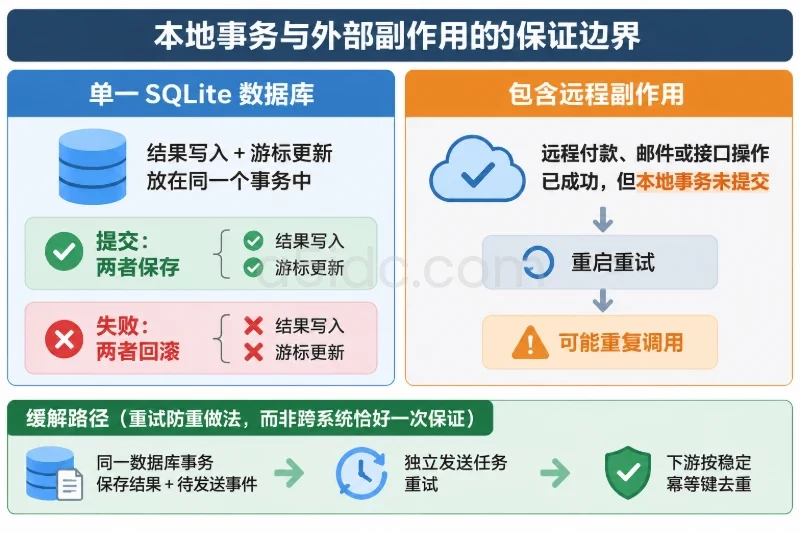
常见做法是在同一数据库事务中保存结果和待发送事件,再由独立发送任务重试;下游系统应支持按稳定幂等键去重。若下游不支持幂等处理,则需要业务侧对账或补偿机制,明确接受“可能重复”或“可能遗漏”的边界。
遇到 JSON 格式错误、缺少 id、数值类型不符合预期,或同一 id 对应不同输入时,本批事务会回滚,游标不会跳过出错行,任务会失败并写入 systemd 日志。修复数据时应生成一份新的、不可变的输入并使用新的 source_id;稳定的业务 id 可使其中已完成且输入未变的数据不再重复写入。若确需更正已完成数据,应先确定覆盖、保留版本或人工复核规则,而不是直接删除结果或手动前移游标。
可用少量测试数据检查以下分支:
source_id,结果数量应保持不变。journalctl 中的异常位置。source_id 替换输入内容,确认程序拒绝继续,避免用旧游标读取不同文件。SQLite 状态库同时保存处理结果和断点,备份与恢复时应保留同一份一致的数据库状态;数据库启用 WAL 时,不要在服务运行期间只复制主数据库文件。最终检查重点是:输入是否不可变、业务标识是否稳定、结果与游标是否原子提交,以及开机后的服务日志是否显示从已保存偏移继续执行。
A5idc数据提供香港、美国、日本等地区的物理服务器,涵盖不同CPU、内存与SSD/NVMe存储配置,可作为运行任务处理程序及承载SQLite状态库、输入文件的基础资源。不同配置对应不同计算与存储需求,各地区的硬件和网络方案也有所区别,适用于需要本地计算与数据存储环境的业务部署。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9906.html