香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


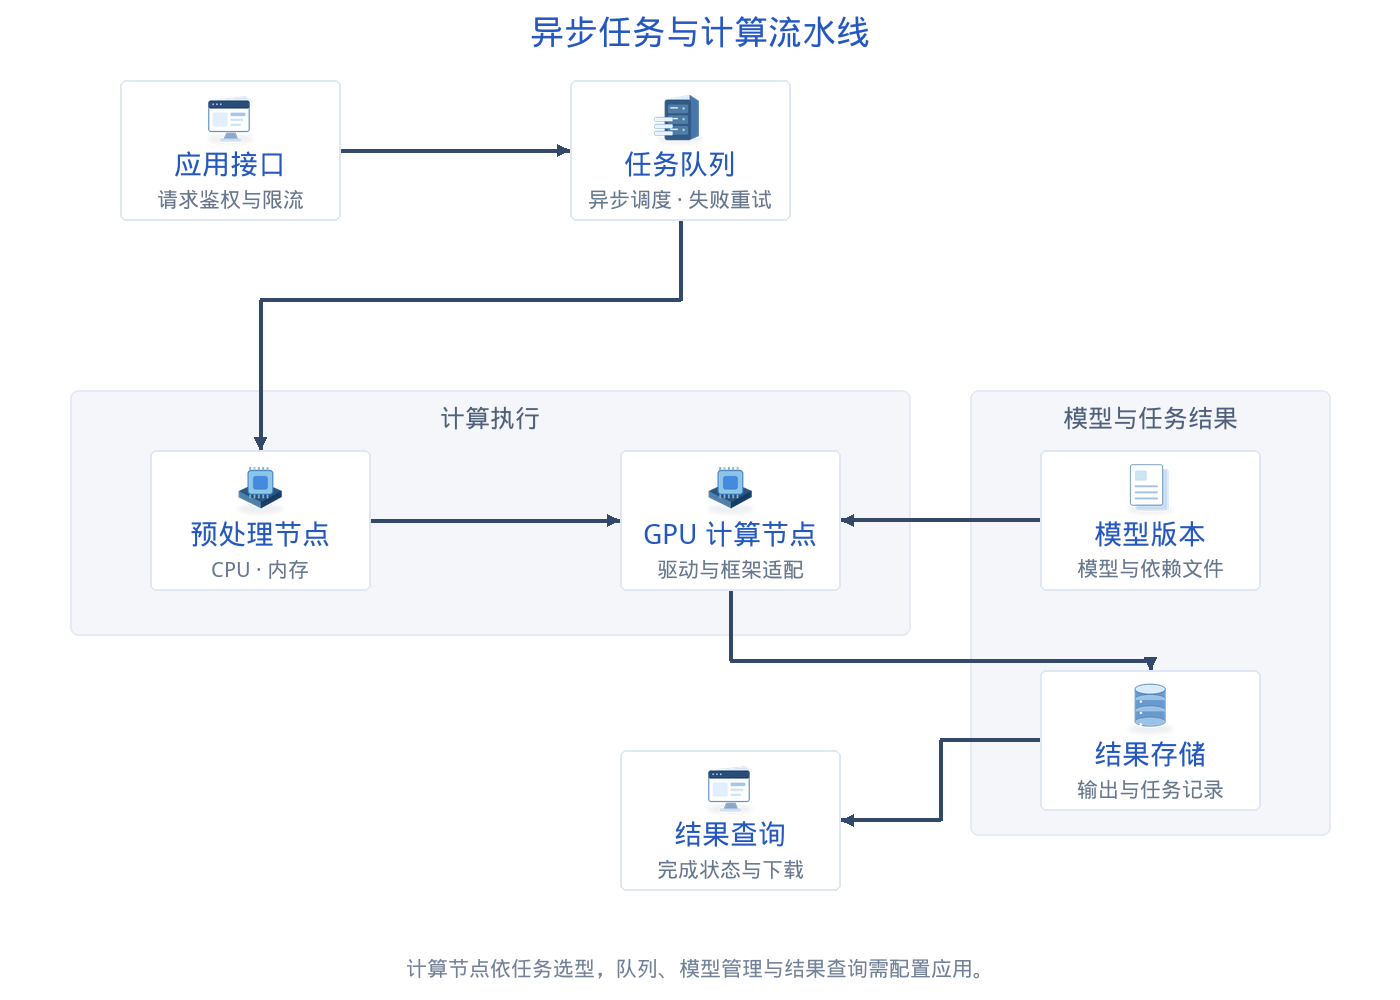
接口、任务与结果分层,让 GPU 资源服务实际负载。

核对 GPU 型号、显存与框架版本。

一并评估预处理、内存和磁盘吞吐。

根据用户和数据传输选择地区。
按业务负载选择资源,查看当前配置与价格

A100 80GB与RTX 4090 48GB显卡可选,搭配NVMe高速存储及25M CN2直连带宽,适合大模型推理、企业知识库、AI客服、图像处理及模型测试,兼顾GPU计算与内地访问需求。
A100 80GB、RTX 4090 48GB及RTX 5090 32GB显卡可选,搭配NVMe高速存储,可选1G普通三网直连或3G国际带宽,适合AI训练、大模型推理、图像生成及视频渲染,满足GPU计
采用AMD EPYC处理器,有6核至256核多种配置,搭配NVMe高速存储、15M或25M CN2及100M国际带宽,满足高主频计算与多核并发需求,适合企业网站、游戏服务、数据库及虚拟化部署。
汇聚网络与生态资源,支撑业务部署