香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


台湾服务器出现“Too many open files”时,调整了 ulimit、系统配置或服务文件后仍然报错,通常不是“配置完全没生效”这么简单:改动可能没有作用到报错的进程,也可能只提高了单进程上限,而进程实际持有的文件描述符仍在持续增长。排查时应先确认错误来自哪个进程、它当前的软硬限制和已打开数量,再判断是服务启动方式、容器边界、系统总量,还是应用连接与文件管理导致。
服务器位于台湾不会改变 Linux 文件描述符限制的生效规则;但业务连接增长、请求重试或连接长期不释放,可能增加进程持有的套接字数量,使问题更早出现。EMFILE 通常表示单个进程达到文件描述符上限,ENFILE 通常表示系统级文件表资源不足。日志里的文字可能经过应用或运行库包装,不能只凭报错文案判断根因。
文件描述符是进程访问文件、套接字、管道等资源时使用的编号。进程可用数量受自身限制影响,系统还存在全局文件表限制。要诊断配置是否生效,关键是检查实际报错进程,而不是只看当前登录终端中的设置。
先从应用日志找到发生错误的时间、PID、操作类型和报错调用。open、accept、socket 等操作都可能因描述符不足失败。若日志没有 PID,可先查看服务的主进程,再结合工作进程和日志时间核对:
systemctl show example.service -p MainPID -p LimitNOFILE
systemctl status example.service
将 example.service 替换为实际服务名。主进程 PID 不一定就是报错的工作进程;Nginx、Java 服务和多进程应用常有多个子进程,应逐一确认。
选定目标 PID 后,直接读取该进程的限制和当前打开数量:
PID=1234

grep -i 'Max open files' "/proc/$PID/limits"
ls "/proc/$PID/fd" | wc -l
/proc/PID/limits 中的 Max open files 会显示软限制和硬限制;软限制是进程通常受约束的当前值,硬限制是软限制可提高到的上限。/proc/PID/fd 下的条目数可用于估算该进程正在持有的描述符数量。检查过程中,进程可能继续打开或关闭资源,因此读数会有小幅变化;权限不足时需由有权限的账号执行。
也可以通过 prlimit 查看进程限制:
prlimit --pid "$PID" --nofile
判断时重点比较两项:进程当前打开数量是否接近软限制,以及该进程的软硬限制是否和预期一致。如果当前数量远低于软限制,单纯继续提高上限通常不能解释报错,应回查是否看错 PID、是否有其他进程报错,或日志是否属于不同容器与服务实例。
排查可以由外向内分为连接来源、系统资源、服务启动配置和应用资源管理。每一层都要用观察结果决定是否进入下一层,避免看到“打开文件过多”就直接改全局参数。
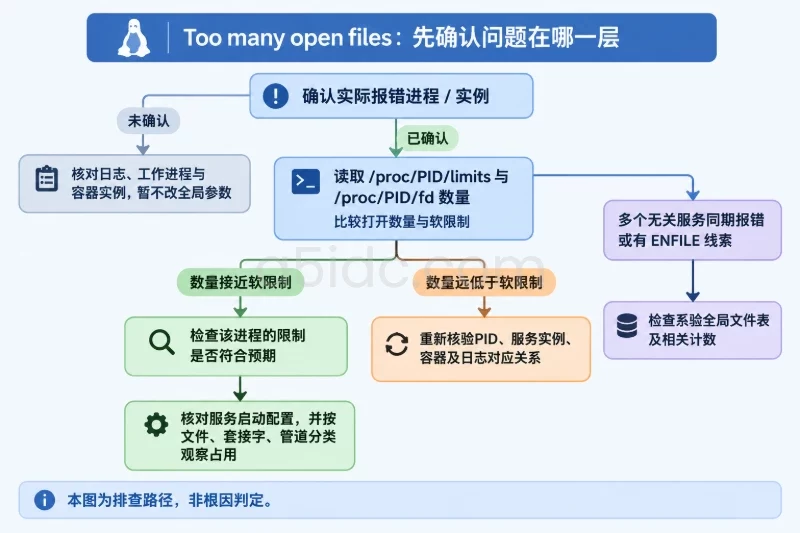
| 层级 | 观察依据 | 更可能的问题 | 下一步 |
|---|---|---|---|
| 网络与连接负载 | 同一时段连接数、重试或长连接明显增加 | 套接字占用上升,连接释放慢 | 按进程检查套接字、连接池和超时设置 |
| 系统全局资源 | 多个进程同时报错,系统级文件表接近上限 | 全局文件表压力或资源使用异常 | 查看 file-max、file-nr 和其他进程占用 |
| 服务启动配置 | /proc/PID/limits 低于预期 | 配置写在错误位置,或服务未重新启动 | 核对 systemd、启动脚本和容器的限制 |
| 应用自身 | 单进程描述符数持续增长或稳定撞上上限 | 文件、套接字或管道未关闭,或并发需求超出容量 | 分类统计描述符并检查应用行为 |
网络路径本身不会改写进程的 nofile 限制,但访问量突增、调用方重试、连接池设置不匹配或连接长期保持,都可能使服务持有更多套接字。可结合服务日志和连接状态检查:
ss -s
ss -tanp
ss -s 提供系统范围内的连接概况;ss -tanp 可查看 TCP 连接及关联进程,但输出量可能较大,且查看其他进程信息通常需要相应权限。不要把 TIME_WAIT 数量直接当作应用持有的文件描述符数量:它说明连接处于某种 TCP 状态,不等同于该连接仍由目标进程持有。
若报错进程的描述符中套接字占比高,进一步检查连接池最大连接数、空闲连接回收、读写超时、请求重试和长连接策略。若连接数并未上升,或报错更集中在文件读写操作,就不应将原因归到网络层。
检查当前系统全局文件表的配置与使用情况:
sysctl fs.file-max fs.nr_open
cat /proc/sys/fs/file-nr
fs.file-max 是系统级文件表容量相关参数;fs.nr_open 则约束单进程可设置的文件描述符硬上限。/proc/sys/fs/file-nr 展示系统文件表相关计数,可与 fs.file-max 对照观察。不同内核版本对计数项的呈现可能不同,不宜仅凭其中一个数字断定系统已耗尽。
如果只有一个服务进程触及自身限制,而系统全局资源仍有余量,应优先检查该进程的限制和占用情况,而不是直接扩大 fs.file-max。反过来,若多个无关服务在相近时间出现 ENFILE,系统级资源才更值得重点排查。提高全局上限不会自动修复单进程的 EMFILE,也不会解决应用持续泄漏描述符的问题。
常见误区是只在 SSH 终端运行 ulimit -n,看到数值变大,就以为后台服务也已更新。ulimit 通常只影响当前 shell 及其之后启动的子进程;已经运行的服务不会因为修改了当前终端设置而自动改变限制。
Linux 上通过 systemd 启动的服务,应检查该服务实际加载的属性和配置:
systemctl show example.service -p LimitNOFILE
systemctl cat example.service
systemctl cat 用于查看主 unit 和可见的附加配置。即使服务文件里已经写入较高的值,也要以目标进程的 /proc/PID/limits 为最终核对依据。服务未重启、配置写在另一个 unit、服务实际由容器或其他守护进程启动,都可能导致检查结果与预期不一致。
/etc/security/limits.conf 及 /etc/security/limits.d/ 常用于 PAM 登录会话的资源限制,通常不会直接替代 systemd 服务的 LimitNOFILE。因此,调整登录用户限制后,应确认服务是否确实由该 PAM 会话启动;如果是 systemd 管理的服务,优先核对 systemd 对该服务生效的限制。
容器还需要单独检查。容器内看到的限制取决于启动方式、运行时和容器进程自身的资源限制;仅修改宿主机某个用户的登录限制,不保证会影响已经创建的容器。对于 Docker,可查看容器配置,再在容器内检查目标进程:
docker inspect --format '{{json .HostConfig.Ulimits}}' example-container
docker exec example-container sh -c 'grep -i "Max open files" /proc/1/limits'
上述容器内检查的 PID 1 仅代表容器的主进程;如果报错来自其他进程,应改查对应 PID。Compose 环境也应核对服务配置中的 ulimits,并在变更后按实际部署流程重建或重启容器,再检查运行中进程的限制。不要仅以配置文件内容或宿主机 shell 的 ulimit 输出作为生效证据。
当限制已经生效,但进程仍很快再次报错,要比较不同时间的描述符数量。若数量随运行时间持续上升,且业务负载没有相应变化,优先调查资源是否未关闭;若数量随并发稳定上升并在高峰接近上限,则可能是容量设置、连接池或并发模型不匹配。
可按时间记录目标进程数量,并查看描述符指向的资源类型:
PID=1234
date
ls "/proc/$PID/fd" | wc -l
ls -l "/proc/$PID/fd" | head -n 30
链接目标可能显示普通文件、管道或 socket:[编号]。如果系统安装了 lsof,也可按进程查看明细:
lsof -nP -p "$PID"
描述符很多时,完整输出可能较大,应避免在高负载生产环境中反复执行或无目的地保存全部结果。重点观察资源是否集中在同一类:大量日志或临时文件可能指向文件关闭与轮转问题;大量套接字可能指向连接池、超时或连接释放;大量管道则应检查子进程通信和管道关闭逻辑。计数随请求增长、空闲后仍不下降,通常比某一次瞬时高值更有诊断意义。
如果重启服务后计数暂时恢复,而后又随时间持续增长,重启只能作为临时恢复手段,不能替代根因修复。需要结合应用日志、代码资源生命周期或运行时指标定位未关闭的文件、响应体、套接字和子进程句柄。
建议按低风险顺序处理,先收集证据,再调整限制或服务配置:
/proc/PID/limits 与 /proc/PID/fd。若限制值没有达到预期,继续查启动配置;若数量远低于限制,则回查报错是否来自另一个进程或实例。fs.file-max、fs.nr_open 和 /proc/sys/fs/file-nr,并确认是否有其他进程同时报错。仅单个服务受限时,不要把全局参数作为默认调整项。LimitNOFILE;PAM 会话查登录限制;容器查运行时配置和容器内进程。每次变更后都要重新检查运行中目标 PID,而不是只检查配置文本。如果确认报错进程由 systemd 管理、其软硬限制低于业务所需,而且应用没有明显的描述符泄漏,可为该服务设置限制。下面以 example.service 和 65535 为示例值;实际值应按连接并发、每个请求可能占用的描述符数量、日志文件和子进程需求估算,不应将示例值视为所有服务的默认目标。
先备份现有 unit 或覆盖配置,并记录当前限制,避免覆盖已有设置。然后创建 systemd drop-in:
sudo systemctl edit example.service
在编辑器中加入:
[Service]
LimitNOFILE=65535:65535
保存后重新加载 systemd 配置,并按维护窗口安排服务重启:
sudo systemctl daemon-reload
sudo systemctl restart example.service
重启可能中断服务或正在处理的连接;执行前应确认该服务可重启、影响范围可接受,并按业务要求安排流量切换或维护窗口。重启后重新获取 PID,并检查 /proc/PID/limits。如果数值仍未变化,确认编辑的服务名与实际 unit 一致、drop-in 被加载,且报错进程确实由该 unit 启动;若服务运行在容器内,则还需检查容器层限制。
回滚时恢复备份,或移除本次新增的 drop-in,再执行 systemctl daemon-reload 并按维护安排重启服务。回滚同样会影响运行中的服务,不能把删除配置文件视为对已运行进程立即生效。
以下输出是用于说明判断方式的示例,不是对某台台湾服务器的实测结果:
Max open files 1024 65535 files
若同一进程的已打开数量在高峰时达到约 1020,且日志同时出现 EMFILE,可以判断单进程软限制是直接瓶颈之一。再比较系统全局状态:如果其他进程正常、全局文件表有余量,根因更可能在该服务限制或其资源使用方式;如果多个服务都出现类似问题,则需要继续检查全局资源及其他进程占用。
另一个常见情形是配置里已写入较高限制,但目标 PID 的 /proc/PID/limits 仍显示旧值。这时应把排查重心放在“配置没有作用到这个进程”:可能检查的是错误服务、服务没有按变更后流程重启、实际进程由不同启动器拉起,或报错进程处于容器内。此时继续修改应用连接池通常不能修正限制未生效的问题。
恢复验证应同时覆盖限制、资源趋势和错误表现:
EMFILE 或 ENFILE,并确认报错时间与进程指标相互对应。验证时不宜为了复现问题而在生产环境突然施加大量连接或文件操作。可先用低风险、可控的业务负载观察;确需压力测试时,应限定测试对象、并发量和持续时间,并预先确认服务容量与回退方案。
为避免问题再次出现,至少为关键服务持续观察当前打开描述符数、进程限制值、连接池使用情况和 EMFILE、ENFILE 日志。告警阈值应结合服务平时基线和软限制设定;例如,当使用量长期高于软限制的约 70%至80%时,可先触发容量检查或趋势告警,而不是等到达到上限后才处理。这个比例是便于起步的参考值,突发型服务应依据其流量波动调整。
还应监控进程重启后的描述符基线及其随运行时间的变化。若每次重启后从低位开始、随后缓慢而持续上升,即使暂时未触发报错,也值得检查资源释放;若只在流量峰值快速上升并随后回落,则应评估峰值并发与限制之间是否留有合理余量。这样既能发现配置未生效,也能避免把应用资源泄漏误判为单纯的上限不足。
面向网站、业务后台与接口服务等 Linux 部署场景,A5idc数据提供中国台湾台北等地区的物理服务器方案,涵盖不同 CPU、存储及优化线路和国际线路配置,可对应不同业务负载、数据规模与访问区域。对于连接和文件操作较多的服务,这些计算、存储与网络资源为业务运行提供部署基础;多地区产品布局也为不同区域的业务部署提供资源选择。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9325.html