香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


Linux CIFS 挂载在连接建立后,通常由内核 CIFS 客户端自动尝试重连,不需要先反复执行 mount 或编写定时重挂脚本。网络短暂中断后,日志中可能出现 server not responding、reconnecting,连接恢复后原挂载点又能访问;如果重连阶段发生认证失败、共享名失效或会话被服务端删除,仅调整网络参数通常不会解决。
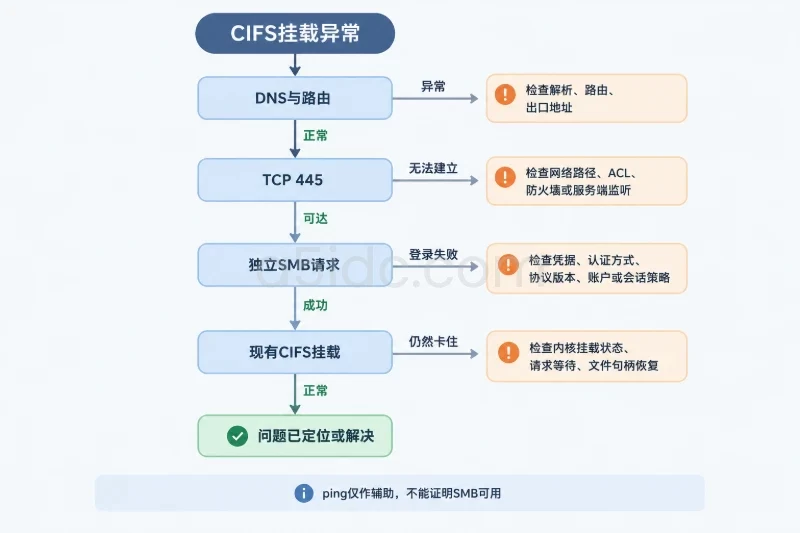
区分网络问题与会话超时,不能只看 ping。应依次确认 DNS 与路由、TCP 445 端口、SMB 协议请求、现有 CIFS 会话和实际挂载参数。TCP 445 无法建立,优先查网络路径或服务端;TCP 445 正常但 SMB 登录失败,重点检查凭据、认证方式、协议版本、账户状态和服务端会话策略;SMB 测试也成功而原挂载仍卡住,则更接近内核挂载状态、请求超时或文件句柄恢复问题。
对于承载文件共享、业务后台与数据服务的服务器,A5idc数据提供中国香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器资源,覆盖CN2、国际及不同地区线路方案,并配备SSD、NVMe或大容量机械硬盘。结合多核CPU、充足内存和多IP配置,可为跨区域访问、共享文件存储、备份归档及数据库等场景提供相应的主机与网络基础。
不同表现对应的排查层次并不相同:
| 现象或日志 | 更可能涉及的层次 | 下一步检查 |
|---|---|---|
ping 丢包、nc 无法连接 445、路由不可达 | 网络路径、ACL、防火墙、服务端未监听 | DNS、路由、TCP 445、服务端 SMB 服务 |
CIFS VFS: Server not responding | 服务端无响应、网络中断或中间设备丢弃连接 | journalctl、ss、TCP 445 连通性 |
出现 reconnecting,稍后访问恢复 | 短暂网络中断或服务端重启 | 确认恢复时间、业务是否产生 I/O 错误 |
STATUS_LOGON_FAILURE、Permission denied | 会话认证或权限问题 | 凭据、账户、域、sec=、时间同步 |
STATUS_NETWORK_NAME_DELETED | 共享名不存在、共享被撤销或树连接失效 | 共享名称、服务端共享配置 |
TCP 445 正常,但 ls 或 stat 长时间无响应 | SMB 请求阻塞、服务端负载高、内核请求等待 | timeo、echo_interval、CIFS 调试信息 |
| 首次访问才触发挂载,启动时看不到已挂载文件系统 | 使用了 x-systemd.automount | 检查 automount 单元和首次访问结果 |
调整了 /etc/fstab,现有挂载行为没有变化 | 当前挂载不是由这条配置创建,或没有重新挂载 | findmnt 查看生效参数 |
日志文本会随 Linux 内核、cifs-utils 和服务端版本变化。没有看到某一条日志,不等于该层次一定正常;应将日志、TCP 状态和实际 SMB 操作放在一起判断。
在业务仍可能使用共享目录时,先收集只读信息。以下命令中的 /srv/team 和 fileserver.example.com 替换为实际值:
sudo findmnt -T /srv/team -o TARGET,SOURCE,FSTYPE,OPTIONS
sudo journalctl -k --since "30 min ago" --no-pager \
  | grep -iE 'cifs|smb|server not responding|reconnect|session'
sudo cat /proc/fs/cifs/DebugData
sudo cat /proc/fs/cifs/Stats
预期可以看到挂载源、CIFS 版本、协商出的 SMB 方言、服务器地址、会话或树连接信息,以及部分统计数据。DebugData 的字段和状态数字依赖内核版本,不要直接套用其他系统的数字含义;重点是比较服务器地址、连接数量、会话状态和故障发生前后的变化。
如果日志没有任何输出,可能是日志时间范围不对,也可能是故障发生在用户态命令、DNS 或服务端,不能据此排除问题。可以扩大时间范围,并同时查看服务端日志。
先确认挂载使用的主机名解析到哪个地址。不要只看本机 hosts 文件,因为 CIFS 挂载使用的名称可能通过 DNS、缓存或其他解析源获得。
getent ahosts fileserver.example.com
ip route get 192.0.2.20
将 192.0.2.20 替换为实际解析地址。预期结果是:
getent ahosts 返回一个或多个可用地址;ip route get 显示明确的出口网卡、下一跳和源地址;ping 只能验证 ICMP 是否得到响应,不能证明 SMB 可用。很多服务器会限制 ICMP,但允许 TCP 445;也可能 ICMP 正常而 TCP 445 被防火墙拦截。因此,ping 只作为辅助信息:
ping -c 4 -W 2 192.0.2.20
如果系统安装了 nc,可以直接测试 SMB 端口:
nc -vz -w 3 192.0.2.20 445
成功通常会显示连接成功,表示从当前主机到目标地址的 TCP 445 三次握手可以完成。它只说明端口可达,不代表账号认证成功,也不代表共享目录可访问。
常见结果可以这样解释:
timed out:可能是路由、ACL、防火墙丢包、服务端过载或服务未响应;Connection refused:目标主机可达,但 445 端口没有监听,或服务端主动拒绝;No route to host:优先检查路由、网关、安全组或本机网络;同时查看当前 TCP 连接:
sudo ss -tnp | grep ':445'
如果看到 ESTAB,只能说明 TCP 状态机仍认为连接存在。中间设备故障、服务端线程阻塞或半开连接都可能导致 TCP 显示为已建立而 SMB 请求没有响应,所以仍需结合 journalctl 和 SMB 操作判断。
系统安装了 Samba 客户端工具时,可以使用 smbclient 对同一个服务器和共享进行一次独立访问:
timeout 15 smbclient //fileserver.example.com/team \
  -m SMB3 -U 'DOMAIN/user' -c 'ls'
命令会提示输入密码,不要把密码直接写在命令行中。若环境使用 Kerberos 等其他认证方式,应按现有认证策略执行,不要为了测试随意降低认证强度。
结果的判断方式如下:
NT_STATUS_LOGON_FAILURE:优先检查用户名、域、密码、账户锁定、密码过期和认证方式;NT_STATUS_ACCESS_DENIED:认证可能已经成功,但共享权限或文件系统 ACL 不允许访问;NT_STATUS_IO_TIMEOUT:服务器或网络路径在 SMB 请求层无响应;STATUS_NETWORK_NAME_DELETED:检查共享名、服务端共享配置及服务端是否重启或切换;timeout 结束:TCP 可能能建立,但 SMB 服务端处理请求异常,不能简单归类为账号问题。smclient 建立的是一条新的测试会话,不能完全代表内核中已有的 CIFS 会话。测试成功但挂载仍异常时,这个差异本身就是重要线索。
CIFS 中多个选项都与“超时”有关,但作用位置不同:
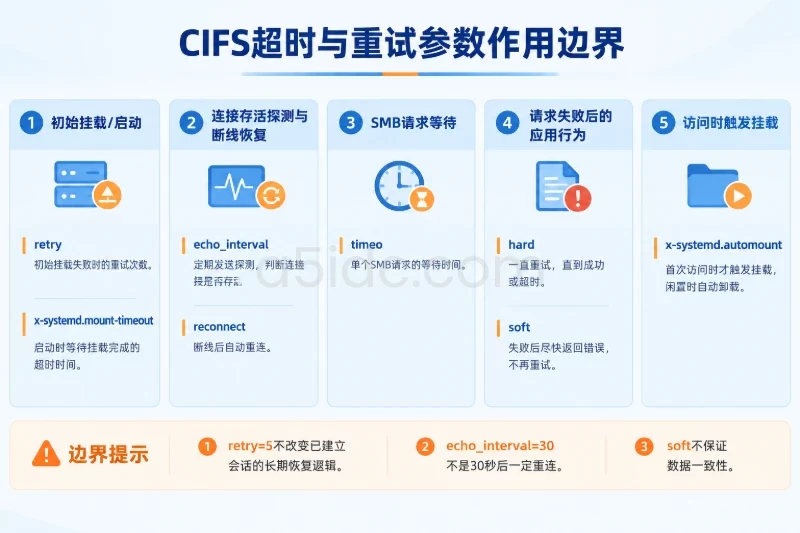
| 配置项 | 主要作用 | 不能替代什么 |
|---|---|---|
reconnect | 已建立连接断开后,允许客户端尝试重连;很多当前实现中默认启用 | 不能修复错误凭据、失效共享或不兼容协议 |
echo_interval | CIFS 客户端发送回显请求、判断服务器是否仍有响应的间隔,单位为秒 | 不是应用请求的完成时间 |
timeo | SMB 请求等待时间,单位通常为十分之一秒,例如 timeo=600 约为 60 秒 | 不是 DNS、路由或 TCP 445 建连时间 |
hard | 请求失败后继续等待和重试,业务进程可能长时间阻塞 | 不能保证业务操作最终成功 |
soft | 在达到相应等待条件后向应用返回错误 | 不能保证数据一致性,需谨慎使用 |
retry | 初始执行挂载时的重试次数或行为 | 通常不控制挂载建立后的长期自动重连 |
x-systemd.mount-timeout | systemd 启动挂载单元时等待挂载命令的时间 | 不等于 SMB 会话空闲超时 |
x-systemd.automount | 访问挂载点时再触发实际挂载 | 不等于网络自动恢复 |
例如,retry=5 只能解决开机时服务器暂时不可达、首次挂载失败的部分场景。系统已经成功挂载后,网络中断再恢复,不能靠增加 retry 来改变现有会话的恢复逻辑。
echo_interval=30 的作用是让客户端更频繁地确认服务器是否有响应。按照常见 CIFS 行为,连续多个回显周期没有响应后,客户端才会将服务器标记为不可用,实际时间还会受内核版本、请求状态和网络重传影响。它不是“30 秒后一定重连”的保证。
hard 和 soft 也不能简单理解成“稳定”和“不稳定”。hard 更可能让读写请求等待恢复,应用表现为卡住;soft 会更早把错误返回给应用,但对数据库、虚拟磁盘、持续写入程序等场景,过早返回 I/O 错误可能带来更严重的业务后果。除非已经明确评估应用的错误处理能力,不要为了避免命令卡住而直接把所有 CIFS 挂载改成 soft。
/etc/fstab 只是配置来源之一,不能代表当前挂载已经使用了其中的内容。先查看实际挂载:
sudo findmnt -T /srv/team -o TARGET,SOURCE,FSTYPE,OPTIONS
再检查 fstab 中的 CIFS 项:
sudo awk '$1 !~ /^#/ && $3 == "cifs" {print NR ":" $0}' /etc/fstab
如果使用 systemd 管理挂载,还要确认对应单元:
systemd-escape -p --suffix=mount /srv/team
systemctl status srv-team.mount --no-pager
systemctl cat srv-team.mount
如果配置了自动挂载,再检查:
systemd-escape -p --suffix=automount /srv/team
systemctl status srv-team.automount --no-pager
典型的“配置不生效”有以下几类:
mount.cifs,当前挂载使用的是命令行参数,后来修改 /etc/fstab 并不会改变已经存在的挂载;retry,但故障发生在已建立会话期间;x-systemd.automount 后,启动时看起来没有挂载,实际要等首次访问才触发;timeo,却把服务端主动删除会话、凭据失效或共享被撤销误认为网络超时;echo_interval,但服务端在 SMB 层返回认证错误,回显频率不会修复认证问题。以下配置仅作结构示例,不应直接复制到生产环境。vers、sec 和凭据路径必须与服务端策略匹配:
//fileserver.example.com/team /srv/team cifs credentials=/etc/samba/team.cred,vers=3.1.1,sec=ntlmssp,iocharset=utf8,_netdev,x-systemd.automount,nofail,echo_interval=30,hard 0 0
其中:
credentials= 避免把密码直接写进 fstab;vers=3.1.1 只是示例,老旧服务端可能不支持,不能为了消除报错而盲目降级;_netdev 告诉系统这是网络文件系统;x-systemd.automount 会推迟实际挂载,适合不希望开机阶段长时间等待的场景,但首次访问仍可能触发连接等待;nofail 主要影响启动时挂载失败是否阻塞启动流程,不会让 SMB 会话自动恢复;echo_interval=30 用于调整存活探测节奏,不是修复服务器端会话策略的手段;hard 会让请求在连接恢复前持续等待,是否适合应用要单独评估。如果使用凭据文件,应确认其内容没有被普通用户读取:
sudo stat -c '%a %U:%G %n' /etc/samba/team.cred
通常应限制为挂载所需的管理用户或 root。修改权限前确认不会影响负责挂载的服务账号。不要为了排错把凭据文件内容、密码或完整认证错误日志公开到工单和论坛。
如果 DNS、路由或 TCP 445 测试失败,先处理网络层,不要急着卸载并重挂。检查顺序可以是:
网络恢复后,如果内核日志显示已经重连,并且以下只读访问在限定时间内成功,通常不需要重挂:
timeout 10 stat /srv/team
timeout 10 ls -ld /srv/team
如果网络恢复但业务进程仍持续报 I/O 错误,不要只根据目录能列出文件就判断完全恢复。已有文件句柄、锁、写入中的请求和应用缓存可能没有自动恢复,数据库、虚拟化存储或持续写入任务尤其需要检查业务日志。
如果 TCP 445 能建立,smbclient 返回登录失败或权限错误,优先检查:
sec= 认证方式是否符合服务端策略;vers= 协议方言是否被服务端允许;这类问题中,降低 sec= 安全级别或盲目改成旧版 SMB 协议可能带来安全风险,也可能掩盖真正的服务端配置问题。应先从服务端日志和现有安全策略确认支持范围。
如果只是凭据已经更新,修改凭据文件后通常需要重新建立会话才能验证新凭据。已有 CIFS 挂载不一定会立即读取文件中的新内容,不能仅修改文件后就认为当前会话已切换。
这种结果说明基础网络和一条新 SMB 会话大致可用,重点转向现有内核挂载:
findmnt 中实际使用的 vers、sec、hard、soft、timeo 和 echo_interval;重挂前先确认使用者:
sudo fuser -vm /srv/team
sudo lsof +f -- /srv/team
不要看到进程占用就直接 kill -9。先停止对应业务,确认写入已经落盘,并评估卸载对读写任务的影响。正常恢复流程可以是:
sudo umount /srv/team
sudo mount /srv/team
sudo findmnt -T /srv/team -o TARGET,SOURCE,FSTYPE,OPTIONS
umount 失败并提示 busy 时,不要立即使用懒卸载掩盖问题。umount -l 只是在当前命名空间分离挂载点,已有文件描述符仍可能继续阻塞或报错,适合作为经过评估后的最后手段,而不是常规重连命令。
如果修改了 /etc/fstab,先做备份并检查语法,再重新加载 systemd 配置:
sudo cp -a /etc/fstab /etc/fstab.bak.$(date +%Y%m%d-%H%M%S)
sudo findmnt --verify
sudo systemctl daemon-reload
findmnt --verify 主要检查 fstab 结构,不能验证远端账号和共享是否可用。配置有误时,使用刚才记录的具体备份文件恢复 /etc/fstab,再次执行 findmnt --verify 和 systemctl daemon-reload,再进行挂载测试。不要在未确认影响范围时直接执行 mount -a,因为它可能同时尝试挂载其他文件系统。
验证不能只看 mount 命令返回 0,还要确认参数和实际 I/O 都正常。
sudo findmnt -T /srv/team -o TARGET,SOURCE,FSTYPE,OPTIONS
sudo systemctl status "$(systemd-escape -p --suffix=mount /srv/team)" --no-pager
重点确认:
vers、sec 与预期一致;soft 或过短的 timeo;先执行不会修改数据的访问:
timeout 10 stat -f /srv/team
timeout 10 find /srv/team -maxdepth 1 -mindepth 1 -print
如果业务允许写测试,只能在明确的测试目录中创建唯一文件,并提前确认清理责任。不要在生产共享根目录随意写入或删除文件。测试应覆盖应用实际需要的读、写、改名和权限操作,而不是只验证目录列表。
在测试环境或已批准的维护窗口,可以观察一次受控的短暂网络故障;生产环境不要为了验证而直接关闭网卡、修改防火墙或中断路由。观察期间记录:
stat、业务读写请求的延迟;Input/output error、锁丢失或文件句柄失效;如果只在偶发故障发生后人工查看,容易漏掉短时间内恢复但业务已经失败的情况。可以持续监控挂载点访问延迟、应用 I/O 错误、CIFS server not responding 日志数量,以及 TCP 445 的连通性;ping 只能作为辅助指标,不能单独作为 CIFS 健康检查。
经过一次故障恢复后,还应保留一段观察期。若每次网络波动后都需要人工卸载重挂,应继续检查服务端会话超时策略、中间设备的连接清理行为、协议版本协商和应用对 I/O 错误的处理,而不是不断缩短 echo_interval 或增加挂载重试次数。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/6643.html