香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


乱码通常不是“Linux服务器上的MySQL没有设置成 utf8mb4”这么简单。数据从请求进入应用、经过驱动连接、写入MySQL,再从查询结果返回到终端或浏览器,中间至少经过客户端、连接会话、数据库对象和输出层。只看 character_set_server,无法判断乱码究竟在哪一步产生。
定位的关键是把“显示出来的字符”和“数据库实际保存的字节”分开检查:先用同一条测试数据比较应用与命令行结果,再查看连接会话变量,最后用 HEX()核对存储内容。只要确定某一层的字节已经发生变化,后续排查范围就可以明显缩小。
不要一看到问号、方框或类似“ä¸æ–‡”的字符,就直接执行字符集转换。先记录以下信息:
这些现象对应的排查方向并不相同。
| 观察到的现象 | 优先怀疑层级 | 下一步检查 |
|---|---|---|
| 只有Linux命令行显示异常,网页和应用正常 | 系统Locale、终端、MySQL客户端 | 检查 locale,使用显式客户端字符集连接 |
| 直接查询显示正常,浏览器页面乱码 | 应用输出、HTTP响应或模板 | 检查响应头、页面编码和应用序列化配置 |
| 数据库中旧数据异常,新数据正常 | 历史数据或旧写入链路 | 对同一字段执行 HEX(),比较写入时间 |
所有客户端查询都异常,且 HEX()中的字节不符合预期 | 写入链路、字段字符集或历史转换 | 检查连接变量、字段定义和写入代码 |
| 只有emoji等四字节字符变成问号 | utf8mb3字段或连接配置 | 检查字段是否为 utf8mb4,确认连接字符集 |
| 字符显示正常,但排序或比较结果不符合预期 | Collation排序规则 | 检查列级和连接级 collation |
| 同一应用偶尔正常、偶尔乱码 | 连接池、代理或后端实例不一致 | 核对连接目标、连接初始化SQL和后端节点 |
这里要区分字符集和排序规则。character set决定字符如何编码,collation主要决定比较、排序和大小写规则。不同排序规则通常导致排序结果不同或出现“Illegal mix of collations”错误,不一定会直接造成显示乱码。
可以把问题按数据链路分成五个分支:
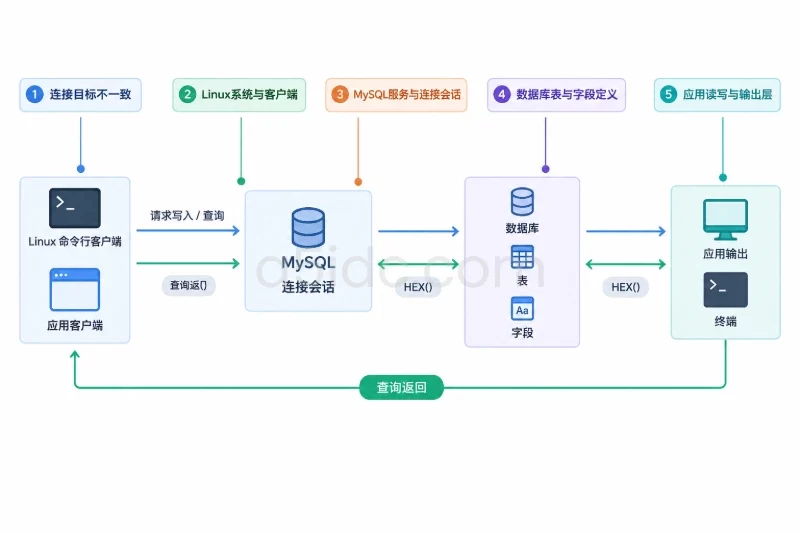
character_set_client、character_set_connection 或 character_set_results不正确。utf8mb4,但历史表或某个字段仍是 latin1、utf8(MySQL中的 utf8mb3)或其他字符集。网络传输本身通常不理解中文,也不会主动把UTF-8改成Latin-1。通过代理或负载均衡时,重点不是先抓包,而是确认应用最终连接到了哪台MySQL,以及每条连接建立后执行了什么初始化语句。
同一条SQL在不同MySQL实例上得到不同结果,是排查中很容易被忽略的情况。Linux命令行可能连接本机Socket,而应用连接的是内网地址、代理地址或只读实例。
在应用使用的同一连接路径上执行:
SELECT
    @@hostname AS mysql_host,
    @@port AS mysql_port,
    DATABASE() AS current_database,
    CONNECTION_ID() AS connection_id,
    @@version AS mysql_version;
再使用命令行连接进行同样检查:
mysql --default-character-set=utf8mb4 -h db.example.internal -u app_user -p appdb
进入后执行:
SELECT
    @@hostname AS mysql_host,
    @@port AS mysql_port,
    DATABASE() AS current_database,
    CONNECTION_ID() AS connection_id,
    @@version AS mysql_version;
这里的主机名、版本和当前数据库至少应能解释两条链路是否指向同一环境。若应用经过代理,不能只检查代理服务器上的MySQL配置文件,应以应用连接建立后的查询结果为准。
如果发现命令行连接的是主库,而应用查询的是读副本,应分别检查:
不要因为命令行结果正常,就认定应用侧数据一定正常。每个连接目标都要单独取得 HEX()和字符集变量结果。
Linux的Locale主要影响终端程序如何解释和显示文本,不等于MySQL数据库的字符集。先查看当前Shell环境:
locale
printf 'LANG=%s\nLC_ALL=%s\n' "$LANG" "$LC_ALL"
如果显示的是 C、POSIX 或者与实际终端不匹配的Locale,可能出现命令行输出异常。但这只能解释“终端看到的字符不对”,不能证明数据库中保存的字节已经损坏。
连接时显式指定MySQL客户端字符集,避免客户端配置文件或发行版默认值干扰:
mysql --default-character-set=utf8mb4 -h 127.0.0.1 -u app_user -p appdb
在连接中执行一个不依赖业务表的探针测试:
CREATE TEMPORARY TABLE charset_probe (
    value_text VARCHAR(32) CHARACTER SET utf8mb4
);

INSERT INTO charset_probe (value_text)
VALUES ('A中𠮷');

SELECT
    value_text,
    HEX(value_text) AS value_hex,
    CHAR_LENGTH(value_text) AS character_count,
    LENGTH(value_text) AS byte_count
FROM charset_probe;
这个示例中,A中𠮷按UTF-8编码通常对应:
CHAR_LENGTH()为3;LENGTH()为8;HEX()应接近 41E4B8ADEDA0B7。其中,𠮷用于测试四字节字符。不同终端的字体可能无法正常显示它,但这不影响 HEX()判断。
如果命令行中 value_text看起来乱码,而 value_hex和长度符合预期,优先检查终端、字体或客户端输出;如果 value_hex已经不符合预期,则继续检查连接会话和字段定义。
MySQL有多个与字符集相关的变量,不能只查看一个 character_set_server。建议一次性取得服务端和当前会话信息:
SELECT
    @@character_set_client AS character_set_client,
    @@character_set_connection AS character_set_connection,
    @@character_set_results AS character_set_results,
    @@character_set_server AS character_set_server,
    @@character_set_database AS character_set_database,
    @@collation_connection AS collation_connection,
    @@collation_server AS collation_server;
也可以查看完整变量列表:
SHOW SESSION VARIABLES LIKE 'character_set%';
SHOW SESSION VARIABLES LIKE 'collation%';
检查全局默认值时使用:
SHOW GLOBAL VARIABLES LIKE 'character_set%';
SHOW GLOBAL VARIABLES LIKE 'collation%';
几个变量的含义如下:
character_set_client:服务器按什么字符集解释客户端发送来的语句和参数;character_set_connection:服务器内部处理字符串表达式时使用的连接字符集;character_set_results:服务器向客户端返回结果时采用的字符集;character_set_server:MySQL服务的默认字符集,主要影响未明确指定字符集的新对象;character_set_database:当前数据库的默认字符集;collation_connection:当前连接使用的比较和排序规则。例如,模拟结果如下:
character_set_client       latin1
character_set_connection   latin1
character_set_results      latin1
character_set_server       utf8mb4
character_set_database     utf8mb4
这说明服务默认值看似正确,但当前连接仍以 latin1处理数据。应用写入中文时,可能在进入字段前就发生错误转换;查询结果也可能在返回客户端时被再次转换。
在测试连接中可以临时执行:
SET NAMES utf8mb4;
它会调整当前会话的客户端、连接和结果字符集,用于验证问题是否来自连接初始化。验证完成后应优先在驱动或连接池配置中修复,而不是在每个业务SQL前拼接 SET NAMES。连接池可能复用旧会话,也可能在归还连接时重置部分变量,因此要在“新建连接”和“复用连接”两种情况下分别验证。
需要注意,全局变量和已有会话不是同一范围。即使管理员修改了全局默认值,已经建立的连接通常仍保留原有会话变量。应用连接池不重建,问题可能继续存在。
服务默认字符集并不会自动把所有历史表和字段转换为 utf8mb4。例如,数据库默认值已经改成 utf8mb4,但已有表的列仍可能是 latin1或MySQL旧版 utf8mb3。
先检查数据库默认值:
SELECT
    SCHEMA_NAME,
    DEFAULT_CHARACTER_SET_NAME,
    DEFAULT_COLLATION_NAME
FROM information_schema.SCHEMATA
WHERE SCHEMA_NAME = 'appdb';
再检查表级默认值:
SELECT
    TABLE_SCHEMA,
    TABLE_NAME,
    TABLE_COLLATION
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'appdb'
  AND TABLE_TYPE = 'BASE TABLE';
最后检查具体字段:
SELECT
    TABLE_SCHEMA,
    TABLE_NAME,
    COLUMN_NAME,
    COLUMN_TYPE,
    CHARACTER_SET_NAME,
    COLLATION_NAME
FROM information_schema.COLUMNS
WHERE TABLE_SCHEMA = 'appdb'
  AND TABLE_NAME = 'customer_profile'
  AND COLUMN_NAME IN ('nickname', 'remark');
或者查看完整表定义:
SHOW CREATE TABLE appdb.customer_profile;
判断时要以字段级结果为准:
VARCHAR、CHAR、TEXT等字符字段应检查 CHARACTER_SET_NAME;BINARY、VARBINARY、BLOB等二进制字段没有普通字符集,不能把它们按文本字段处理;如果确认字段定义不符合要求,常见转换语句如下:
ALTER TABLE appdb.customer_profile
    CONVERT TO CHARACTER SET utf8mb4
    COLLATE utf8mb4_unicode_ci;
这不是低风险的即时修复。执行前至少要完成备份或可恢复快照,确认表大小、锁等待、业务低峰和磁盘空间,并先在测试环境验证。不同MySQL版本和存储引擎可能触发表重建或较长时间的元数据锁,期间会影响写入,甚至影响读取。
MySQL 8.0常见的排序规则可以使用 utf8mb4_0900_ai_ci;MySQL 5.7环境通常使用 utf8mb4_unicode_ci等兼容排序规则。不能把8.0专用排序规则直接写入5.7配置或DDL,执行前先确认版本:
SELECT VERSION();
如果转换结果不符合预期,回滚优先使用变更前的备份或快照。不要简单执行反向 ALTER TABLE,因为已经被替换成问号、错误字节或错误字符的数据,反向转换无法自动恢复原文。
显示结果只能说明某个组件最终呈现了什么,不能证明数据库保存了什么。对异常记录和一条已知正常记录同时查询:
SELECT
    id,
    nickname,
    HEX(nickname) AS nickname_hex,
    LENGTH(nickname) AS byte_length,
    CHAR_LENGTH(nickname) AS character_length
FROM appdb.customer_profile
WHERE id IN (1001, 1002);
判断逻辑可以按以下方式进行:
HEX()符合原始文本的UTF-8字节,但应用界面乱码:问题在驱动解码、日志、HTTP响应或前端渲染;HEX()在命令行和应用查询中都不符合原始文本:问题已经发生在写入、字段转换或历史数据处理环节;3F,通常表示已经被替换成问号,但原始字符无法仅凭当前值恢复;HEX()相同而排序、模糊匹配不同:重点转向 collation和查询表达式。例如,测试字符 A中𠮷的UTF-8字节应当包含:
41 E4 B8 AD ED A0 B7
如果库中查询得到的内容已经是另一组字节,就不能再把问题归因于浏览器显示。此时要回溯写入时的连接变量、驱动设置、接口请求编码和数据迁移脚本。
对历史错误数据的修复应先建立样本和转换规则,确认错误模式具有一致性,再在副本或测试表中验证。对于已经发生多次错误转码的数据,不能通过统一执行 CONVERT()保证恢复,必要时需要从原始导入文件、业务日志或备份重新生成。
当数据库直接查询的 HEX()正确,而业务页面仍然乱码,问题通常已经离开MySQL存储层。建议沿着应用链路继续检查。
确认应用使用的驱动连接参数是否明确指定了 utf8mb4,并检查连接池是否有初始化SQL。常见问题包括:
SET NAMES latin1;不要只在应用启动时打印一次字符集变量。应在连接创建、连接从池中取出以及出现异常时分别记录以下非敏感信息:
SELECT
    CONNECTION_ID(),
    @@hostname,
    DATABASE(),
    @@character_set_client,
    @@character_set_connection,
    @@character_set_results,
    @@collation_connection;
密码、完整用户输入和业务敏感字段不应直接写入日志。若需要比对数据,可在测试环境记录受控字符串的十六进制表示。
如果应用从MySQL取出的字符串正确,但浏览器显示异常,检查:
Content-Type;可以先用命令行查看响应头,而不是只看浏览器页面:
curl -sS -D - https://app.example.com/test/charset -o /tmp/charset-response.txt
响应体是JSON时,应用通常应以UTF-8输出,并保持接口、网关和前端约定一致。若响应头和响应体都正确,而浏览器仍异常,再检查页面模板和前端解码流程。
如果确认问题来自服务默认值,再检查MySQL实际加载的配置文件。不同Linux发行版的路径和服务名称可能不同,不能直接假定一定是 /etc/my.cnf或一定使用 mysqld服务名。
可以先确认服务和进程:
systemctl list-unit-files | grep -E '^(mysql|mysqld)\.service'
ps -ef | grep '[m]ysqld'
检查配置文件中的相关项:
sudo grep -RniE 'character-set|collation' \
    /etc/my.cnf /etc/mysql /etc/mysql/mysql.conf.d 2>/dev/null
配置文件只是“声明”,当前服务真正使用的值仍应通过SQL确认。一个版本相关的参考配置如下:
[mysqld]
character-set-server=utf8mb4

# MySQL 8.0示例
collation-server=utf8mb4_0900_ai_ci

# MySQL 5.7可考虑使用:
# collation-server=utf8mb4_unicode_ci

[client]
default-character-set=utf8mb4
[client]段主要影响读取该配置文件的MySQL客户端程序,不一定影响Java、PHP、Go或其他语言驱动。应用驱动仍需单独配置。
修改服务配置前应备份原文件,记录修改内容,并安排维护窗口。重启MySQL会断开现有连接,连接池和正在执行的事务都会受到影响。配置不兼容时,应先恢复备份文件,再按原服务管理方式启动;不要在没有确认版本和配置加载顺序时连续修改多个参数。
character_set_server=utf8mb4只说明服务默认值已经变化,不代表当前应用连接、已有表和已有字段都已变化。应分别检查会话变量和 information_schema.COLUMNS。
ALTER TABLE ... DEFAULT CHARACTER SET主要影响后续新增字段。原有字段仍可能保留旧字符集。需要单独查看字段定义,不能只看SHOW CREATE TABLE中靠后的默认值。
如果只在管理工具中执行了 SET NAMES utf8mb4,它只改变当前连接。应用、迁移脚本和定时任务仍可能使用旧配置。应修复驱动或连接池的统一初始化逻辑。
终端、日志查看器和浏览器都可能重新解释字节。对照 HEX(),并用英文标识、中文和四字节字符组成受控测试数据,才能判断错误发生在存储前还是存储后。
如果字符显示正确,只是ORDER BY、大小写比较或唯一索引行为不同,应检查列级排序规则、连接排序规则和表达式隐式转换,不要直接转换整张表。
修复后不要只打开一个页面确认。建议按以下顺序验证:
character_set_client、character_set_connection和character_set_results符合预期。A中𠮷,再用数据库查询其原始HEX()。Incorrect string value、Data truncated或字符集混用相关警告。验证数据写入时可以使用专用测试表或测试租户,避免把探针字符串写进真实业务记录。若必须在生产环境验证,应提前确认清理方式、权限范围和回滚步骤,不能直接对核心表执行未知转换。
字符集问题适合做成持续检查,而不是等业务人员再次发现乱码后处理。
Incorrect string value、数据截断和排序规则混用错误进行日志统计;HEX()、LENGTH()和CHAR_LENGTH(),不要只凭页面显示判断成功。当服务默认值、连接会话、字段定义和应用输出都能通过同一组受控字符验证时,才算真正完成恢复。这样即使后续更换Linux发行版、MySQL版本、驱动或连接池,也能迅速判断乱码是在连接、存储还是展示阶段重新出现。
围绕Linux与MySQL业务的稳定运行,A5数据提供中国香港、美国、日本、韩国、中国台湾、新加坡及马来西亚等地区的物理服务器资源,覆盖Xeon、AMD EPYC平台以及SSD、NVMe和大内存配置,可承载数据库、业务后台与接口服务。多地区线路、带宽和存储方案,也为不同访问区域的数据服务部署提供基础资源支持。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5685.html