香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


在日本GPU服务器上部署ComfyUI,需要先打通三层环境:操作系统能够识别GPU,PyTorch能够调用GPU,ComfyUI能够加载模型并完成一次生成。对于常见的NVIDIA Ampere、Ada架构显卡,可以采用Ubuntu 24.04 LTS、Python 3.12、独立虚拟环境和匹配的CUDA版PyTorch;显存则按工作流选择,不能只看模型文件大小。
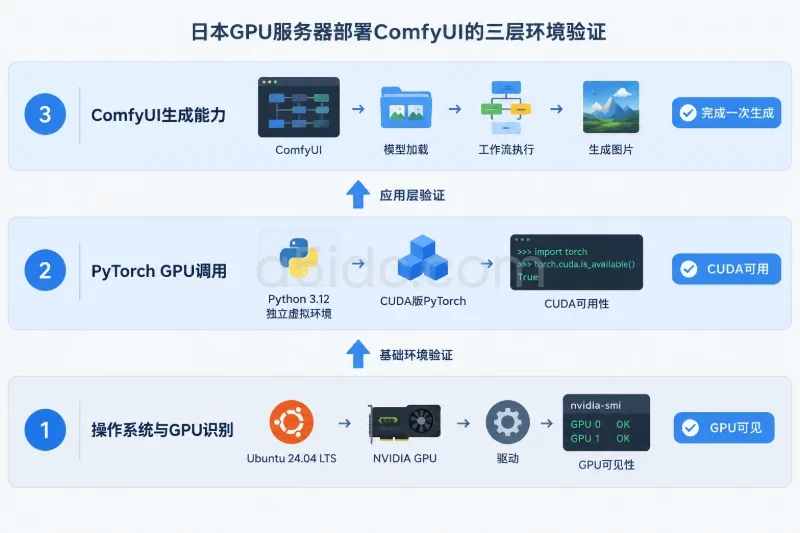
本文以单机、单GPU部署为例,目标是让ComfyUI以普通服务账号运行,通过带HTTPS和身份验证的Nginx入口访问,并具备重启恢复、基础排障和回滚能力。服务器位于日本不会改变驱动安装方法,但机房到使用者的网络质量、模型下载来源和存储条件,会影响部署与交互体验。文中命令适用于新装或已完成备份的Ubuntu服务器,示例输出仅用于判断状态。
围绕 ComfyUI 等图像生成场景,A5数据提供日本物理服务器资源,覆盖 Xeon Gold、AMD EPYC、NVMe 存储及多种线路,可承载服务环境、模型文件与生成结果;同时提供香港、美国 GPU 服务器,配置 A100 80GB 或 RTX 4090,为 AI 推理、模型测试和图像处理提供算力基础,并支持结合业务访问地区进行部署规划。
本教程采用以下环境组合:
| 项目 | 本文采用的条件 | 部署前核对方式 |
|---|---|---|
| 操作系统 | Ubuntu 24.04 LTS,x86_64 | 查看发行版和系统架构 |
| GPU | NVIDIA Ampere、Ada架构单卡 | 核对实际型号与GPU分配方式 |
| Python | 系统Python 3.12,配合venv | 执行python3 --version |
| PyTorch | 2.7.1,CUDA 12.6构建 | 安装后检查版本与CUDA可用性 |
| ComfyUI | 官方仓库,记录实际提交编号 | 保存Git提交和依赖清单 |
| 访问方式 | 本机8188端口,Nginx提供HTTPS入口 | 核对监听地址、证书和访问控制 |
| 运行方式 | systemd管理,非root账号 | 检查服务状态与日志 |
这里的PyTorch版本是一个明确的部署参考组合,不代表所有GPU和ComfyUI版本都应固定使用它。更老的显卡、新架构显卡以及依赖较新的自定义节点,需要重新核对PyTorch构建、驱动和算力架构支持。
GPU直通服务器、独占GPU实例和共享显存实例也不能混为一谈。购买或开通日本GPU服务器时,应确认操作系统内可见的显存、是否允许安装驱动、是否支持重启,以及GPU是否有其他租户或任务共享。
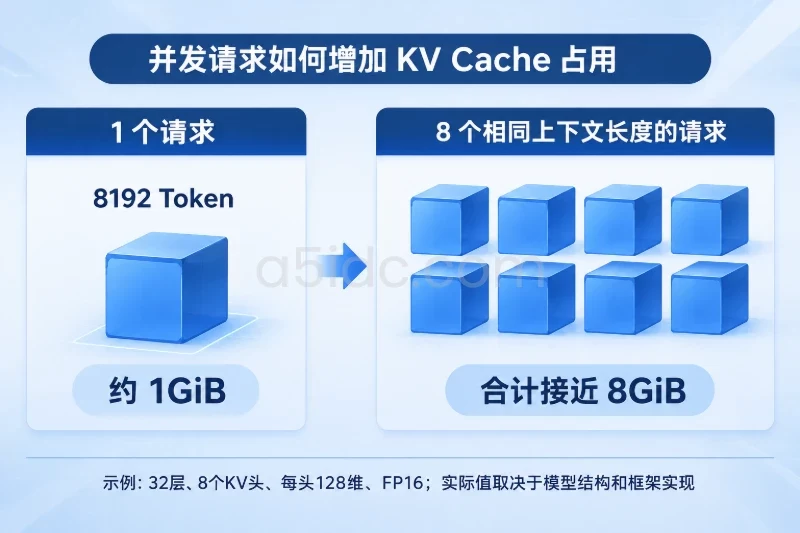
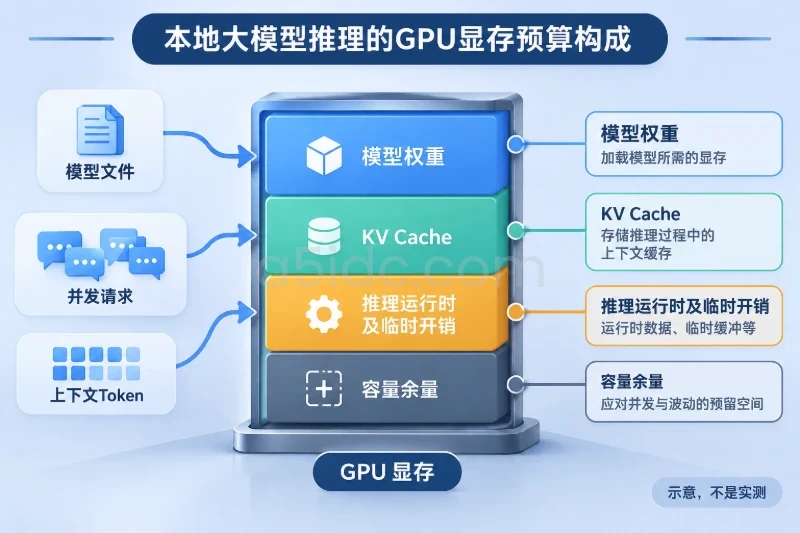
运行时显存通常包括模型权重、中间张量、注意力计算、VAE解码和其他节点占用。磁盘上的模型为6GB,并不意味着6GB显存就能运行相应工作流。
以下为单任务部署的容量参考:
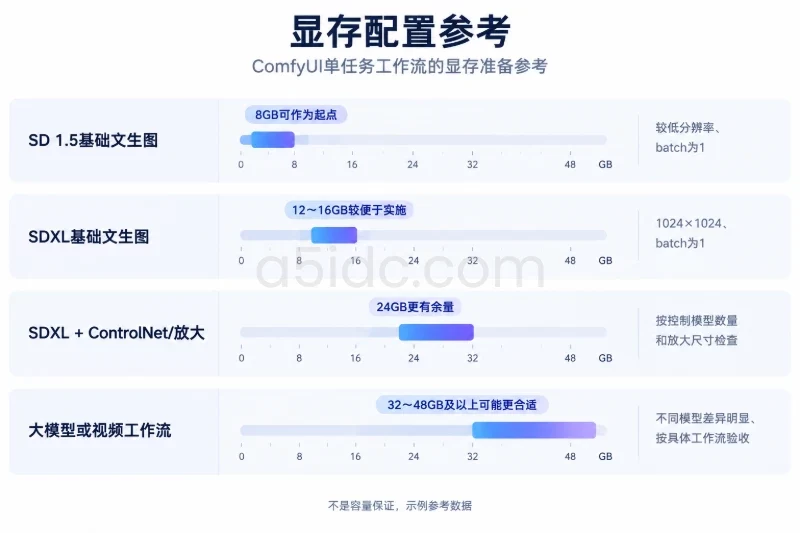
| 工作流类型 | 显存准备参考 | 适用边界 |
|---|---|---|
| SD 1.5基础文生图 | 8GB可作为起点 | 较低分辨率、batch为1,不叠加大量附加模型 |
| SDXL基础文生图 | 12~16GB较便于实施 | 从1024×1024、batch为1开始验证 |
| SDXL叠加ControlNet、放大等节点 | 24GB更有余量 | 仍需按控制模型数量和放大尺寸检查峰值 |
| 大模型或视频工作流 | 32~48GB及以上可能更合适 | 不同模型差异明显,应按具体工作流验收 |
这些是配置参考,不是容量保证。低显存模式能够通过卸载部分模型降低显存压力,但会增加内存、数据搬运和等待时间。
系统内存建议从32GB起步,较大模型或频繁卸载场景可考虑64GB及以上。系统盘与模型盘合计可先预留100~200GB可用空间;使用多个模型或视频输出时,需要额外规划容量。系统内存、磁盘空间和swap都不能直接代替GPU显存。
GPU推理耗时与网络传输耗时应分开观察。页面打开快,不等于生成快;生成完成后图片下载慢,也不一定是GPU性能不足。
开始前,对已有服务器创建快照,并保存当前驱动版本、服务配置和业务数据。驱动安装、系统重启可能影响同机其他GPU任务,不能直接在正在提供服务的节点上执行。
使用具备sudo权限的管理账号执行:
cat /etc/os-release
uname -m
python3 --version
lspci | grep -i nvidia
nvidia-smi
df -h / /srv
free -h
预期系统架构为x86_64。lspci能看到NVIDIA设备,说明操作系统识别到了PCI设备;nvidia-smi正常输出,才说明驱动已经能够与GPU通信。
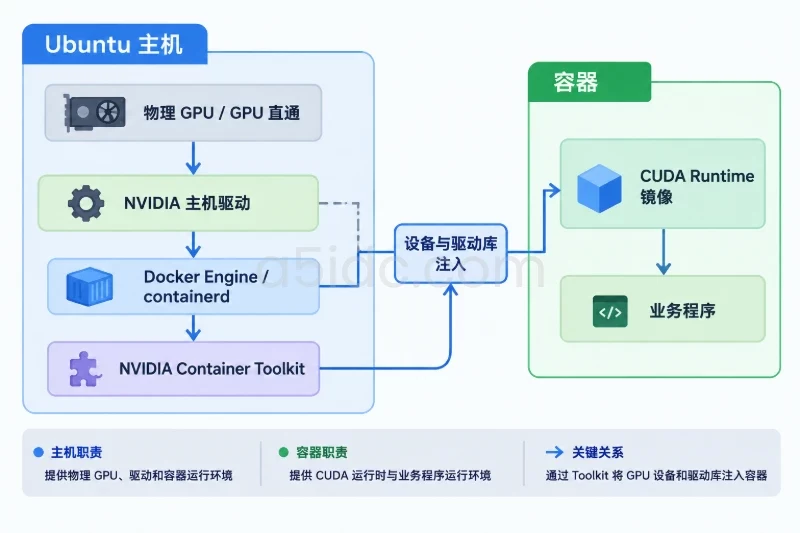
若是容器环境,宿主机需要先完成驱动配置,并将GPU设备正确提供给容器。本文后续步骤针对直接管理Ubuntu操作系统的部署,不应在普通业务容器内照搬驱动安装命令。
已有可用驱动时,不要仅为了重新部署ComfyUI就覆盖安装。先检查版本与目标PyTorch构建的兼容性。
本文CUDA 12.6参考组合,可将Linux驱动560.28.03或更高版本作为保守的部署起点。它不是所有CUDA 12.x运行场景的统一最低版本;实际要求还受显卡型号、CUDA兼容机制和软件功能影响。
新装Ubuntu服务器可先查询发行版推荐驱动:
sudo apt update
sudo apt install -y ubuntu-drivers-common pciutils
ubuntu-drivers devices
确认推荐项适配实际GPU,并能满足所选运行环境后,再执行:
sudo ubuntu-drivers autoinstall
sudo reboot
这一步会改变系统级驱动并中断服务器连接。执行前必须具备快照、维护窗口和控制台访问能力;如果推荐版本不符合目标组合,应先解决软件源与驱动支持问题,不要混装发行版包和独立安装器。
重启后检查:
nvidia-smi
lsmod | grep nvidia
需要关注GPU名称、驱动版本、可用显存和进程列表。nvidia-smi顶部显示的“CUDA Version”代表驱动支持的CUDA版本上限,不表示系统已经安装了同版本CUDA Toolkit。
常规ComfyUI部署通常只需要NVIDIA驱动和CUDA版PyTorch,不必额外安装完整CUDA Toolkit。 只有编译特定CUDA扩展、自定义节点或其他源码组件时,才需要进一步核对Toolkit和编译器。
下列命令假定comfy账号和/srv/comfy目录尚不存在。已有部署应使用新目录,避免覆盖原环境。
sudo apt install -y \
  git python3-venv python3-dev build-essential \
  libgl1 libglib2.0-0 ca-certificates

sudo useradd --system --create-home \
  --home-dir /srv/comfy \
  --shell /usr/sbin/nologin comfy

sudo -u comfy python3 -m venv /srv/comfy/venv

sudo -u comfy /srv/comfy/venv/bin/python \
  -m pip install --upgrade pip setuptools wheel
服务账号不开放交互登录,也不获得sudo权限。后续代码、模型和输出归该账号管理,避免使用root直接启动ComfyUI。
这里安装编译工具是为了处理可能需要构建的Python依赖,并不意味着所有自定义节点都能自动完成安装。
sudo -u comfy git clone \
  https://github.com/comfyanonymous/ComfyUI.git \
  /srv/comfy/ComfyUI

sudo -u comfy sh -c \
  'git -C /srv/comfy/ComfyUI rev-parse HEAD > /srv/comfy/comfyui-commit.txt'
首次拉取的是仓库当时的默认分支。正式上线前,应在这一提交上完成验证并冻结版本,不要将自动拉取最新代码作为服务启动步骤。
本文参考组合的安装命令为:
sudo -u comfy /srv/comfy/venv/bin/python -m pip install \
  torch==2.7.1 torchvision==0.22.1 torchaudio==2.7.1 \
  --index-url https://download.pytorch.org/whl/cu126
建立约束文件,防止后续依赖安装悄悄改变这组版本:
sudo -u comfy tee /srv/comfy/constraints.txt > /dev/null <<'EOF'
torch==2.7.1
torchvision==0.22.1
torchaudio==2.7.1
EOF

sudo -u comfy /srv/comfy/venv/bin/python -m pip install \
  -r /srv/comfy/ComfyUI/requirements.txt \
  -c /srv/comfy/constraints.txt
如果出现依赖冲突,应停下来核对该ComfyUI提交的要求。可以更换为经过验证的ComfyUI提交,也可以整体调整PyTorch组合,但不要忽略冲突继续上线。
基础环境阶段不安装额外的自定义节点。先验证内置工作流,再逐个增加扩展,能显著缩小故障范围。
sudo -u comfy /srv/comfy/venv/bin/python - <<'PY'
import torch

print("PyTorch:", torch.__version__)
print("CUDA build:", torch.version.cuda)
print("CUDA available:", torch.cuda.is_available())

if not torch.cuda.is_available():
    raise SystemExit("GPU不可用,请先检查驱动与PyTorch安装")

print("GPU:", torch.cuda.get_device_name(0))
print("VRAM GiB:",
      round(torch.cuda.get_device_properties(0).total_memory / 1024**3, 2))

x = torch.zeros((1024, 1024), device="cuda")
print("GPU calculation:", x.sum().item())
PY
成功状态应包含CUDA available: True、正确的显卡名称,以及GPU calculation: 0.0。这不仅检查版本,还实际申请了GPU张量并执行运算。
代码中的显存按GiB计算,即除以1024³,与部分产品页面使用的十进制GB可能存在显示差异。
再检查依赖并保存清单:
sudo -u comfy /srv/comfy/venv/bin/python -m pip check

sudo -u comfy sh -c \
  '/srv/comfy/venv/bin/python -m pip freeze > /srv/comfy/requirements-baseline.txt'
pip check通过不代表所有节点都已验证,但如果这里已经出现依赖缺失或版本冲突,就不应继续开放访问。
从有授权、可信的来源取得模型,核对许可和发布方提供的哈希。基础部署优先使用适配内置节点的SafeTensors模型;扩展代码、未知脚本和不明序列化文件均应审查后使用。
例如,一个适用于基础SDXL工作流的checkpoint应放入:
/srv/comfy/ComfyUI/models/checkpoints/
如果模型已上传到/tmp/sdxl-base.safetensors,可使用以下命令复制。先检查目标不存在,避免覆盖已有模型:
sudo test ! -e \
  /srv/comfy/ComfyUI/models/checkpoints/sdxl-base.safetensors && \
sudo install -o comfy -g comfy -m 0640 \
  /tmp/sdxl-base.safetensors \
  /srv/comfy/ComfyUI/models/checkpoints/sdxl-base.safetensors
不同类型模型应放入各自目录,例如VAE放入models/vae、LoRA放入models/loras。不能把所有文件都放进checkpoints目录。
启动前台进程:
sudo -u comfy /srv/comfy/venv/bin/python \
  /srv/comfy/ComfyUI/main.py \
  --listen 127.0.0.1 --port 8188
在另一个SSH会话中验证:
curl -fsS http://127.0.0.1:8188/system_stats \
  | python3 -m json.tool

ss -lntp | grep ':8188'
预期接口返回JSON,监听地址为127.0.0.1:8188。此时外部不能直接访问8188是正常现象,不应为了打开页面就将端口暴露到公网。
先在前台终端按Ctrl+C结束测试进程,确认8188端口释放。以下配置适用于尚未存在同名服务的新部署;已有文件应先备份。
sudo tee /etc/systemd/system/comfyui.service > /dev/null <<'EOF'
[Unit]
Description=ComfyUI GPU Service
After=network-online.target
Wants=network-online.target

[Service]
Type=simple
User=comfy
Group=comfy
WorkingDirectory=/srv/comfy/ComfyUI
Environment=PYTHONUNBUFFERED=1
ExecStart=/srv/comfy/venv/bin/python /srv/comfy/ComfyUI/main.py --listen 127.0.0.1 --port 8188
Restart=on-failure
RestartSec=5
UMask=0027
NoNewPrivileges=true
PrivateTmp=true
ProtectSystem=full

[Install]
WantedBy=multi-user.target
EOF

sudo systemctl daemon-reload
sudo systemctl enable --now comfyui
sudo systemctl status comfyui --no-pager
验证服务日志:
sudo journalctl -u comfyui -n 100 --no-pager
curl -fsS http://127.0.0.1:8188/system_stats
预期服务状态为active (running)。若反复重启,先查看第一条异常,不要只提高重启频率。
以下示例要求域名已解析到服务器,且已有有效证书。comfy.example.com和证书路径必须替换为实际值,证书续期也要纳入运维。
sudo apt install -y nginx apache2-utils

sudo test ! -e /etc/nginx/comfy.htpasswd && \
sudo htpasswd -c /etc/nginx/comfy.htpasswd comfyadmin

sudo chown root:www-data /etc/nginx/comfy.htpasswd
sudo chmod 0640 /etc/nginx/comfy.htpasswd
htpasswd会交互式要求输入密码,避免把密码写进命令历史。-c会创建或覆盖文件,因此这里先检查文件不存在;已有密码文件添加用户时不要使用-c。
确认/etc/nginx/conf.d/comfyui.conf没有同名配置后,再创建:
server {
    listen 443 ssl;
    server_name comfy.example.com;

    ssl_certificate     /etc/ssl/comfy/fullchain.pem;
    ssl_certificate_key /etc/ssl/comfy/privkey.pem;
    ssl_protocols TLSv1.2 TLSv1.3;

    auth_basic "ComfyUI";
    auth_basic_user_file /etc/nginx/comfy.htpasswd;

    client_max_body_size 100m;

    location / {
        proxy_pass http://127.0.0.1:8188;
        proxy_http_version 1.1;

        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;

        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";

        proxy_read_timeout 600s;
        proxy_send_timeout 600s;
        proxy_buffering off;
    }
}
该配置支持页面使用的WebSocket连接。超时时间和上传大小是示例,应按实际工作流调整,不是生成耗时承诺。
应用前验证:
sudo nginx -t
sudo systemctl reload nginx
只有配置检查通过才重载。服务器已有其他网站时,应检查完整Nginx配置,避免域名、端口和证书配置冲突。
安全组或主机防火墙仅开放必要入口:SSH限制为管理来源,HTTPS限制为允许访问的来源,8188保持不对公网开放。防火墙变更前保存规则并保留控制台通道,避免锁定管理访问。
ComfyUI不应被直接视为多租户隔离平台。身份验证只能控制入口,不能隔离不同用户的数据、节点代码和GPU资源。多用户生产场景应进一步设计任务队列、账号隔离与资源限额。
通过HTTPS打开页面,加载由内置节点组成的基础文生图工作流。SDXL可从1024×1024、batch为1开始,使用checkpoint加载、文本编码、采样、VAE解码和图像保存节点。
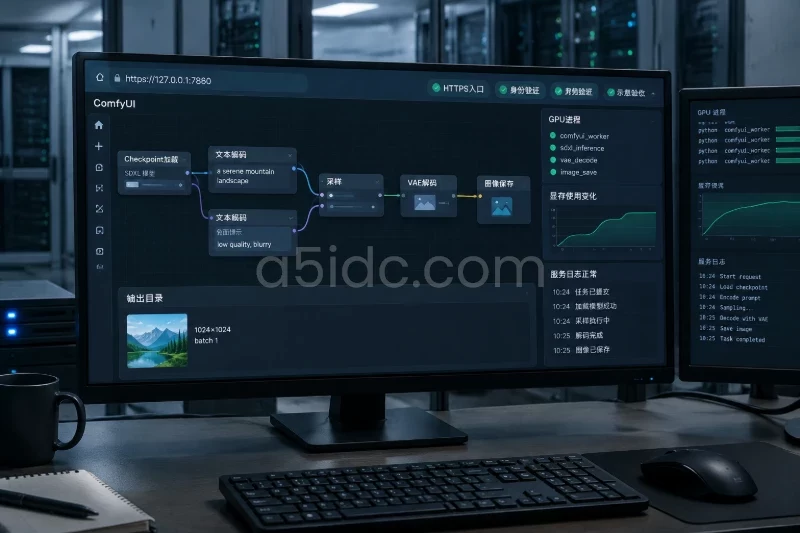
验收时观察:
可在另一终端运行watch -n 1 nvidia-smi辅助观察,但短任务可能发生在采样间隔之间。不要仅凭某一秒的GPU利用率为0就判定没有使用GPU。
先判断故障位于外部入口还是应用内部:
sudo systemctl status comfyui nginx --no-pager
curl -fsS http://127.0.0.1:8188/system_stats
sudo nginx -t
sudo journalctl -u comfyui -n 100 --no-pager
本地接口正常而外部访问失败,应检查DNS、证书、443端口、安全组和Nginx日志;本地接口失败,则检查ComfyUI启动异常和端口占用。
未经认证访问返回401符合预期。通过认证后返回502通常表示Nginx无法访问后端;页面能打开但任务状态不更新,应继续检查WebSocket连接,而不是立即更换GPU。
nvidia-smi失败或PyTorch无法使用CUDA按以下顺序排查:
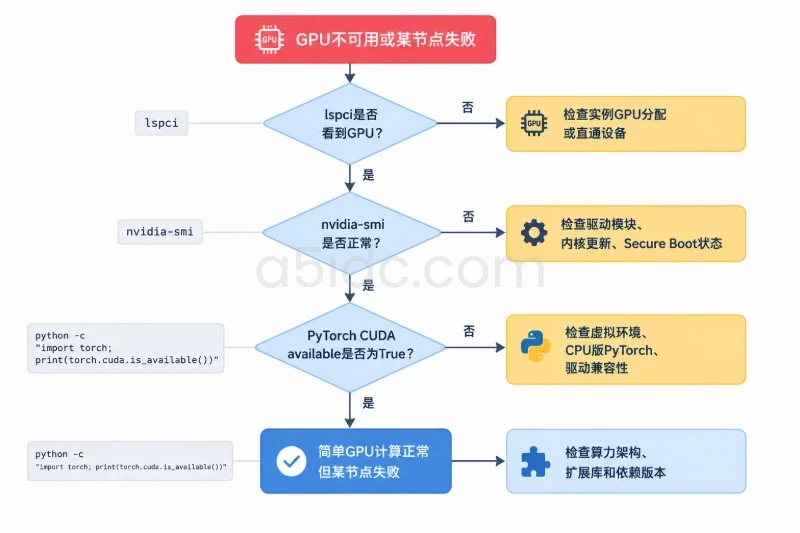
lspci没有GPU:检查实例是否正确分配GPU或直通设备。lspci有GPU,nvidia-smi失败:检查驱动模块、内核更新和Secure Boot状态。nvidia-smi正常,PyTorch返回False:核对是否使用了虚拟环境、是否安装CPU版PyTorch,以及驱动是否兼容。可补充检查:
uname -r
dkms status
mokutil --sb-state
/srv/comfy/venv/bin/python -m pip show torch
sudo journalctl -k -b | grep -Ei 'nvidia|nouveau|secure'
若mokutil命令不存在,可按需要安装相应软件包。Secure Boot相关问题应按发行版流程处理模块签名,不要把关闭安全机制当作默认修复方法。
先执行nvidia-smi检查是否有其他任务占用显存,再降低batch、分辨率和附加模型数量。大尺寸VAE解码可考虑工作流中的分块解码节点。
确有需要时,可在systemd启动参数中加入--lowvram;添加前先核对当前代码支持的参数:
sudo -u comfy /srv/comfy/venv/bin/python \
  /srv/comfy/ComfyUI/main.py --help
修改服务文件前备份,修改后执行daemon-reload并重启。重启会中断正在生成的任务,应先停止接收新任务。
低显存模式不能让所有工作流都适配小显存。若基础任务已经接近显存上限,就不适合直接叠加多个控制模型或并发任务。
自定义节点本质上是运行在服务器上的代码,可能安装依赖、读取文件或访问网络。不要只因某工作流提示缺少节点,就批量安装未知扩展。
排障时先备份节点目录、依赖清单和日志,将新节点移到ComfyUI扫描目录之外,再重启验证。禁用节点不能撤销它已经修改的Python依赖;如果基础环境仍异常,应切回原虚拟环境或用保存的版本基线重新构建。
上线验收不能止于“页面能打开”,至少应覆盖以下项目:
nvidia-smi正常,未发现驱动与内核不匹配。pip check没有依赖冲突。升级前保留旧代码、旧虚拟环境和原服务配置,在新目录中构建并验证新环境,再切换systemd路径。不要直接在唯一可用的虚拟环境中执行无约束升级。
需要回滚时,先停止任务入口并等待或取消在途任务,再停止服务:
sudo systemctl stop comfyui
随后恢复原服务文件及其对应的代码、虚拟环境路径,执行:
sudo systemctl daemon-reload
sudo systemctl start comfyui
sudo systemctl status comfyui --no-pager
回滚后的检查项包括:
应用回滚与驱动回滚是两个层次。恢复Python环境不能修复内核驱动问题;恢复系统快照也可能回退业务数据。日本GPU服务器投入使用前,应分别验证这两条恢复路径,并将模型与生成结果备份到不会随系统回滚丢失的位置。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/3870.html