香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


查询业务主表及一对多明细时,分页应先确定本页有哪些主表记录,再按这些主键查询关联数据。不要直接对主表和明细表的 JOIN 结果执行 LIMIT:一条主表记录可能被展开成多行,分页边界就会落在明细行之间,造成主表重复、漏项,或总数与页面内容不一致。
下面以订单和订单明细为例,使用 Java 17、MyBatis XML 和 MySQL 的 LIMIT 语法实现。核心流程是:统计符合条件的订单数、分页查询订单、批量查询这些订单的明细,再按订单 ID 组装返回结果。项目使用其他数据库时,需要相应调整分页语法。
假设订单 101 有三条明细,订单 102 有一条明细。执行下面的查询时,数据库先把订单与明细连接,再对连接后的行分页:
SELECT o.id, o.order_no, i.id AS item_id, i.product_name
FROM order_main o
LEFT JOIN order_item i ON i.order_id = o.id
ORDER BY o.created_at DESC, o.id DESC
LIMIT 0, 2;
连接结果中,订单 101 会出现三行。每页取两行时,结果可能是订单 101 的两条明细,而不是两张订单。即使将统计 SQL 改成 COUNT(DISTINCT o.id),也只能修正总数,不能让 LIMIT 按主表记录生效。
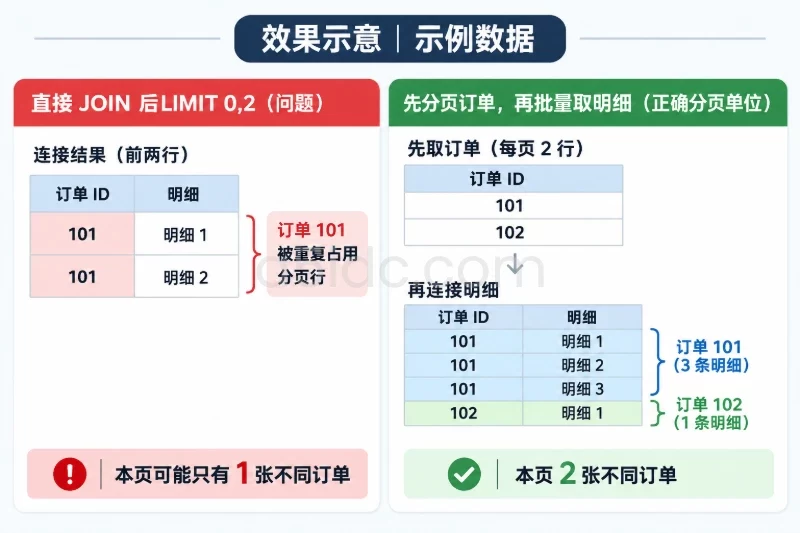
因此,分页单位必须和业务页面展示的单位一致:页面按订单翻页,就先分页订单。明细数据随后按本页订单 ID 一次性批量获取,避免逐张订单查询明细造成 N+1 查询。
以下示例将订单主信息和明细分别查询。OrderPageRow、OrderItemRow 使用 Java 17 record,MyBatis 通过显式构造器映射结果。实际项目可按已有包名和字段替换。
package com.example.order.dto;

import java.time.LocalDateTime;

public record OrderPageRow(
        Long id,
        String orderNo,
        String status,
        LocalDateTime createdAt
) {}
package com.example.order.dto;

public record OrderItemRow(
        Long id,
        Long orderId,
        String productName,
        Integer quantity
) {}
接口返回的明细不一定要暴露 orderId。可定义面向页面的对象,并把主表与明细组合起来:
package com.example.order.dto;

import java.util.List;

public record OrderItemView(
        Long id,
        String productName,
        Integer quantity
) {}

public record OrderView(
        Long id,
        String orderNo,
        String status,
        List<OrderItemView> items
) {}

public record OrderPageResult(
        long total,
        long pageNo,
        int pageSize,
        List<OrderView> records
) {}
Mapper 提供三个查询:总数、当前页主表、当前页关联明细。使用 @Param 为 XML 参数指定明确名称:
package com.example.order.mapper;

import com.example.order.dto.OrderItemRow;
import com.example.order.dto.OrderPageRow;
import org.apache.ibatis.annotations.Param;

import java.util.List;

public interface OrderMapper {

    long countOrders(
            @Param("status") String status,
            @Param("keyword") String keyword
    );

    List<OrderPageRow> selectOrderPage(
            @Param("status") String status,
            @Param("keyword") String keyword,
            @Param("offset") long offset,
            @Param("pageSize") int pageSize
    );

    List<OrderItemRow> selectItemsByOrderIds(
            @Param("orderIds") List<Long> orderIds
    );
}
下面的 XML 中,统计和分页查询使用相同的主表筛选条件。条件写成可复用的 SQL 片段,减少两处筛选逻辑不一致的风险。
<?xml version="1.0" encoding="UTF-8" ?>
<!DOCTYPE mapper
        PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
        "https://mybatis.org/dtd/mybatis-3-mapper.dtd">

<mapper namespace="com.example.order.mapper.OrderMapper">

    <resultMap id="orderPageRowMap"
               type="com.example.order.dto.OrderPageRow">
        <constructor>
            <idArg column="id" javaType="java.lang.Long"/>
            <arg column="order_no" javaType="java.lang.String"/>
            <arg column="status" javaType="java.lang.String"/>
            <arg column="created_at" javaType="java.time.LocalDateTime"/>
        </constructor>
    </resultMap>

    <resultMap id="orderItemRowMap"
               type="com.example.order.dto.OrderItemRow">
        <constructor>
            <idArg column="id" javaType="java.lang.Long"/>
            <arg column="order_id" javaType="java.lang.Long"/>
            <arg column="product_name" javaType="java.lang.String"/>
            <arg column="quantity" javaType="java.lang.Integer"/>
        </constructor>
    </resultMap>

    <sql id="orderFilters">
        <where>
            <if test="status != null and status != ''">
                AND o.status = #{status}
            </if>
            <if test="keyword != null and keyword != ''">
                AND o.order_no LIKE CONCAT('%', #{keyword}, '%')
            </if>
        </where>
    </sql>

    <select id="countOrders" resultType="long">
        SELECT COUNT(*)
        FROM order_main o
        <include refid="orderFilters"/>
    </select>

    <select id="selectOrderPage" resultMap="orderPageRowMap">
        SELECT o.id, o.order_no, o.status, o.created_at
        FROM order_main o
        <include refid="orderFilters"/>
        ORDER BY o.created_at DESC, o.id DESC
        LIMIT #{offset}, #{pageSize}
    </select>

    <select id="selectItemsByOrderIds" resultMap="orderItemRowMap">
        SELECT i.id, i.order_id, i.product_name, i.quantity
        FROM order_item i
        WHERE i.order_id IN
        <foreach collection="orderIds"
                 item="orderId"
                 open="("
                 separator=","
                 close=")">
            #{orderId}
        </foreach>
        ORDER BY i.order_id, i.id
    </select>

</mapper>
ORDER BY 中除了业务排序字段 created_at,还加入了唯一且稳定的 id。如果只按创建时间排序,多个订单可能有相同时间,数据库在不同查询中不一定保持相同的相对顺序,翻页时就可能出现重复或遗漏。
LIMIT offset, pageSize 中,偏移量从 0 开始。例如每页 20 条,第 1 页偏移量为 0,第 3 页偏移量为 40。SQL 查询的是主表,所以每一行对应一张订单。
下面的 Service 验证页码和页大小,先查总数,再查当前页主表和明细。页面顺序以主表查询结果为准;IN 查询不会保证明细行按传入 ID 顺序返回,因此需要按订单 ID 分组后再逐张订单组装。
package com.example.order.service;

import com.example.order.dto.*;
import com.example.order.mapper.OrderMapper;
import org.springframework.stereotype.Service;
import org.springframework.transaction.annotation.Transactional;

import java.util.ArrayList;
import java.util.List;
import java.util.Map;
import java.util.stream.Collectors;

@Service
public class OrderQueryService {

    private final OrderMapper orderMapper;

    public OrderQueryService(OrderMapper orderMapper) {
        this.orderMapper = orderMapper;
    }

    @Transactional(readOnly = true)
    public OrderPageResult pageOrders(
            long pageNo,
            int pageSize,
            String status,
            String keyword
    ) {
        if (pageNo < 1) {
            throw new IllegalArgumentException("pageNo 必须大于或等于 1");
        }
        if (pageSize < 1 || pageSize > 100) {
            throw new IllegalArgumentException("pageSize 必须在 1 到 100 之间");
        }

        String normalizedKeyword =
                keyword == null || keyword.isBlank() ? null : keyword.trim();

        long offset = Math.multiplyExact(pageNo - 1, (long) pageSize);
        long total = orderMapper.countOrders(status, normalizedKeyword);

        if (total == 0 || offset >= total) {
            return new OrderPageResult(total, pageNo, pageSize, List.of());
        }

        List<OrderPageRow> orders = orderMapper.selectOrderPage(
                status, normalizedKeyword, offset, pageSize
        );

        if (orders.isEmpty()) {
            return new OrderPageResult(total, pageNo, pageSize, List.of());
        }

        List<Long> orderIds = orders.stream()
                .map(OrderPageRow::id)
                .toList();

        List<OrderItemRow> itemRows =
                orderMapper.selectItemsByOrderIds(orderIds);

        Map<Long, List<OrderItemView>> itemsByOrderId = itemRows.stream()
                .collect(Collectors.groupingBy(
                        OrderItemRow::orderId,
                        Collectors.mapping(
                                item -> new OrderItemView(
                                        item.id(),
                                        item.productName(),
                                        item.quantity()
                                ),
                                Collectors.toList()
                        )
                ));

        List<OrderView> records = new ArrayList<>(orders.size());
        for (OrderPageRow order : orders) {
            List<OrderItemView> items = itemsByOrderId.getOrDefault(
                    order.id(), List.of()
            );
            records.add(new OrderView(
                    order.id(),
                    order.orderNo(),
                    order.status(),
                    items
            ));
        }

        return new OrderPageResult(total, pageNo, pageSize, records);
    }
}
Math.multiplyExact 用于检测偏移量乘法溢出。若页码来自外部请求,还可以在请求层限制最大页码,避免极大的偏移量触发数据库慢查询。示例将页大小限制为 100;这个上限应结合接口用途和数据库负载调整。
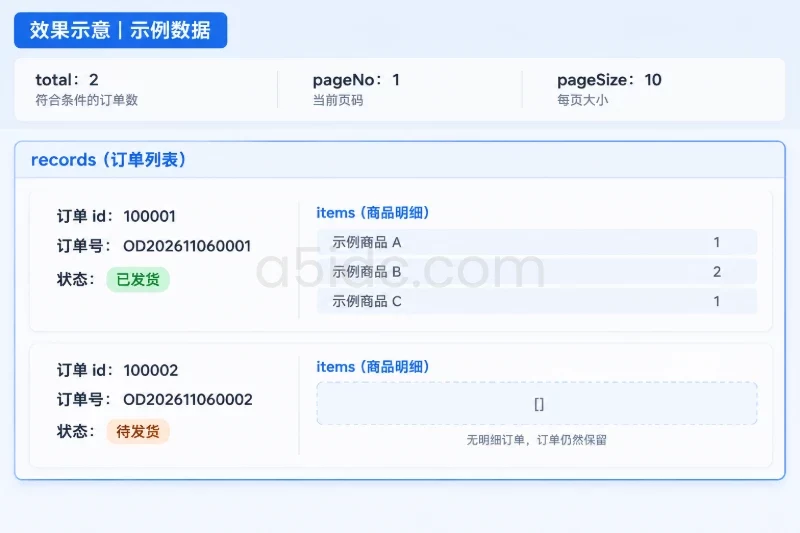
返回结果的 total 表示符合筛选条件的订单数,而不是明细行数。某张订单没有明细时,仍然会出现在订单列表中,其 items 是空列表,不会因为使用内连接而丢失。
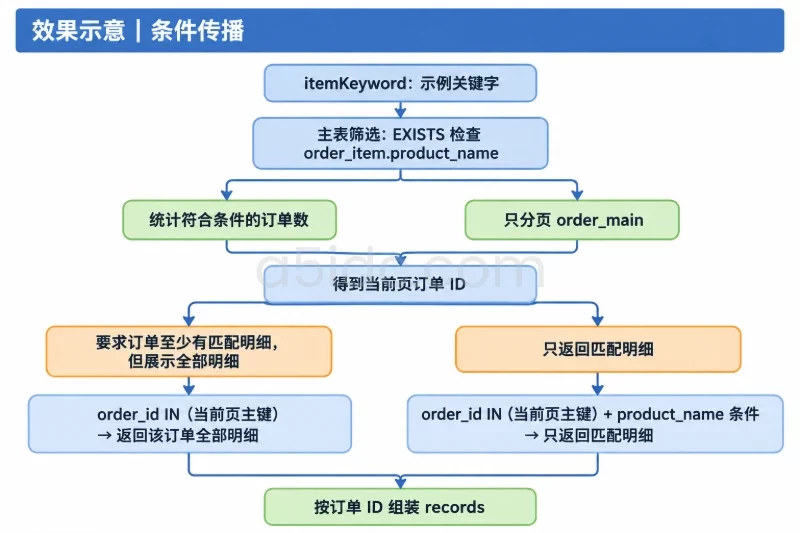
筛选条件决定了哪些订单进入分页,也决定了返回哪些明细。两者不能混为一谈。
如果要求“订单至少有一条商品名匹配的明细,但页面展示该订单全部明细”,应使用 EXISTS 筛选主表,并在明细查询中继续按订单 ID 查询全部记录:
SELECT o.id, o.order_no, o.status, o.created_at
FROM order_main o
WHERE EXISTS (
    SELECT 1
    FROM order_item i
    WHERE i.order_id = o.id
      AND i.product_name LIKE CONCAT('%', #{itemKeyword}, '%')
)
ORDER BY o.created_at DESC, o.id DESC
LIMIT #{offset}, #{pageSize};
此时统计 SQL 也要加入相同的 EXISTS 条件,否则 total 与页面筛选范围不一致。不要仅在分页查询中加条件、却忘记修改计数查询。
如果要求“只返回匹配的明细”,主表仍可用 EXISTS 过滤;批量查明细的 SQL 再加入同样的商品名条件。这样可以避免因多条匹配明细而重复计算订单,同时只返回符合条件的明细行。若筛选的是主表字段,例如订单状态,则直接在主表的 WHERE 中筛选即可。
查询参数使用 #{} 绑定,避免把用户输入拼接进 SQL。示例中的 LIKE '%关键字%' 会把 % 和 _ 作为通配符处理;若产品要求它们按普通字符匹配,应在应用层转义,并为 SQL 指定匹配规则。
可以准备少量测试数据:订单 A 有 3 条明细,订单 B 有 1 条明细,订单 C 没有明细。将页大小设为 2,按创建时间和 ID 排序后检查:
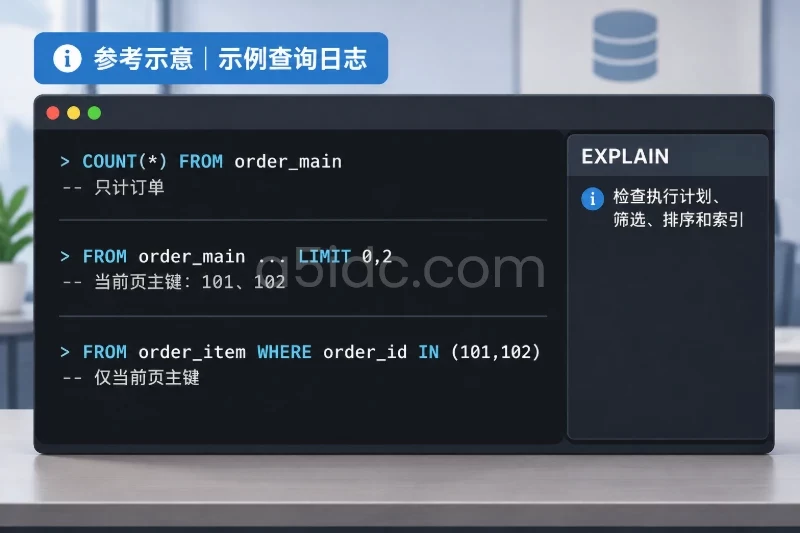
total 应为符合筛选条件的订单数。items 数量应与关联明细数一致。items 为空。还可以在日志或数据库客户端分别查看三条 SQL:统计 SQL 应只按主表计数;分页 SQL 应只从主表取记录;明细 SQL 的 IN 列表应只包含当前页主键。对数据量较大的表,可用数据库的 EXPLAIN 检查执行计划,并根据筛选和排序模式评估索引。例如,明细表通常需要以 order_id 开头的索引;主表索引则应根据实际筛选字段和排序字段设计,不能仅凭示例列出就认为适用于所有查询。
| 方式 | 分页是否按主表生效 | 适用情况 |
|---|---|---|
| 先分页主表,再批量查询明细 | 是 | 常规一对多列表,逻辑清楚,便于控制返回结构 |
JOIN 后直接 LIMIT | 否 | 不适合要求按主表分页的页面 |
| JOIN 后按主键分组或去重 | 不一定 | 需要仔细处理数据库分页、排序、计数和空关联记录,不能仅靠应用层去重修复漏掉的主表 |
| 数据库窗口函数先选主表,再 JOIN | 可以 | 适合数据库支持窗口函数且希望单条 SQL 返回;SQL 复杂度和数据库兼容性需要评估 |
先查主表再批量取明细通常会执行三条查询,但不会随主表记录数逐条增加明细查询次数。若页大小很大,IN 参数过多或单次结果过大,应限制页大小,或按适合当前数据库的方式分批查询明细;分批时仍要按订单 ID 汇总,不能改变主表分页结果。
最后还要考虑多次查询期间的数据变化。示例用 Spring 的只读事务把统计、分页和明细读取放在同一事务边界内,但只读标记本身不等于所有数据库都提供一致性快照。若业务要求 total、订单和明细严格对应同一时点,应结合所用数据库的事务隔离级别确认一致性读行为;若允许并发写入导致短暂差异,则可按普通列表查询处理,并由下一次刷新获取最新状态。
对于这类以订单为主表、同时读取明细的业务接口,A5idc数据可提供香港、美国、日本、新加坡等地区的物理服务器资源,结合不同CPU、内存、SSD或NVMe存储及网络线路,承载Java应用、数据库和接口服务;域名、SSL证书与CDN业务也可用于应用入口、HTTPS连接和静态资源分发,便于将数据查询能力接入实际业务环境。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9958.html