香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


导入端统一按明确的字符集解码,导出端统一按明确的字符集编码,是 Java CSV 中文不乱码的基础。新文件通常使用 UTF-8;如果文件要直接交给部分表格软件打开,可以在 UTF-8 内容前加入 BOM。BOM 只解决部分软件识别编码的问题,不能代替正确的读写编码,也不能修复已经按错误字符集保存的数据。
下面用 Apache Commons CSV 实现一个订单 CSV 的导入和导出。示例按 Java 17 编写,包含 UTF-8 BOM 处理、表头校验、金额转换和 CSV 字段转义。
在 Maven 项目的 pom.xml 中加入 Apache Commons CSV:
<dependency>
    <groupId>org.apache.commons</groupId>
    <artifactId>commons-csv</artifactId>
    <version>1.10.0</version>
</dependency>
示例文件的表头为“订单号、客户名称、金额、备注”。带逗号、双引号或换行的字段必须遵循 CSV 规则,例如:
订单号,客户名称,金额,备注
A1001,星河商贸,128.50,普通订单
A1002,示例客户,256.00,"地址包含逗号,需加引号"
A1003,远山科技,89.90,"备注第一行
备注第二行"
不要通过 String.split(",") 读取这种文件:引号内的逗号和换行属于字段内容,不是列分隔符。Commons CSV 会按 CSV 规则解析这些字段。
先定义用于承接 CSV 数据的对象。这里使用 BigDecimal 保存金额,避免用 double 处理业务金额时引入二进制浮点误差。
import java.math.BigDecimal;

public record OrderCsvRow(
        String orderNo,
        String customerName,
        BigDecimal amount,
        String remark) {
}
导入时先检查表头是否完整且顺序符合约定,再逐行读取。示例将 UTF-8 解码器设置为遇到非法字节时报告错误,而不是悄悄替换字符;这样可以尽早发现文件实际编码不符合约定的情况。
import org.apache.commons.csv.CSVFormat;
import org.apache.commons.csv.CSVParser;
import org.apache.commons.csv.CSVRecord;

import java.io.IOException;
import java.io.InputStream;
import java.io.InputStreamReader;
import java.io.PushbackInputStream;
import java.io.Reader;
import java.math.BigDecimal;
import java.nio.charset.CodingErrorAction;
import java.nio.charset.StandardCharsets;
import java.util.ArrayList;
import java.util.List;

public class OrderCsvService {

    private static final List<String> HEADERS =
            List.of("订单号", "客户名称", "金额", "备注");

    private static final CSVFormat IMPORT_FORMAT =
            CSVFormat.DEFAULT.builder()
                    .setHeader()
                    .setSkipHeaderRecord(true)
                    .setIgnoreEmptyLines(true)
                    .build();

    /**
     * 本方法会读取并关闭传入的 InputStream。
     */
    public List<OrderCsvRow> readOrders(InputStream input) throws IOException {
        InputStream bomAwareInput = stripUtf8Bom(input);

        Reader reader = new InputStreamReader(
                bomAwareInput,
                StandardCharsets.UTF_8.newDecoder()
                        .onMalformedInput(CodingErrorAction.REPORT)
                        .onUnmappableCharacter(CodingErrorAction.REPORT));

        List<OrderCsvRow> rows = new ArrayList<>();

        try (CSVParser parser = IMPORT_FORMAT.parse(reader)) {
            if (!HEADERS.equals(parser.getHeaderNames())) {
                throw new IOException(
                        "CSV表头不符合约定,应为:" + String.join(",", HEADERS));
            }

            for (CSVRecord record : parser) {
                if (record.size() != HEADERS.size()) {
                    throw new IOException(
                            "第 " + record.getRecordNumber() + " 条记录的列数不正确");
                }

                String orderNo = record.get("订单号").trim();
                String customerName = record.get("客户名称").trim();
                String amountText = record.get("金额").trim();
                String remark = record.get("备注");

                if (orderNo.isEmpty()) {
                    throw new IOException(
                            "第 " + record.getRecordNumber() + " 条记录缺少订单号");
                }

                BigDecimal amount = null;
                if (!amountText.isEmpty()) {
                    try {
                        amount = new BigDecimal(amountText);
                    } catch (NumberFormatException e) {
                        throw new IOException(
                                "第 " + record.getRecordNumber()
                                        + " 条记录的金额格式不正确",
                                e);
                    }
                }

                rows.add(new OrderCsvRow(
                        orderNo,
                        customerName,
                        amount,
                        remark));
            }
        }

        return rows;
    }

    private static InputStream stripUtf8Bom(InputStream input)
            throws IOException {
        PushbackInputStream in = new PushbackInputStream(input, 3);

        int first = in.read();
        int second = in.read();
        int third = in.read();

        boolean hasUtf8Bom =
                first == 0xEF && second == 0xBB && third == 0xBF;

        if (!hasUtf8Bom) {
            if (third != -1) {
                in.unread(third);
            }
            if (second != -1) {
                in.unread(second);
            }
            if (first != -1) {
                in.unread(first);
            }
        }

        return in;
    }
}
stripUtf8Bom 只识别 UTF-8 BOM。文件开头没有 BOM 时,读取到的字节会被放回流中,不影响正常解析。导入端如果不处理 BOM,部分解析器可能把 BOM 当成第一个表头字符,造成“订单号”列匹配失败。
表头检查采用严格匹配:表头名称或顺序不一致时直接报错,而不是继续读取并把数据写入错误字段。如果业务确实允许列顺序变化,可以按表头名称建立映射,再逐列读取;但仍应检查必需列是否存在,以及是否出现重复表头。
金额字段允许为空,并在有值时转换为 BigDecimal。如果业务规定金额必填,可以在转换前检查空值并报出记录位置。实际导入数据库时,也应先完成字段校验,再按业务规则决定如何写入;不要在读到每一行时无条件提交,以免后续记录出错后留下部分导入结果。
导出时把 OutputStream 明确包装为 UTF-8 的 Writer,并让 CSV 库负责字段转义。下面的代码支持可选 BOM:传入 true 时,文件开头会写入 UTF-8 BOM,适合需要兼顾部分表格软件直接打开的场景;传入 false 时,文件是没有 BOM 的标准 UTF-8 内容。
import org.apache.commons.csv.CSVFormat;
import org.apache.commons.csv.CSVPrinter;

import java.io.IOException;
import java.io.OutputStream;
import java.io.OutputStreamWriter;
import java.io.Writer;
import java.nio.charset.StandardCharsets;
import java.util.List;

public class OrderCsvExporter {

    private static final String[] HEADERS =
            {"订单号", "客户名称", "金额", "备注"};

    private static final CSVFormat EXPORT_FORMAT =
            CSVFormat.DEFAULT.builder()
                    .setHeader(HEADERS)
                    .setRecordSeparator("\r\n")
                    .build();

    /**
     * 本方法不会关闭 output,调用方负责关闭或管理输出流。
     */
    public void writeOrders(
            OutputStream output,
            List<OrderCsvRow> rows,
            boolean writeUtf8Bom) throws IOException {

        Writer writer =
                new OutputStreamWriter(output, StandardCharsets.UTF_8);

        if (writeUtf8Bom) {
            writer.write('\uFEFF');
        }

        CSVPrinter printer = new CSVPrinter(writer, EXPORT_FORMAT);

        for (OrderCsvRow row : rows) {
            printer.printRecord(
                    row.orderNo(),
                    row.customerName(),
                    row.amount() == null
                            ? ""
                            : row.amount().toPlainString(),
                    row.remark());
        }

        printer.flush();
    }
}
该方法不会关闭调用方传入的流,但会在结束时执行 flush(),把编码器和输出缓冲区中的内容写出。调用方需要负责关闭文件流或管理 HTTP 响应流。发生写入异常时,文件可能只包含部分数据;如果导出结果要保存为正式文件,可先写入临时文件,确认完整写出后再替换目标文件。
CSVPrinter 会处理字段中包含的逗号、引号和换行。例如备注为 地址包含逗号,需加引号 时,导出的 CSV 会自动为该字段加引号;字段本身有双引号时,也会按 CSV 规则转义。不要自行拼接逗号和换行来生成 CSV,否则容易在特殊字符处破坏列结构。
文件导入可以直接把文件流交给读取方法。读取方法会关闭传入流,因此不需要在外层重复管理同一个流:
import java.io.InputStream;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.List;

Path csvPath = Path.of("orders.csv");

List<OrderCsvRow> rows;
try (InputStream input = Files.newInputStream(csvPath)) {
    rows = new OrderCsvService().readOrders(input);
}
如果项目需要由调用方统一管理输入流,应调整读取方法的所有权约定,避免调用方和方法内部同时关闭或重复使用同一个流。示例中的 readOrders 会关闭传入流,而导出方法则不会关闭传入的 OutputStream,这两种约定都应在接口文档中明确。
下载接口通常还需要设置响应类型和下载文件名。以 Servlet 响应为例:
response.setContentType("text/csv; charset=UTF-8");
response.setHeader(
        "Content-Disposition",
        "attachment; filename=\"orders.csv\"");

new OrderCsvExporter().writeOrders(
        response.getOutputStream(),
        rows,
        true);
这里使用 ASCII 文件名,避免不同浏览器对中文文件名编码处理不一致。如果要使用中文文件名,应按项目使用的 Servlet 和浏览器兼容方案正确编码 Content-Disposition,不要直接把未经编码的中文拼进响应头。
读写时不要依赖系统默认字符集。 new InputStreamReader(input) 和 new OutputStreamWriter(output) 如果没有指定字符集,会使用运行环境的默认值。开发机、容器和服务器的默认字符集可能不同,文件就可能在一个环境正常、换到另一个环境后乱码。读写时明确使用 StandardCharsets.UTF_8,并要求上下游对文件编码达成一致。
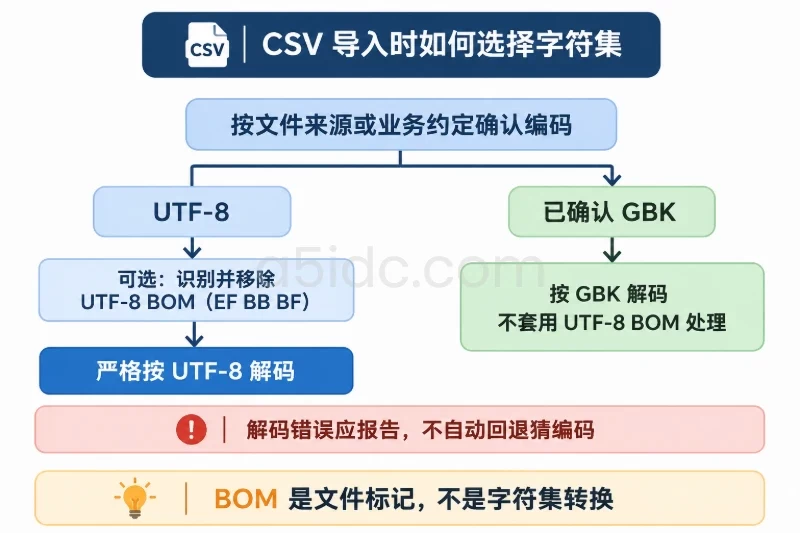
UTF-8 BOM 和字符集不是一回事。 UTF-8 BOM 是文件开头的三个字节,部分表格软件会用它识别 UTF-8;它不会把 GBK 内容转换为 UTF-8。上例的导入方法能去掉 UTF-8 BOM,但不能据此判断文件采用了哪种字符集。
旧系统导出的 GBK 文件要明确指定编码。 如果文件生产方确认使用 GBK,应使用对应字符集读取,例如:
Reader reader = new InputStreamReader(input, java.nio.charset.Charset.forName("GBK"));
该写法不能直接套用上例的 UTF-8 BOM 处理逻辑。不要在 UTF-8 解码失败后无条件切换到 GBK:字符集自动猜测并不可靠,错误的回退可能让文件“看起来可读”,实际内容却已被错误解码。对同一导入入口支持多种编码时,最好通过配置、文件类型选项或明确的业务约定选择编码,并对非法字节给出可定位的错误。
乱码若发生在导入前,改 Java 代码未必能修复。 例如源数据已经按错误字符集保存,或者数据库写入时使用了错误字符集,之后再用 UTF-8 导出也只会输出已经损坏的字符。排查时可以依次确认文件实际编码、读取时指定的字符集、字段写入时的处理,以及数据库连接和列的字符集设置。
上例把全部记录收集到 List 中,便于展示字段校验和后续处理,适合文件规模受控的场景。记录较多时,列表会持续占用堆内存;可以改成逐条校验并交给业务处理器,或按固定批次处理。若导入要写数据库,建议先明确失败策略,例如整批回滚、分批提交并记录失败行,避免文件只导入了一部分却没有可追踪的结果。
对于面向表格软件的人工查看文件,还要区分“CSV 字段转义”和“表格公式处理”。字段加引号可以保证逗号等字符按 CSV 规则读取,但不一定能防止表格软件把以 =, +, - 或 @ 等字符开头的文本当成公式。对外提供人工查看文件时,应根据目标软件和安全要求制定文本字段处理策略;对系统间交换文件则应避免随意修改原始值,否则可能影响数据回读和对账。
可以用一份包含中文、英文、逗号、双引号和换行的样例文件验证导入导出流程。重点检查:
如果输出文件要由其他程序读取,优先确认对方接受的编码和是否需要 BOM;如果主要供表格软件打开,再针对目标软件验证 BOM 行为。将编码约定、表头和字段格式写入接口文档后,CSV 导入导出的兼容问题通常更容易定位,也不必依赖“换一个服务器再试”的方式排查。
CSV 导入导出通常是业务后台与数据存储链路的一环。A5idc数据提供香港、美国、日本、中国台湾、新加坡、韩国及马来西亚等地的物理服务器,涵盖不同 CPU、内存、SSD/NVMe 存储和线路配置,可为 Java 接口服务、业务后台及数据库部署提供资源基础;面向不同地区的业务访问,也有相应地域与网络方案可选,支持文件处理服务与业务数据系统按实际架构部署。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9880.html