香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


实现断点续传的关键,不是单独记住“处理到第几页”,而是把目标数据变更与同步游标放进同一个目标库事务。进程失败后,从已提交的游标继续读取;若故障发生在提交前,未完成的这一批会再次读取,因此目标端的写入必须可以安全重放。
下面用 Python、PostgreSQL 和递增的源端变更序号 change_seq 演示。每条新增、修改或删除都对应一条变更记录,消费者按序读取并保存已处理序号。实际 ERP 若提供的是变更令牌而非数字序号,持久化方式相同,但需要按其接口语义替换游标。
游标应指向一个可继续读取的源端位置,而不是易变的页码。页码会因源数据新增或排序变化而偏移;递增变更序号或 API 提供的 delta token,则通常能让下一次读取从明确位置开始。
下面的实现假设源端提供以下能力:
seq 递增排列,查询条件为 seq > after_seq。如果 ERP 只提供按更新时间查询的接口,也可以保存 (updated_at, id) 作为游标,但要额外处理时间精度、同一时间戳下的多条记录以及更新发生在扫描过程中的情况。单纯记住“最后一条记录的时间”并不总能保证不漏数据。
目标表保存 ERP 业务数据,source_seq 记录最后应用到该记录的源端变更序号。进度表按同步任务保存全局游标。
CREATE TABLE IF NOT EXISTS erp_order (
    id          BIGINT PRIMARY KEY,
    payload     JSONB NOT NULL,
    is_deleted  BOOLEAN NOT NULL DEFAULT FALSE,
    source_seq  BIGINT NOT NULL
);

CREATE TABLE IF NOT EXISTS sync_checkpoint (
    job_name    TEXT PRIMARY KEY,
    last_seq    BIGINT NOT NULL CHECK (last_seq >= 0),
    updated_at  TIMESTAMPTZ NOT NULL DEFAULT NOW()
);

INSERT INTO sync_checkpoint (job_name, last_seq)
VALUES ('erp_orders', 0)
ON CONFLICT (job_name) DO NOTHING;
is_deleted 用于保存删除墓碑。若直接物理删除目标记录,稍后重放较早的修改事件时,可能会重新插入已删除的数据。保留墓碑并记录源端序号,可以让目标端识别较旧事件。
job_name 应能区分同步方向和业务实体,例如 erp_orders_to_reporting。多个实体若需要作为一个业务单元共同提交,应在同一目标事务里应用它们,并且在全部完成后再推进游标。
以下代码依赖 Psycopg 3。source.fetch_changes(after_seq, limit) 是 ERP 适配层:它应返回按 seq 升序排列的事件,例如 {"seq": 105, "op": "upsert", "id": 9001, "data": {"status": "paid"}}。不同 ERP 的认证、分页参数和错误码各不相同,需要在适配层中实现。
import json

import psycopg


JOB_NAME = "erp_orders"
BATCH_SIZE = 500

# 请为每个同步任务选择不冲突的一组整数键。
LOCK_KEY_1 = 812345
LOCK_KEY_2 = 1


def apply_event(conn, event):
    seq = event["seq"]
    record_id = event["id"]
    op = event["op"]

    if op == "upsert":
        payload = json.dumps(event["data"], ensure_ascii=False)
        conn.execute(
            """
            INSERT INTO erp_order (id, payload, is_deleted, source_seq)
            VALUES (%s, %s::jsonb, FALSE, %s)
            ON CONFLICT (id) DO UPDATE
            SET payload = EXCLUDED.payload,
                is_deleted = FALSE,
                source_seq = EXCLUDED.source_seq
            WHERE erp_order.source_seq < EXCLUDED.source_seq
            """,
            (record_id, payload, seq),
        )
    elif op == "delete":
        conn.execute(
            """
            INSERT INTO erp_order (id, payload, is_deleted, source_seq)
            VALUES (%s, '{}'::jsonb, TRUE, %s)
            ON CONFLICT (id) DO UPDATE
            SET payload = '{}'::jsonb,
                is_deleted = TRUE,
                source_seq = EXCLUDED.source_seq
            WHERE erp_order.source_seq < EXCLUDED.source_seq
            """,
            (record_id, seq),
        )
    else:
        raise ValueError(f"不支持的事件类型: {op}")


def sync_orders(source, target_dsn):
    with psycopg.connect(target_dsn) as conn:
        acquired = False

        try:
            # 同一任务只允许一个消费者推进游标。
            with conn.transaction():
                acquired = conn.execute(
                    "SELECT pg_try_advisory_lock(%s, %s)",
                    (LOCK_KEY_1, LOCK_KEY_2),
                ).fetchone()[0]

            if not acquired:
                return

            while True:
                with conn.transaction():
                    row = conn.execute(
                        """
                        SELECT last_seq
                        FROM sync_checkpoint
                        WHERE job_name = %s
                        FOR UPDATE
                        """,
                        (JOB_NAME,),
                    ).fetchone()

                    if row is None:
                        raise RuntimeError(f"缺少同步进度记录: {JOB_NAME}")

                    last_seq = row[0]

                # 读取源端不改变目标端状态。提交失败时,下次仍从 last_seq 重读。
                events = source.fetch_changes(
                    after_seq=last_seq,
                    limit=BATCH_SIZE,
                )

                if not events:
                    return

                previous_seq = last_seq
                for event in events:
                    seq = event.get("seq")
                    if not isinstance(seq, int) or seq <= previous_seq:
                        raise ValueError("源端事件序号无效或未按升序返回")
                    if event.get("op") not in {"upsert", "delete"}:
                        raise ValueError("源端事件类型无效")
                    previous_seq = seq

                new_last_seq = events[-1]["seq"]

                # 业务数据和游标在同一事务中提交。
                with conn.transaction():
                    current = conn.execute(
                        """
                        SELECT last_seq
                        FROM sync_checkpoint
                        WHERE job_name = %s
                        FOR UPDATE
                        """,
                        (JOB_NAME,),
                    ).fetchone()[0]

                    if current != last_seq:
                        # 游标已变化时不使用旧批次,重新读取最新位置。
                        continue

                    for event in events:
                        apply_event(conn, event)

                    conn.execute(
                        """
                        UPDATE sync_checkpoint
                        SET last_seq = %s,
                            updated_at = NOW()
                        WHERE job_name = %s
                        """,
                        (new_last_seq, JOB_NAME),
                    )

        finally:
            if acquired:
                with conn.transaction():
                    conn.execute(
                        "SELECT pg_advisory_unlock(%s, %s)",
                        (LOCK_KEY_1, LOCK_KEY_2),
                    )
运行时由调度器创建 source 适配器,并提供目标 PostgreSQL 连接串:
sync_orders(source, target_dsn)
代码会持续取批,直到源端返回空列表。即使一批不足 BATCH_SIZE,也会继续查询一次,以免适配器因响应限制而提前截断结果。
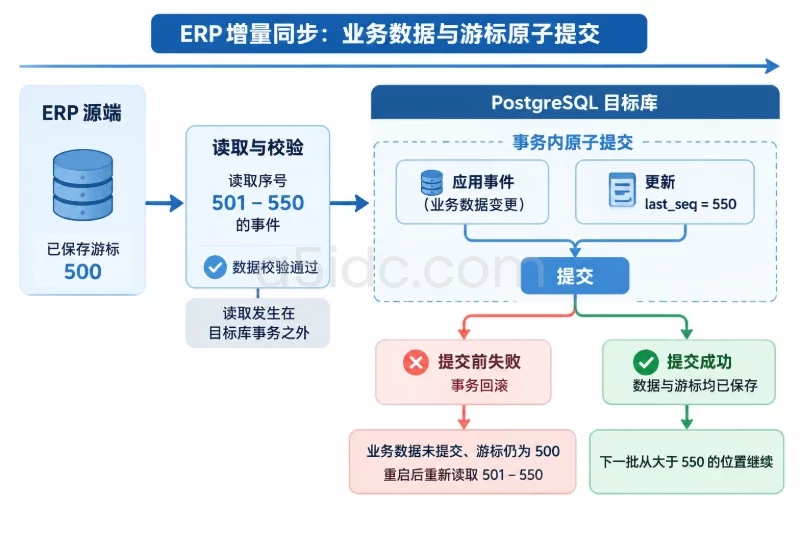
设当前游标是 500,一次读取返回序号 501 到 550 的事件。处理过程中的关键状态变化如下:
| 失败时机 | 目标数据 | 已保存游标 | 重启后的行为 |
|---|---|---|---|
| 目标事务开始前 | 未变 | 500 | 重新读取 501 起的事件 |
| 目标事务执行期间 | 事务回滚 | 500 | 重新读取这一批 |
| 目标事务成功提交后 | 已写入 501 至 550 | 550 | 从 551 之后继续 |
因为事件写入和 last_seq 更新处于同一事务,目标库不会出现“数据已经落库、游标却还停在旧位置”的长期不一致,也不会出现“游标已前进、数据却没有写完”的跳过问题。若连接在提交时断开,客户端无法确认事务结果,应重新查询进度表,而不是自行猜测是否成功。
这类设计通常是至少一次读取,加上目标端幂等写入,不应笼统宣称跨系统实现了端到端“恰好一次”。ON CONFLICT 使重复事件可安全重放;source_seq 条件则避免较旧事件覆盖已应用的较新状态。
同一同步任务不能让两个消费者各自读取同一游标后并行推进。代码中的 PostgreSQL advisory lock 用于避免重复消费者;如果部署环境使用其他数据库或任务队列,应使用对应的租约、互斥锁或单消费者机制。锁应覆盖读取当前游标、拉取事件和提交目标事务的整个处理周期。
事件顺序也不能任意打乱。代码按源端序号逐条应用;若为提高吞吐而并发处理,必须先确认不同事件不会修改同一业务记录,且最终提交顺序不会使旧状态覆盖新状态。对 ERP 订单、库存或账户等可能存在关联约束的数据,简单并发通常会让排查更困难,不应只为缩短耗时而牺牲顺序。
删除必须作为可追踪的变化传递。若 ERP 的接口只返回当前仍存在的记录,消费者无法仅靠增量读取判断某条目标记录究竟被删除,还是暂时未出现在这一页。可以使用源端删除日志、带版本的墓碑记录,或周期性对账来补足这一边界。
进度表中的 last_seq 适合记录增量变更的位置,但初次全量导入还需要考虑扫描期间发生的修改。较稳妥的做法是使用 ERP 提供的快照与增量令牌配对能力:先获得与快照对应的起始令牌,完成可续传的全量分页,再从该令牌消费增量事件。全量扫描期间产生的变化由增量流补齐。
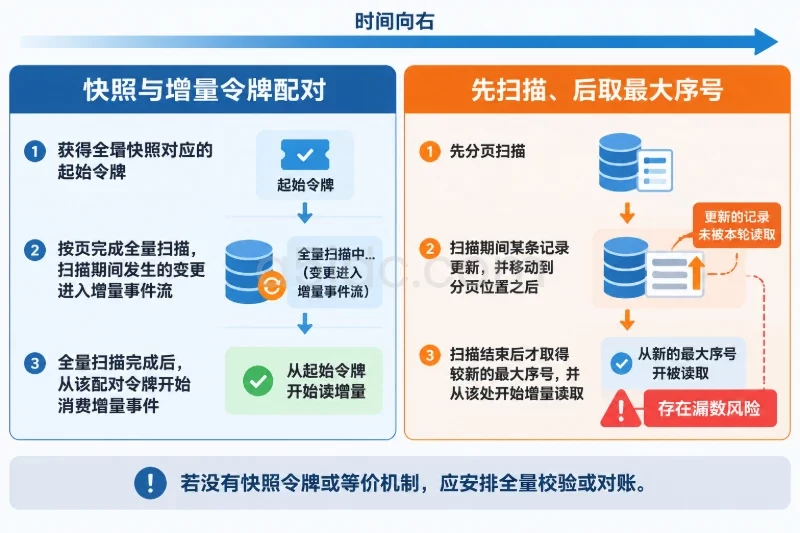
如果先全量扫描、结束后才查询“现在的最大序号”,扫描期间发生的更新可能已经从分页位置后移,既没被扫描读到,也落在增量游标之前,造成漏数。没有快照令牌或等价机制时,应明确记录该限制,并安排全量校验或对账;不能仅靠保存页码解决一致性问题。
全量扫描的分页进度可以单独保存,例如页内最后一个稳定主键或 API 返回的 continuation token;不要把它与增量变更序号混成同一个字段。两种游标含义不同,恢复逻辑也不同。
批次大小影响请求频率、事务时长和内存占用,可从几百条开始按接口限制和目标库负载调整;它不会替代正确的游标和事务设计。若源端变更保留期短于任务停机时间,续传可能失效,此时应停止推进游标,按 ERP 支持的方式重新建立快照或执行对账,而不是从一个较新的位置继续并把缺口当作已同步。
ERP数据同步链路涉及接口进程、批处理任务与目标数据库的部署,A5idc数据提供香港、美国、日本等地区的物理服务器租用,涵盖Xeon与AMD平台,并有SSD、NVMe及大容量存储等配置,可为同步服务和数据库部署提供计算、内存与存储资源,适配不同业务区域及数据规模下的系统部署需求。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9851.html