香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


在新加坡服务器上修改了 Linux nftables 规则,但端口仍然无法访问、限制规则仍然放行,通常不是“命令没有执行”这么简单。数据包必须先到达正确的网卡和服务器,再经过正确协议族的表、挂载到对应 hook 的基础链,最后还要受到规则顺序和默认策略影响;其中任何一层不匹配,新增规则都可能看起来“不生效”。
排查时不要一开始就反复执行 nft add rule。先确认外部请求是否到达服务器、服务是否监听正确地址,再核对 table、chain、hook、policy 和规则计数器。确认问题位置后,只对必要的运行时规则做临时调整,并保留回滚方式,避免远程操作时把 SSH 或业务端口一起锁死。
先从客户端或其他外部主机发起一次全新的连接。以下命令仅为示例,端口应替换为实际业务端口:
curl -4 -vk --connect-timeout 5 https://203.0.113.10/
curl -6 -vk --connect-timeout 5 https://[2001:db8::10]/
如果不是 HTTP 或 HTTPS 服务,也可以使用:
nc -vz -w 3 203.0.113.10 443
IPv4 和 IPv6 要分开测试。常见的情况是,规则写在 table ip 中,但客户端通过 IPv6 访问;或者只允许了 IPv4 地址,实际请求来自 IPv6。对于 inet 表,规则可以同时处理 IPv4 和 IPv6,但具体匹配条件仍然要使用正确的 ip 或 ip6 字段。
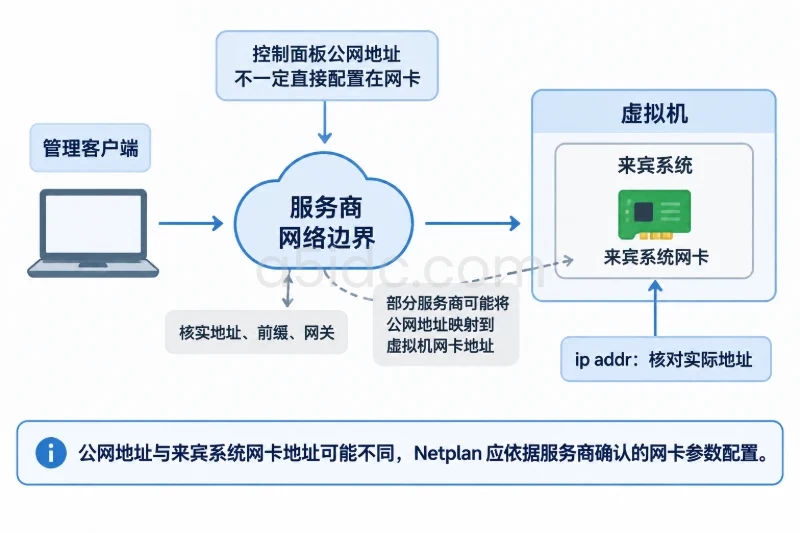
还要确认访问的是服务器实际拥有的公网地址:
ip -br addr
ip route
ip route get 198.51.100.24
ip route get 中的地址应替换为测试客户端的公网 IP。它可以帮助确认返回流量会从哪块网卡、经由哪个网关发出。新加坡服务器所在地区不会改变 nftables 的处理逻辑,但云平台安全组、数据中心边界 ACL、上游防火墙以及公网地址绑定情况,可能让请求在到达本机前就被拦截。
A5idc数据提供新加坡及中国香港、日本、美国等地区的物理服务器资源,覆盖网站、业务后台、数据库和接口服务等Linux部署场景。不同产品可结合CPU、内存、SSD或NVMe存储及网络线路进行配置,为服务监听、外部访问和nftables规则管理提供稳定的主机与网络资源基础。
在服务器上执行:
sudo ss -lntup
重点观察目标端口对应的监听地址:
LISTEN 0  4096  0.0.0.0:443  0.0.0.0:*
LISTEN 0  4096  [::]:443     [::]:*
上面是“监听所有 IPv4 和 IPv6 地址”的示例结果。如果只看到:
LISTEN 0 128 127.0.0.1:8080 0.0.0.0:*
说明服务只接受本机连接,即使 nftables 放行 8080,外部请求也无法直接访问。此时应先检查应用或反向代理的监听配置,而不是继续调整防火墙。
如果外部连接收到 TCP RST,常见原因是没有进程监听目标地址和端口;如果一直超时,则更需要检查数据包是否到达、规则是否丢弃以及返回路径是否正常。
在服务器上短时间抓取目标端口:
sudo tcpdump -ni any 'host 198.51.100.24 and tcp port 443'
198.51.100.24 是文档示例地址,应替换为实际测试客户端 IP。执行命令后,再从客户端发起一次全新的连接。典型结果可以这样判断:
| 抓包现象 | 优先判断方向 | 下一步 |
|---|---|---|
| 完全没有 SYN | 请求未到达本机,或访问了错误地址 | 检查 DNS、云安全组、上游 ACL、公网 IP 和路由 |
| 收到 SYN,但没有 SYN-ACK 或 RST | 本机服务或本机过滤路径可能未放行 | 检查监听状态、input 链、规则顺序和默认策略 |
| 收到 SYN 后立即返回 RST | 端口没有监听,或应用主动拒绝 | 回到 ss -lntup 和应用日志 |
| 收到 SYN 并发出 SYN-ACK,但客户端仍失败 | 本机已处理请求,返回路径或上游设备可能有问题 | 检查出口路由、云平台策略和客户端侧抓包 |
| 数据包到达,但规则计数器一直为 0 | 规则条件、协议族、链或方向不匹配 | 核对 ip、ip6、端口、源地址和实际链路 |
如果服务器没有安装 tcpdump,不要仅凭 nftables 的输出判断“请求没到达”。可以先使用云平台控制台的流量日志或其他主机侧验证手段,避免把上游问题误判成本机规则问题。
读取系统和 nftables 信息:
cat /etc/os-release
nft --version
systemctl is-active nftables
systemctl is-active firewalld
systemctl is-active ufw
某些系统可能没有对应的服务,出现 inactive 或 unknown 不一定代表故障。继续查看实际存在的单元:
systemctl list-unit-files | grep -E 'nftables|firewalld|ufw'
需要特别注意不要同时把多个工具当成配置入口。firewalld 或 ufw 处于运行状态时,它们可能会根据自身配置重新生成 nftables 规则。此时直接执行 nft add rule 只能改变当前运行时状态,随后 reload、restart 或策略刷新后可能被覆盖。
可以进一步查看管理工具的当前状态:
command -v firewall-cmd >/dev/null && sudo firewall-cmd --state
command -v ufw >/dev/null && sudo ufw status verbose
如果确认由 firewalld 或 ufw 管理,应优先修改对应工具的配置,再验证其生成的 nftables 规则,而不是让两个控制平面同时维护同一组端口。
先使用只读命令查看当前内核中的实际规则:
sudo nft list ruleset -a
其中:
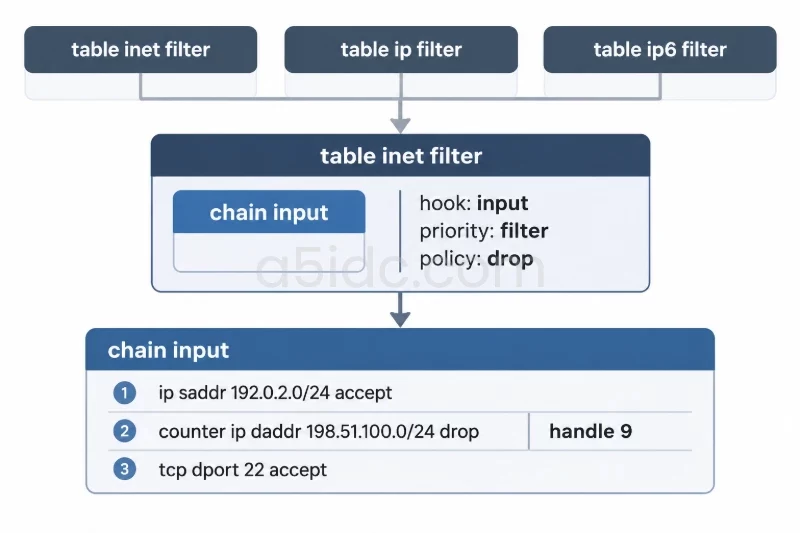
table 是规则表,通常按 ip、ip6、inet、bridge 等协议族区分;chain 是规则链;hook input、hook forward、hook output 表示链挂载到数据包处理路径;priority 决定同一 hook 下不同基础链的大致处理顺序;policy accept 或 policy drop 是基础链未命中明确 verdict 时使用的默认策略;handle 是规则的运行时标识,可用于精确删除某条临时规则。如果只想查看表名:
sudo nft list tables
假设输出中存在以下内容:
table inet filter
table ip nat
table ip6 filter
这并不表示三个表可以互相替代。table ip nat 主要服务于 IPv4 的地址转换路径,不能用来代替 IPv4/IPv6 入站过滤;table ip6 filter 只处理 IPv6;table inet filter 可以同时承载 IPv4 和 IPv6 的过滤链。
不要只执行:
sudo nft list chain input
nftables 的链必须通过协议族、表名和链名定位。常见查询方式如下:
sudo nft list table inet filter
sudo nft -a list chain inet filter input
sudo nft -a list chain inet filter forward
sudo nft -a list chain inet filter output
如果实际规则在 table ip filter,则应查询:
sudo nft -a list chain ip filter input
如果命令返回类似“没有此文件或目录”,含义通常是给出的协议族、表名或链名不存在,并不等于整台服务器没有 nftables 规则。应回到 nft list ruleset -a,确认真实名称。
还要区分基础链和普通用户链。只有带有类似以下属性的链,才会直接挂到内核数据包路径:
type filter hook input priority filter; policy drop;
普通链可能只是一组被其他链调用的规则。如果配置了一个名为 allow_web 的普通链,但 input 链没有 jump allow_web 或其他调用关系,那么 allow_web 中的放行规则不会自动执行。
访问运行在本机上的 Web、数据库或 SSH 服务,通常经过 input 链。一个简化路径可以表示为:
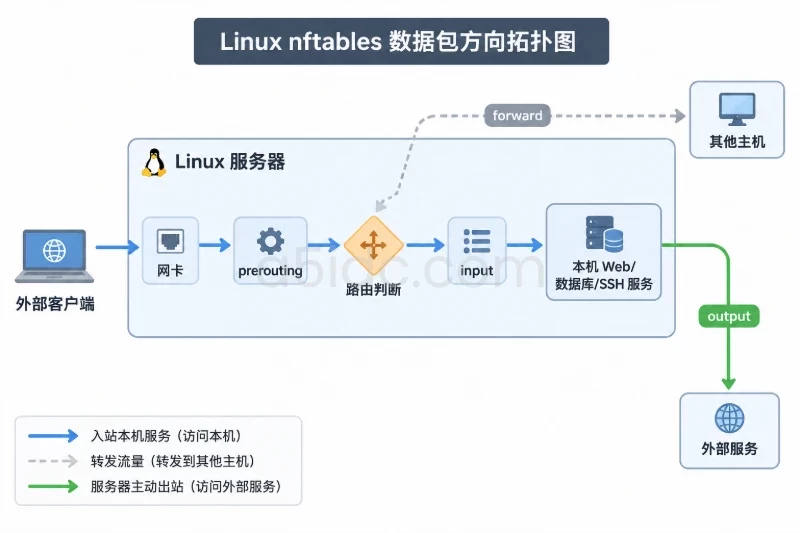
外部数据包
  -> 网卡
  -> prerouting
  -> 路由判断
  -> input
  -> 本机监听进程
如果规则写在 forward 链,而目标服务就在这台服务器上,通常不会达到预期效果。反过来,如果这台新加坡服务器承担路由、网关或容器转发功能,转发流量主要经过 forward 链,不应只检查 input。
可以先根据连接方向判断:
input;output;forward;prerouting 中的 NAT 规则,以及转换后的目标地址和端口。下面三种写法的覆盖范围不同:
table ip filter
table ip6 filter
table inet filter
如果规则是:
table ip filter {
    chain input {
        type filter hook input priority filter;
        policy drop;
        tcp dport 443 accept
    }
}
它只对 IPv4 生效。通过 IPv6 访问时,即使 TCP 端口同样是 443,也不会命中这张 ip 表。
如果希望在同一张表中处理两种 IP 协议,可以使用 inet:
table inet filter {
    chain input {
        type filter hook input priority filter;
        policy drop;
        tcp dport { 80, 443 } accept
    }
}
不过,inet 并不意味着所有条件都自动兼容。使用源地址时,IPv4 应匹配 ip saddr,IPv6 应匹配 ip6 saddr。只写了 IPv4 地址条件的规则,不会匹配 IPv6 客户端。
例如,下面的规则属于 output 链:
tcp dport 443 drop
它影响服务器主动建立的 TCP 连接,不会阻止外部客户端访问服务器的 443 端口。若问题是外部请求访问本机服务,应该检查 input 链;若问题是服务无法调用外部 API,再检查 output 链。
下面是一个常见的基础链:
chain input {
    type filter hook input priority filter; policy drop;
    ct state established,related accept
    iifname "lo" accept
    tcp dport 443 accept
}
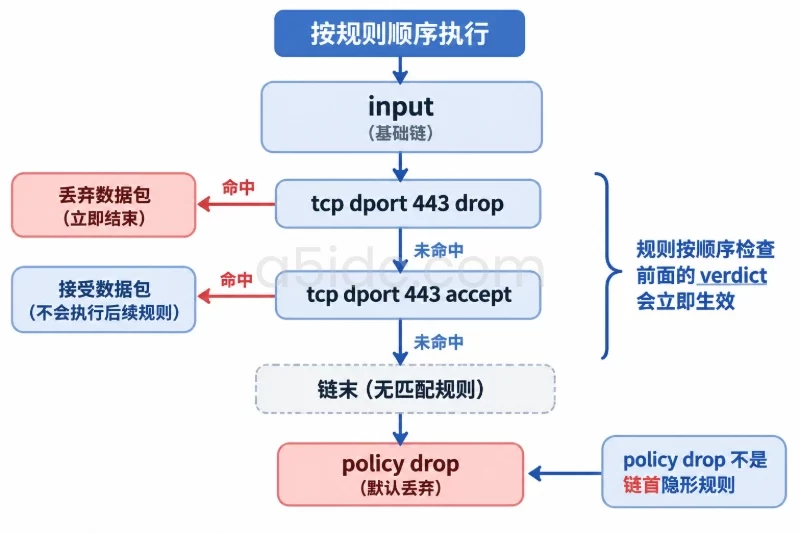
policy drop 的含义是:数据包执行完这条基础链中的规则,仍没有得到明确允许结果时,最后按丢弃处理。它不是一条排在所有规则之前的隐形 drop。
因此,规则放在 policy drop 的基础链中并不一定有问题,关键是放行规则必须在链中执行到,并且前面没有更早的丢弃规则。例如:
chain input {
    type filter hook input priority filter; policy drop;
    tcp dport 443 drop
    tcp dport 443 accept
}
这里的 accept 永远不会执行,因为同样条件的请求已经被前一条规则丢弃。
使用以下命令查看规则顺序和句柄:
sudo nft -a list chain inet filter input
示例输出如下,属于说明性数据:
chain input {
    type filter hook input priority filter; policy drop;
    ct state established,related counter packets 18 bytes 2160 accept # handle 5
    tcp dport 443 counter packets 0 bytes 0 accept # handle 9
}
如果目标规则带有 counter,可以通过计数变化判断它是否被命中。若规则没有配置计数器,不能仅凭“没有看到计数”判断规则没有执行。
许多配置会把以下规则放在前面:
ct state established,related accept
这意味着已经建立的连接会直接放行。修改后测试时,如果继续使用浏览器连接池、长连接或复用的 TCP 连接,可能看不到新规则的效果。验证放行或拒绝规则时,应关闭旧连接,再建立一个新的连接。
反过来,如果要测试阻断规则,不能只观察一条已经建立的连接是否还能传输数据。应让客户端重新发起连接,并结合抓包和规则计数器判断。
一张表中可能存在多个基础链,甚至不同表中也可能同时挂载到 input。例如:
table inet filter {
    chain input {
        type filter hook input priority filter; policy drop;
        ...
    }
}

table inet extra {
    chain input_extra {
        type filter hook input priority 100; policy accept;
        ...
    }
}
规则在一条链中出现 accept,不代表后续所有链一定不会再处理。不同基础链的优先级会影响执行顺序,后续链仍可能给出丢弃结果。因此看到某条规则命中后,仍需检查完整的 nft list ruleset -a,不能只查看一个名为 input 的链。
如果现有规则包含计数器,可以在测试前记录一次输出,发起新连接后再对比:
sudo nft -a list chain inet filter input
判断方式通常是:
必要时可以对已确认的基础链临时加入 trace 标记。此操作会增加诊断输出,应限定测试来源和端口,并在完成后删除:
sudo nft insert rule inet filter input ip saddr 198.51.100.24 tcp dport 443 meta nftrace set 1 comment "temporary-trace"
在另一个终端监听:
sudo nft monitor trace
然后从 198.51.100.24 发起一次新的 IPv4 连接。示例地址必须替换为真实测试源地址。如果目标链前面已有丢弃规则,使用 insert 将诊断规则放在链首通常更容易观察路径;但前提是已经确认 inet filter input 确实存在。
诊断结束后,先重新查看链并记录该临时规则的 handle:
sudo nft -a list chain inet filter input
再按实际句柄删除:
sudo nft delete rule inet filter input handle <临时规则句柄>
不要直接删除整条链,也不要用不确定的句柄。trace 规则只用于短时间定位,不应长期保留在高流量链中。
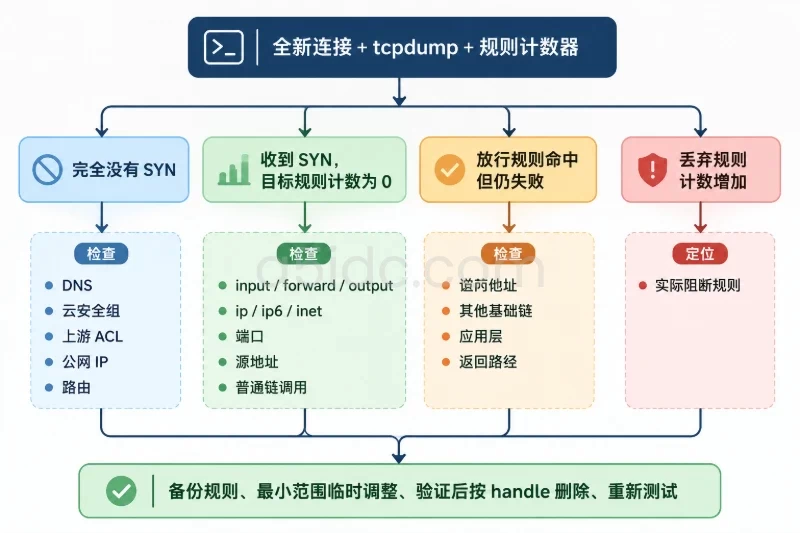
如果 tcpdump 完全看不到来自客户端的 SYN,继续调整本机 nftables 通常没有意义。优先检查:
这类问题的特征是:本机规则计数器不变,抓包也没有数据包。只有当请求确认进入本机后,才进入 nftables 链路排查。
先检查以下项目:
input,而不是 output 或 forward;ip、ip6 或 inet 表;iifname、ip saddr、ip6 saddr 等附加条件是否过于严格;jump 或 goto 调用;drop 或 reject。例如,业务经过上游代理后,本机看到的源地址可能是代理节点地址,而不是最初客户端地址。此时按原始客户端 IP 编写的 ip saddr 规则自然不会命中,应以本机抓包看到的源地址为准,同时评估是否适合按代理来源放行。
如果放行规则的计数器增加,仍然要检查:
127.0.0.1;尤其要注意,某条链中的 accept 不一定能抵消其他基础链后续给出的 drop。完整规则集、抓包和应用日志应结合判断。
这是最常见的配置问题之一。先备份当前运行时规则,再考虑修改:
sudo sh -c 'f="/root/nftables.ruleset.$(date +%F-%H%M%S).nft"; nft list ruleset > "$f"; chmod 600 "$f"; printf "%s\n" "$f"'
备份文件保存的是当前运行时规则,用于回看和紧急恢复,不代表它就是发行版的持久化配置文件。
确认链、端口和来源后,可以先添加一条范围尽量小的临时放行规则。例如,仅允许示例客户端访问 IPv4 的 443 端口:
sudo nft insert rule inet filter input ip saddr 198.51.100.24 tcp dport 443 counter accept comment "temporary-allow"
该命令有以下前提:
inet filter input 已确认存在;198.51.100.24 是实际需要测试的来源地址;添加后立即验证:
sudo nft -a list chain inet filter input
sudo ss -lntup | grep ':443'
再从外部主机建立全新连接。如果问题仍在,说明阻断点可能不在这条链,或者服务、返回路径、上游策略仍有问题。
临时规则验证完成后,通过句柄删除:
sudo nft delete rule inet filter input handle <临时放行规则句柄>
常见持久化文件是:
/etc/nftables.conf
但不同发行版和管理工具可能使用不同路径,不能只凭经验覆盖文件。先确认服务单元和配置来源:
systemctl cat nftables
sudo find /etc -maxdepth 3 -type f \( -name '*nft*' -o -name '*.nft' \) -print
一个简化的 inet 过滤配置示例如下:
table inet filter {
    chain input {
        type filter hook input priority filter;
        policy drop;

        ct state established,related accept
        iifname "lo" accept

        tcp dport { 80, 443 } accept
    }
}
这只是结构示例,不能直接覆盖现有生产规则。尤其是 policy drop 配置下,如果没有提前放行远程管理端口,远程 reload 后可能失去 SSH 访问。业务端口、管理端口、IPv4、IPv6 和源地址范围应按实际需求分别确认。
修改持久化配置后,先做语法检查:
sudo nft -c -f /etc/nftables.conf
检查通过只代表语法和基本语义可解析,不代表规则一定挂在正确的链上,也不代表端口一定可访问。确认无误后,在保留控制台或带外管理通道的前提下执行发行版支持的 reload:
sudo systemctl reload nftables
sudo journalctl -u nftables -n 50 --no-pager
如果系统不支持 reload,不要直接远程执行高风险的 restart。先确认服务文档、控制台访问和回滚文件,再安排维护窗口。restart 可能短暂清理或重建规则,过程中会影响现有连接。
修复后至少做四项验证,而不是只看一次 nft list ruleset:
tcpdump,确认 SYN、SYN-ACK 和后续数据方向;常用复查命令如下:
sudo nft list ruleset -a
sudo ss -lntup
sudo journalctl -u nftables --since "10 minutes ago" --no-pager
如果规则计数器在 reload 后归零,不一定是规则失效,可能只是规则被重新加载。应记录 reload 时间,再观察新连接产生的增量。对于高流量端口,不建议长期打开详细 trace;可以保留必要的计数器,或使用低频率日志规则,并限制来源、接口和速率,避免诊断本身制造额外负载。
最后还要验证运行时配置与持久化配置是否一致。运行时临时添加的规则在重启、服务 reload 或管理工具刷新后可能消失;配置文件中的规则如果没有被正确加载,也可能只在本次运行中有效。完成维护后,在可控窗口内再次检查服务单元、配置语法和外部连接结果,确保新加坡服务器重启或防火墙服务重新加载后,链、表、默认策略和端口访问仍保持预期。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/8982.html