香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


看到服务器有两颗 CPU,却只显示一个 NUMA 节点,并不一定是故障;反过来,看到多个 NUMA 节点,也不代表每个节点都对应一颗物理 CPU。NUMA 拓扑描述的是处理器与本地内存之间的访问关系,不能仅凭 CPU 插槽数量、核心数或内存条数量推断。要确认 CPU 核心与内存节点的对应关系,应结合操作系统看到的拓扑、节点内存信息和进程实际的内存分布一起判断。
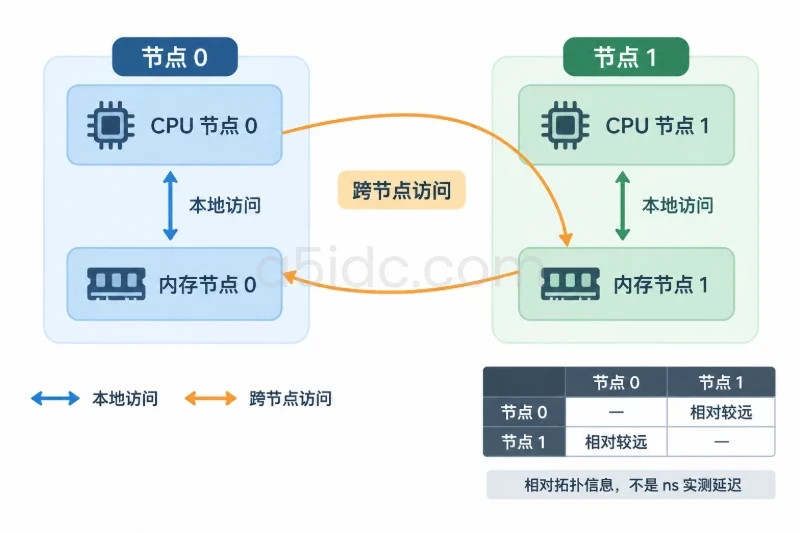
NUMA 是“非统一内存访问”的简称。在 NUMA 服务器上,处理器访问与自己连接较近的内存通常延迟更低、带宽条件也更有利;访问其他处理器连接的内存,则需要通过处理器间互连等路径。这里的“本地”和“远端”是相对于某个 CPU 所属的内存节点而言,不是指内存条在机箱中的左侧或右侧。
在 Linux 中,NUMA 节点通常以 node0、node1 等形式呈现。一个节点可以包含若干逻辑 CPU,并关联一部分可用内存。但这些对应关系不是简单的一对一:
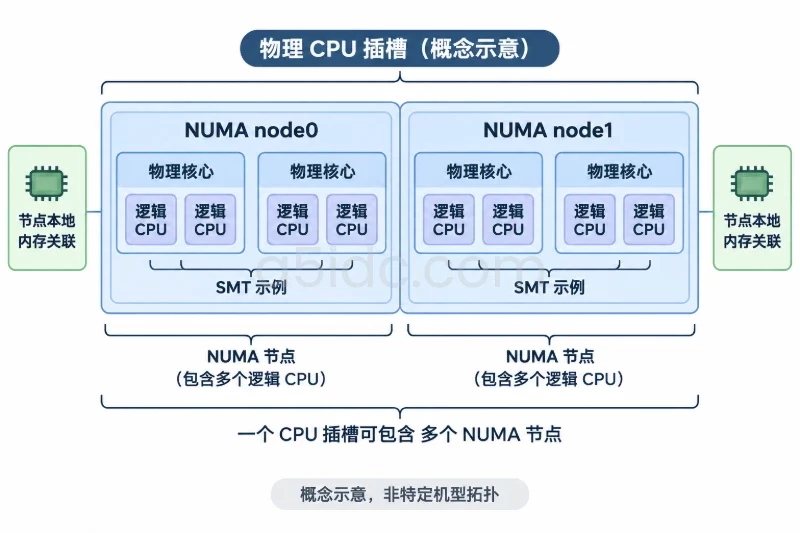
因此,确认“CPU 核心与内存节点对应关系”至少要分成两个问题:哪些逻辑 CPU 属于哪个 NUMA 节点;系统为这些节点识别到了多少内存。若还要确定具体内存条的物理位置,则需要额外查看固件、硬件管理工具或主板标识。
操作系统主要看到的是逻辑 CPU。以一颗处理器包含 16 个物理核心、每个核心提供 2 个硬件线程为例,系统可能显示 32 个逻辑 CPU。这里的 32 不能直接理解为 32 个物理核心。
NUMA 拓扑可以近似理解为一张映射表:
| 层级 | 含义 | 常见核对信息 |
|---|---|---|
| 逻辑 CPU | 操作系统可调度的处理器执行单元 | CPU 编号、在线状态 |
| 物理核心 | 一个或多个硬件线程所在的核心 | CORE、核心编号 |
| CPU 插槽 | 物理处理器封装所在位置 | SOCKET、SOCKET 编号 |
| NUMA 节点 | 一组逻辑 CPU 与其本地内存的关联单元 | NODE、节点 CPU 列表、节点内存 |
逻辑 CPU 编号通常只是系统枚举编号,不保证按插槽、核心或节点顺序连续排列。不能看到 CPU 0 到 CPU 15 就认定它们属于同一颗处理器,也不能仅凭编号大小推断物理位置。
一些处理器会在一个插槽内进一步划分 NUMA 域。这样做可能与处理器内部互连结构、固件设置或处理器提供的 NUMA 配置模式有关。因此,“两颗插槽等于两个节点”只是某些配置下的结果,不是通用规则。
针对数据库、容器及多任务计算等对处理器与内存访问关系较敏感的业务,A5idc数据提供香港、美国、日本等地区的物理服务器,覆盖Xeon Gold、AMD EPYC单路与双路平台,并配备不同容量的内存和SSD、NVMe存储资源,为NUMA架构下的计算部署提供多样化硬件基础。
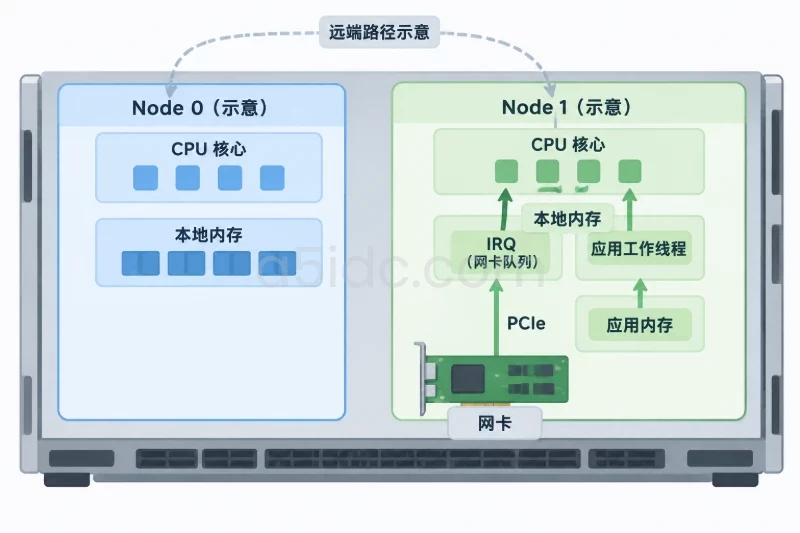
NUMA 的关键是 CPU 执行位置与内存分配位置是否匹配。若线程运行在 node0 的 CPU 上,而它频繁访问的内存页分配在 node0,通常属于本地访问;若这些页分配在 node1,则可能需要远端访问。远端访问的代价取决于处理器平台、节点间路径、负载和访问模式,不能用一个固定延迟值概括所有服务器。
内存页最初分配的位置,常受“首次触碰”机制影响:程序首次写入或以特定方式访问尚未分配的内存页时,操作系统可能倾向于从当前 CPU 所属节点分配页面。这是常见行为,但实际结果还会受内存策略、进程或容器的 CPU 与内存限制、系统负载以及自动 NUMA 平衡等机制影响。
由此可能出现两种容易混淆的情况:
NUMA 信息适合用来判断本地与远端资源的关系,不能单独证明某个性能问题一定由远端访问造成。
先用 lscpu 查看系统整体拓扑:
lscpu
重点关注 CPU(s)、Thread(s) per core、Core(s) per socket、Socket(s)、NUMA node(s) 等字段。字段名称会随 lscpu 版本和平台而变化;若未显示 NUMA 节点细节,可尝试输出逐 CPU 信息:
lscpu -e=CPU,CORE,SOCKET,NODE,ONLINE
示例结果如下,数字仅用于说明读取方法:
CPU CORE SOCKET NODE ONLINE
  0    0      0    0    yes
  1    0      0    0    yes
  2    1      0    0    yes
  3    1      0    0    yes
 16    0      0    1    yes
 17    0      0    1    yes
 32    0      1    2    yes
 33    0      1    2    yes
这组示例中,CPU 0 和 CPU 1 的 CORE 与 SOCKET 相同,说明它们被报告为同一插槽中的同一个核心的两个逻辑 CPU;它们的 NODE 都是 0,表示这两个逻辑 CPU 被映射到节点 0。CPU 16、17 虽然也显示在插槽 0,但属于节点 1,说明一个插槽可以包含多个 NUMA 节点。实际系统的编号和列值可能完全不同。
如果当前 lscpu 不支持上述列名,可先查看可用列:
lscpu --help
还可以直接查看内核导出的节点 CPU 列表和节点内存信息:
for d in /sys/devices/system/node/node[0-9]*; do
    [ -d "$d" ] || continue
    echo "[$d]"
    printf "cpulist: "
    cat "$d/cpulist"
    grep -E 'MemTotal|MemFree' "$d/meminfo"
done
其中 cpulist 会列出该节点关联的逻辑 CPU,可能以范围形式展示,例如 0-15,32-47。MemTotal 是系统识别到的该节点总内存,MemFree 则是采样时的空闲量,后者会随运行状态变化。若某个节点存在但 CPU 列表为空,或者内存信息为零,应进一步核对其他节点信息、固件设置和虚拟机配置,不能只据此判断硬件异常。
也可以使用 numactl 查看节点和节点间距离:
numactl --hardware
示例输出可能包含:
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 3
node 0 size: 32768 MB
node 1 cpus: 4 5 6 7
node 1 size: 32768 MB
node distances:
node   0   1
  0:  10  21
  1:  21  10
node distances 中的数值是内核提供的相对距离信息,不应直接当作纳秒延迟。示例里本地距离 10、节点间距离 21,表达的是节点之间的相对远近关系;不同平台的数值及含义应结合系统实现理解。若没有 numactl,可以先用前面的 lscpu 和 /sys 信息完成基本映射。
系统拓扑回答的是“资源如何归属”,不等于“某个进程实际上用了哪些资源”。查看进程的 NUMA 内存分布,可以使用:
numastat -p <PID>
将 <PID> 替换为目标进程号。输出通常按节点列出该进程的内存页分布;不同版本的字段和格式可能有所区别。若系统提供 /proc 信息,也可以查看:
cat /proc/<PID>/numa_maps
该文件内容通常按内存映射区域列出页面分布及相关策略信息。它更偏向诊断用途,输出较长,不能把某一行简单当作整个进程的完整内存统计。
例如,应用的线程主要在节点 0 上运行,但进程的大部分内存页集中在节点 1,这提示可能存在 CPU 与内存位置不匹配。不过还要检查进程实际线程调度位置、内存策略、运行时迁移情况和采样时点。对于持续运行的服务,建议在具有代表性的负载期间重复观察,而不是根据空闲时的一次结果作结论。
如果进程运行在容器或受限服务中,还需核对其 CPU 与内存节点允许范围。宿主机可见的节点,不一定都对容器开放;容器内显示的拓扑也可能受到运行时、虚拟化层或资源控制配置影响。查看进程可用的 CPU、节点范围时,应使用与实际部署环境相符的控制组和容器配置检查方法。
同一台服务器在不同固件或软件配置下,操作系统看到的 NUMA 拓扑可能不同。排查时可按以下因素逐一核对:
ONLINE 状态以及节点内存,而不是只统计 CPU 编号。若 lscpu、numactl 和 /sys/devices/system/node/ 的结果不一致,先检查工具版本、权限、容器或虚拟机边界,再确认内核识别到的节点列表。不要因单个工具输出异常就直接调整固件或启动参数。
节点数不等于插槽数。 一颗处理器可以对应多个 NUMA 节点;多颗处理器也可能由固件或虚拟化配置呈现为其他分组。应以系统实际报告的 CPU 与节点映射为准。
节点编号不表示物理顺序。 node0 不一定就是机箱中最靠近 CPU 0 的内存区域,编号也可能随启动和拓扑枚举方式变化。编号适合在同一次系统环境中关联信息,不适合单独用于标记物理位置。
节点内存总量不等于可分配余量。 MemTotal 反映系统识别到的容量,MemFree 是动态值;实际可用空间还可能受到保留区域、系统占用、内存策略和资源限制影响。多个节点容量不均衡也不必然表示故障,但应结合 DIMM 安装规则及业务的分配需求核对。
拓扑信息不能直接推出性能结论。 即使 CPU 和内存分属不同节点,也不代表应用一定会受明显影响。访问模式、线程调度、内存带宽、工作集大小和业务负载都会改变结果。要判定性能问题,应将拓扑数据与进程分布及实际负载下的性能指标结合。
操作系统映射不等同于物理插槽定位。 如果要确认某根内存条对应哪个插槽,需要结合服务器固件、硬件管理界面、厂商工具或机箱标识。通用 Linux 的 NUMA 节点信息通常不足以完成这一步。
可靠的核对顺序是:先用 lscpu -e 建立“逻辑 CPU—核心—插槽—节点”映射,再用节点 cpulist 和 meminfo 确认每个节点关联的 CPU 与内存,随后在目标业务运行期间查看进程的 CPU 位置和 NUMA 内存分布。若这些信息相互吻合,可以据此判断系统可见的 NUMA 关系;若节点数、内存分布或进程使用情况与预期不符,则继续核对固件、内存安装、虚拟化和资源限制。实际判断应以系统当前呈现的拓扑为边界,不能仅凭插槽数量或节点编号推断物理布局与性能。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/8512.html