香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


GPU0不一定对应NUMA 0,GPU编号也不能代表它在主板上的插槽顺序。要判断GPU与NUMA节点的对应关系,应先用PCI总线地址唯一标识设备,再对照GPU拓扑、Linux设备的NUMA属性和CPU节点信息;若还要确认物理插槽,则需结合PCIe设备树及服务器固件或硬件资料。
这里的“对应”通常指设备在PCIe和处理器互连拓扑中的本地性:GPU更靠近哪个NUMA节点,以及CPU和内存访问它时大致经过什么路径。这能帮助判断进程和内存是否放在合适的位置,但单凭一个NUMA编号,不能推断GPU之间的互联方式、实际带宽或当前性能。
GPU的管理工具常显示GPU 0、GPU 1等逻辑编号。编号可能随驱动、设备枚举顺序或系统配置变化,适合在当前环境中引用设备,不适合作为跨重启或跨机器的物理标识。PCI总线地址(BDF,包含域、总线、设备和功能号)通常更适合将管理工具中的GPU与Linux设备路径对应起来;GPU UUID也可用于稳定识别设备,但不能直接说明其NUMA归属。
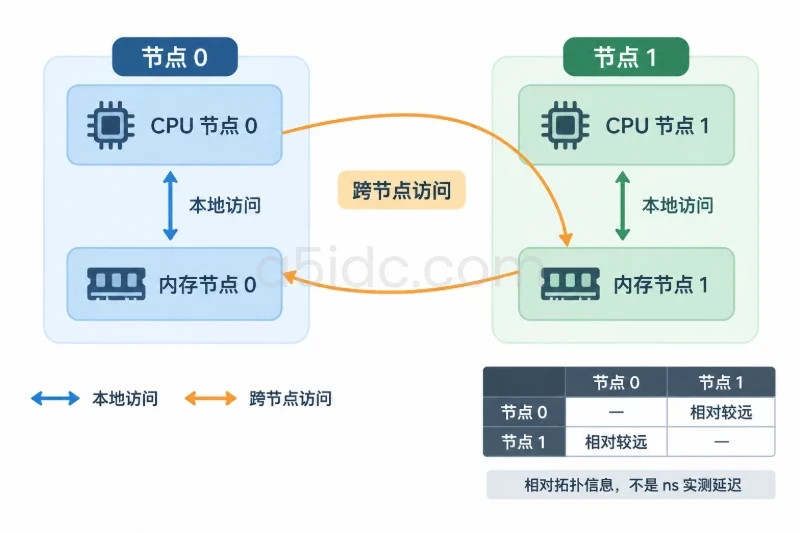
NUMA节点是操作系统呈现的处理器与本地内存组织单元。多路服务器通常有多个节点,但“一个插槽就是一个NUMA节点”并不总成立:某些平台会在一个处理器插槽内划分多个NUMA节点,也可能通过固件设置改变操作系统看到的节点布局。因此,不能仅凭CPU插槽数推断节点数,也不要把NUMA 0理解为“物理上第一个插槽”。
还要把三类信息分开看:
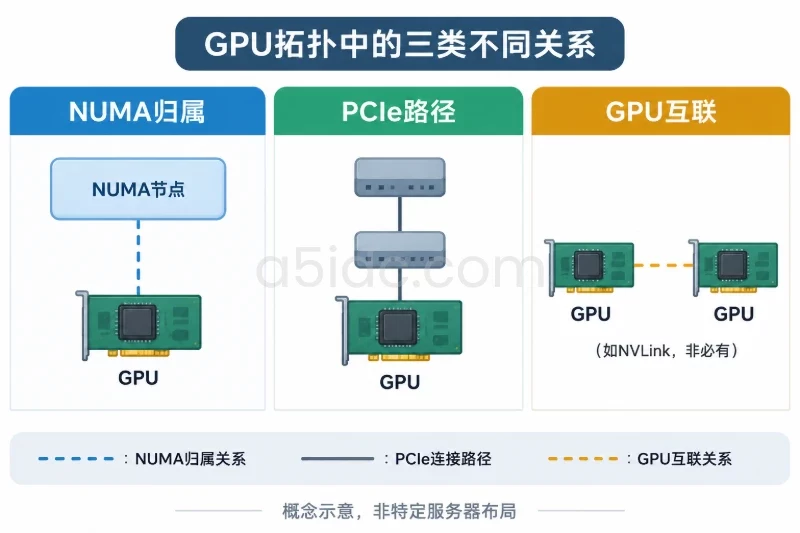
它们相关但不等价。两块GPU可能位于同一NUMA节点,却通过不同PCIe交换路径连接;GPU之间存在高速互联,也不代表它们属于不同或相同的CPU节点。
GPU通常作为PCIe设备枚举。内核能够读取设备所在总线及其父级桥接结构;在平台提供相应信息时,还会通过PCI设备的numa_node属性报告本地NUMA节点。GPU厂商工具则可能在此基础上汇总设备间的连接路径、CPU亲和性和NUMA亲和性。
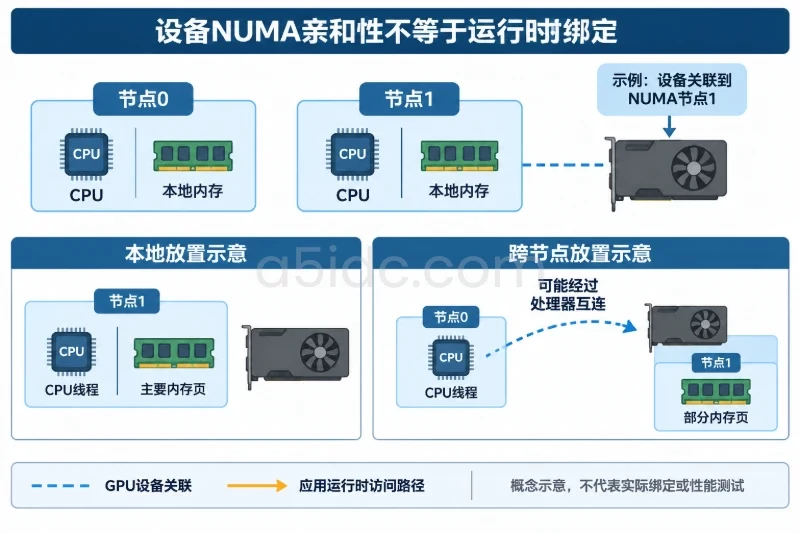
这种映射的实用价值在于数据访问路径。若某进程使用GPU 0,却将CPU线程和主要内存页放在另一个NUMA节点,数据可能需要跨处理器互连访问,增加延迟并占用互连带宽。对于持续传输大量数据的任务,这种位置不匹配可能影响吞吐;但结果还取决于GPU负载、PCIe代际和通道宽度、内存分配、驱动、通信库及应用自身的访问方式。
NUMA亲和性是定位线索,不是性能保证。即使GPU被关联到节点1,进程也可能在节点0运行,内存页也可能分配在节点0;反过来,CPU线程在节点1运行,也不意味着所有内存都来自节点1。要判断实际运行时是否本地,还需观察进程的CPU绑定和内存策略,不能只看设备属性。
设备与节点的映射可能受以下因素影响:
因此,遇到numa_node为-1、厂商工具显示N/A,或容器内可见信息不完整时,应先把结果视为“当前环境无法给出明确映射”,而不是把它解释为NUMA节点-1或设备没有连接。
以下命令以Linux物理机为例,主要用于读取设备信息,不会修改系统配置。执行前确认当前是在宿主机还是容器、虚拟机中;如果是在容器或来宾系统中,结论仅适用于其可见拓扑。
安装了NVIDIA驱动的系统可使用:
nvidia-smi --query-gpu=index,uuid,pci.bus_id,name --format=csv
示例输出:
index, uuid, pci.bus_id, name
0, GPU-aaaa..., 00000000:65:00.0, Example GPU
1, GPU-bbbb..., 00000000:ca:00.0, Example GPU
记录每块GPU的pci.bus_id。之后应优先用它与Linux PCI设备对应,而不是假定GPU 0就是总线地址较小的设备,或就是NUMA 0上的设备。不同工具对PCI域的显示位数可能不同,例如管理工具显示8位域,Linux sysfs路径使用4位域;匹配时应核对完整的域、总线、设备和功能号,不要只比较总线号。
NVIDIA环境中可运行:
nvidia-smi topo -m
示例输出:
        GPU0    GPU1    CPU Affinity    NUMA Affinity
GPU0     X      NV4     0-15            0
GPU1    NV4      X      16-31           1
表中内容是示例,具体字段和取值取决于设备与驱动。阅读时注意:
CPU Affinity表示工具报告的相关CPU范围,不等于进程已经绑定到这些CPU。NUMA Affinity表示工具报告的节点亲和性,需与Linux sysfs和CPU节点信息交叉验证。NV#表示GPU间存在相应的NVLink连接;它描述GPU互联,不是NUMA节点编号。PIX、PXB、PHB、NODE和SYS。它们大致区分路径经过单个PCIe交换芯片、多个交换芯片、主桥、同一节点内的路径,或跨NUMA节点的系统互连。具体含义和显示形式应以当前驱动工具的说明为准。如果输出显示GPU0与GPU1之间为NV4,同时两者各自的NUMA Affinity不同,这并不矛盾:前者描述GPU间互联,后者描述各GPU与CPU内存拓扑的关联。
先将管理工具输出的PCI地址换成对应的Linux设备路径。以下用GPU的PCI地址0000:65:00.0作为示例:
GPU_BDF=0000:65:00.0

cat "/sys/bus/pci/devices/$GPU_BDF/numa_node"
readlink -f "/sys/bus/pci/devices/$GPU_BDF"
如果numa_node返回0或1等非负整数,表示内核为该PCI设备报告了相应的NUMA节点。若返回-1,则表示当前内核或平台没有提供可用的节点关联信息,不能据此判定设备“没有NUMA归属”。
可以继续查看设备附近的CPU列表(文件存在时):
cat "/sys/bus/pci/devices/$GPU_BDF/local_cpulist"
local_cpulist通常以CPU编号范围表示本地CPU,例如16-31。如果文件不存在或不可读,不要把它当作映射错误;可改用厂商工具的亲和性输出,并结合下方的CPU节点信息核查。
使用numactl时,可查看节点、CPU和内存概况:
numactl --hardware
示例输出:
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 3 4 5 6 7
node 1 cpus: 8 9 10 11 12 13 14 15
node distances:
node   0   1
  0:  10  20
  1:  20  10
节点距离矩阵用于表示相对访问距离,数值不是带宽,也不应脱离系统拓扑直接换算成延迟。此示例中两个节点的本地距离为10、跨节点为20,只能说明跨节点访问代价相对更高,不能据此断定实际应用性能降低了某个固定比例。
还可用lscpu查看CPU、核心、插槽和节点之间的关系:
lscpu -e=CPU,NODE,SOCKET,CORE
如果GPU的numa_node为1,而节点1的CPU列表包含8至15,则可判断GPU与这些CPU处于相同的操作系统NUMA节点。不要把逻辑CPU编号直接当作物理核心编号;同一物理核心可能对应多个逻辑CPU。
lspci -D -t
该命令以树形结构展示PCI设备及其上级桥接关系。可将GPU的BDF与树中的设备位置对照,观察它经过哪些PCIe桥接设备。它能帮助理解设备连接路径,但通常不能单独证明机箱内的具体插槽编号。若要把BDF精确对应到主板插槽,应结合服务器的插槽标识、固件信息或硬件文档;设备树中的总线顺序不是机箱槽位顺序。
若需要检查链路协商信息,可先定位GPU后查看详细PCI信息:
lspci -D -s 0000:65:00.0 -vv
关注LnkCap和LnkSta等字段:前者表示设备或链路能力,后者反映当前协商状态。示例中的链路速度和宽度应与具体设备及平台能力对照;单看NUMA映射无法判断链路是否达到预期。对于NVIDIA设备,也可尝试:
nvidia-smi -q -d PCI
不同驱动版本对字段支持可能不同。若命令不支持相关选项,以本机nvidia-smi --help及系统可读的PCI信息为准。
将以上结果按PCI地址对齐后,可以按如下方式解读:
| 核对结果 | 可得出的判断 | 不应直接推出的结论 |
|---|---|---|
GPU的sysfs numa_node为1,CPU列表显示节点1包含一组CPU | 操作系统将该GPU关联到NUMA节点1 | GPU 1、物理插槽1或处理器插槽1 |
| 厂商工具的NUMA Affinity与sysfs节点一致 | 两种视图对该设备的本地节点判断相符 | 应用线程和内存已自动放在该节点 |
| PCIe路径显示跨节点或系统互连路径 | GPU间或设备访问路径涉及更远的拓扑连接 | 所有GPU通信都会跨节点,或性能必然受限 |
sysfs返回-1,厂商工具显示N/A | 当前环境未能提供明确节点关联 | GPU未被系统识别,或设备没有本地性 |
| 容器中的CPU范围与宿主机不同 | 容器可见资源受到限制或隔离 | 宿主机硬件拓扑已经改变 |
例如,若GPU的PCI地址对应到sysfs节点1,lscpu显示节点1有一组CPU,而GPU工具也报告NUMA Affinity为1,便可把“GPU邻近节点1”作为较可靠的拓扑判断。若应用仍在节点0运行,问题就不是GPU映射本身,而是进程CPU和内存的实际放置需要另行检查。反过来,如果sysfs、厂商工具和系统CPU节点信息互相矛盾,应先核对PCI地址是否匹配、运行环境是否为宿主机,以及固件和驱动是否正确呈现拓扑;不要仅凭一项输出下结论。
这套核对方法适用于能直接读取Linux PCI设备和NUMA信息的物理服务器。虚拟机中的PCI直通设备、容器的设备映射、GPU切分实例,以及受限权限下的系统视图,都可能只呈现部分拓扑。此时应区分“来宾或容器可见的拓扑”和“宿主机物理拓扑”,需要物理插槽级结论时,应在宿主机侧核验。
不同GPU厂商和驱动版本提供的拓扑命令及字段并不完全一致。NVIDIA环境可用nvidia-smi topo -m作为便捷视图;其他GPU环境可先查看本机厂商管理工具的帮助信息,再以PCI BDF、sysfs和lspci交叉验证。不要在未确认工具版本时假设某个参数必然存在。
最终判断可遵循一个简单边界:用PCI地址确认是哪块设备,用sysfs和系统CPU列表确认NUMA节点,用设备树和硬件资料确认PCIe路径及物理插槽。若目标是优化应用,还需额外检查进程运行在哪些CPU、内存实际分配到哪些节点,以及设备链路的协商状态;拓扑识别本身只能说明连接关系,不能代替运行时性能验证。
面向GPU计算与物理服务器部署,A5idc数据提供香港、美国GPU服务器,配备A100 80GB或RTX 4090等显卡,并结合服务器CPU、内存和NVMe存储,为AI推理、模型测试及图像处理提供硬件资源。香港产品包含CN2线路配置,美国产品提供三网直连回国或国际带宽方案,可按业务部署地区选择相应的GPU与网络资源。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9672.html