香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


香港 GPU 服务器首次运行 Ollama,先确认两件事:系统能否识别 NVIDIA GPU,以及所选模型在目标量化精度和上下文长度下是否能放进可用显存。香港机房的位置不会改变模型的显存需求;它主要影响服务器访问模型仓库、下载权重以及客户端连接服务的网络条件。
下面以 Ubuntu 22.04/24.04、单台 NVIDIA GPU、原生安装 Ollama 为例,完成环境核对、安装、首次运行和回滚检查。命令输出为预期示例,不代表在特定服务器上的实测结果。若服务器使用其他发行版、AMD GPU、容器或多卡环境,应按相应版本的驱动和部署方式调整。
先通过 SSH 登录服务器,确认系统版本、GPU 型号和驱动状态:
cat /etc/os-release
uname -r
nvidia-smi
nvidia-smi 应能列出 GPU 名称、驱动版本、显存总量和当前使用量。示例:
+-----------------------------------------------------------------------------+
| NVIDIA-SMI ...                 Driver Version: ...                         |
| GPU  Name                 Memory-Usage                                     |
|  0   NVIDIA ...           120MiB / 24576MiB                                |
+-----------------------------------------------------------------------------+
如果提示 nvidia-smi: command not found,或显示无法与驱动通信,先处理 NVIDIA 驱动安装或内核模块问题,不要急着安装 Ollama。服务器的 CUDA Toolkit 是否安装,不是判断 GPU 是否可见的唯一依据;常见原生部署首先要确认驱动可用,并与实际 GPU、系统内核相容。不要仅因没有 nvcc 命令就认定 Ollama 无法调用 GPU。
记录显存总量之外,也要看空闲显存。其他进程、图形桌面或已启动的推理任务都会占用资源,模型能否加载取决于运行时可用显存,而非显卡标称容量。
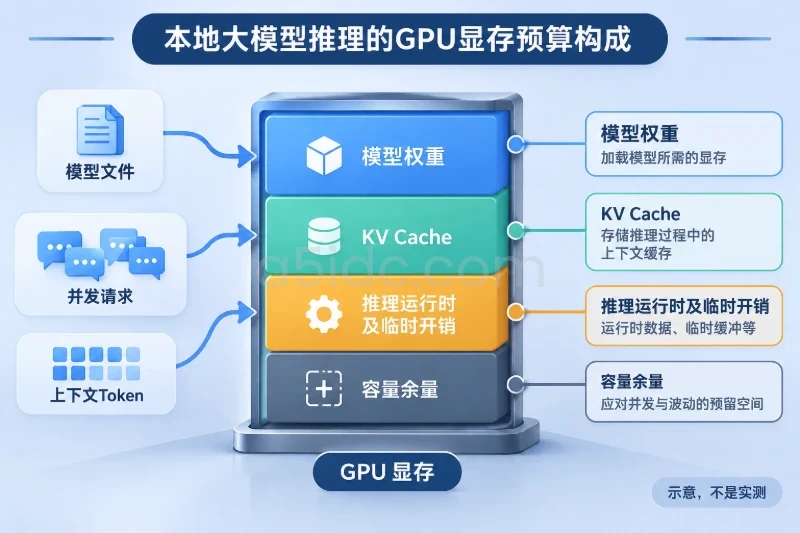
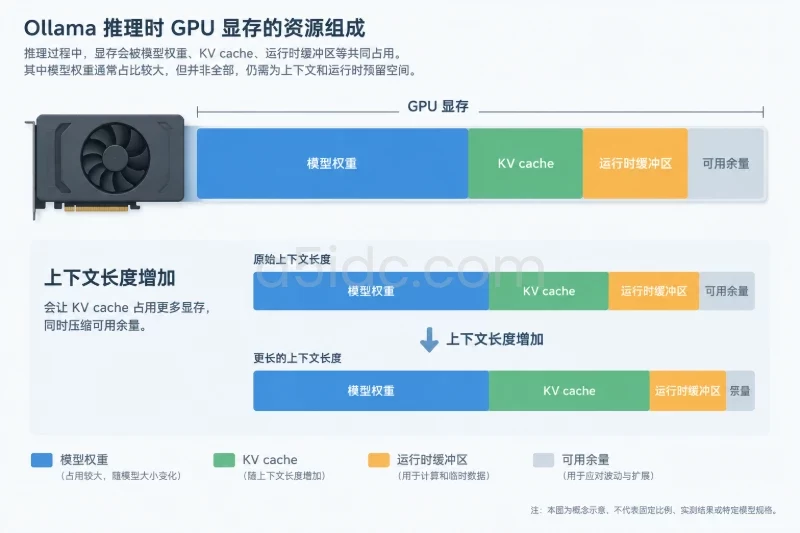
模型参数量不能直接等同于所需显存。量化后的权重通常占用大部分显存,推理时还需要为 KV cache、运行时缓冲区和上下文预留空间。上下文长度增加、并发请求增多时,显存使用也可能上升。下表仅用于初筛,具体占用会随模型架构、量化版本、上下文和 Ollama 版本变化。
| 模型规模示例 | 常见低比特量化下的显存初筛范围 | 选型提示 |
|---|---|---|
| 7B–8B | 约 5–8 GB | 适合在 8 GB 级显存上尝试,但长上下文或其他进程占显存时可能需要更小模型或更短上下文 |
| 14B | 约 10–14 GB | 16 GB 显存通常比 12 GB 更有余量,仍需按模型文件和运行配置核对 |
| 30B–32B | 约 20–28 GB | 24 GB 显存可能紧张;应留意实际量化文件大小和上下文设置 |
| 70B | 约 44 GB 以上 | 通常需要更大显存或多卡方案,单张 48 GB 卡也未必能为长上下文留下充足余量 |
这些范围不是容量保证。对准备使用的具体模型,应查看其 Ollama 模型页面或本地模型信息,核对模型标签、量化文件大小和上下文需求。建议先为运行时及上下文留出数 GB 余量;如果可用显存接近权重文件大小,首次启动就可能失败,或部分计算转到系统内存,导致响应变慢。
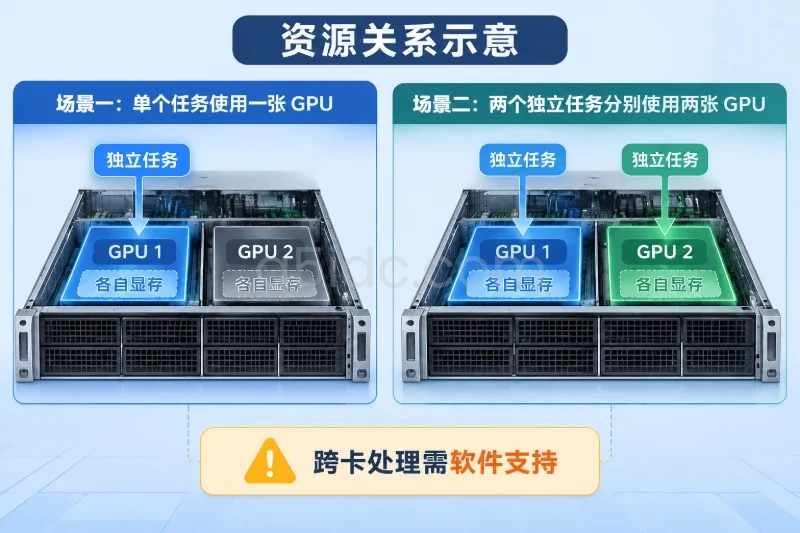
多卡时也不要简单把各卡显存相加后判断必然可用。是否能分配到多张 GPU、如何切分模型,取决于模型、硬件和运行配置;应以实际加载结果和各卡显存变化为准。
模型权重会占用服务器磁盘空间,下载途中也需要临时空间。先检查根分区及数据盘:
df -h
香港服务器需要能够访问 Ollama 安装资源和模型仓库。若下载连接中断,可能需要检查 DNS、出站访问策略、线路质量和剩余磁盘空间。模型下载时长取决于文件大小和实际吞吐,不能仅由服务器所在地区判断。
首次验证只在本机访问 Ollama API,不必把服务端口直接开放到公网。默认本地 API 地址为 127.0.0.1:11434;若要供其他主机调用,应另行评估访问控制、防火墙范围和服务暴露风险,本篇的首次启动步骤不要求修改监听地址。
确认系统满足前述条件后,安装前可先检查安装脚本内容,再执行安装。以下示例使用 Ollama 的安装脚本;若组织有软件来源审查要求,应先按内部流程审核脚本和安装来源。
curl -fsSL https://ollama.com/install.sh -o /tmp/ollama-install.sh
less /tmp/ollama-install.sh
确认后执行:
sudo sh /tmp/ollama-install.sh
预期情况下,安装程序会部署 Ollama 并创建 systemd 服务。检查服务状态:
sudo systemctl status ollama --no-pager
成功时应看到服务处于 active (running)。再确认命令可用:
ollama --version
如果服务未运行,先查看服务日志,不要重复安装或随意改动系统文件:
sudo journalctl -u ollama -n 80 --no-pager
安装成功只说明服务端程序已部署,不代表 GPU 已被 Ollama 使用。接下来还要下载模型并验证推理进程的设备分配。
面向 Ollama 等本地模型推理场景,A5idc数据提供香港和美国 GPU 服务器,配备 A100 80GB 或 RTX 4090 等显卡选项,并搭配服务器 CPU、内存与 NVMe 存储,为 AI 推理和模型运行提供硬件资源。香港 GPU 方案有 CN2 线路配置;美国 GPU 产品则提供不同带宽线路方案,可结合业务部署地区与模型计算需求,承载模型测试、推理服务及相关计算任务。
选择与可用显存匹配的模型标签。下面以 7B 级模型作为命令示例;模型标签和量化选项可能调整,执行前应确认目标仓库中该标签仍可用。若服务器显存不足,应改选更小的模型或适合显存的量化版本,不要直接用大模型验证安装。
ollama pull qwen2.5:7b
下载完成后,列出本机模型:
ollama list
应能看到刚下载的模型及其本地占用信息。然后进行交互式推理:
ollama run qwen2.5:7b
输入一个简短问题,等待模型返回文本;退出交互界面可输入 /bye。首次启动可能需要加载权重,返回时间会受模型大小、磁盘和 GPU 状态影响。
若要控制上下文长度,可以在交互会话中设置参数,例如:
/set parameter num_ctx 4096
设置后再发送一条测试问题。上下文长度不是越大越好:增大它会增加 KV cache 等运行开销。对显存有限的服务器,先用较短上下文完成验证,再按应用需求逐步提高。
另开一个终端,在服务器本机调用生成接口。将 model 设置为已下载的模型标签:
curl -sS http://127.0.0.1:11434/api/generate \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "qwen2.5:7b",
    "prompt": "请用一句话说明显存的作用。",
    "stream": false,
    "options": {
      "num_ctx": 4096
    }
  }'
正常时会返回包含模型名、生成文本和完成状态等字段的 JSON。示例结构如下,具体文本和耗时会不同:
{
  "model": "qwen2.5:7b",
  "response": "显存用于存放 GPU 执行任务时需要访问的数据。",
  "done": true
}
接口返回有效文本说明本地服务和模型推理链路可用,但还不能单独证明推理完全运行在 GPU 上。
推理期间,在另一终端查看 Ollama 当前加载的模型:
ollama ps
重点检查 PROCESSOR 列。若显示主要由 GPU 处理,表示模型运行时有 GPU 分配;若显示 CPU 或 CPU/GPU 混合,则需结合显存、驱动和服务日志排查。不同版本的输出格式可能不同。
同时观察显存变化:
nvidia-smi
在模型加载和生成期间,GPU 显存使用通常会比空闲时增加。对于较小模型,变化可能不明显;因此应结合 ollama ps、nvidia-smi 和实际生成结果判断,而非只依赖单一指标。若 ollama ps 显示 GPU 处理,但显存余量很小,应降低上下文或选择更小的模型,避免后续请求因资源竞争失败。
nvidia-smi 无法识别 GPU这通常发生在安装 Ollama 之前,优先核对驱动是否安装、内核模块是否加载,以及当前内核升级后驱动是否仍可用。先查看系统和驱动错误信息:
sudo journalctl -k -n 100 --no-pager
处理驱动问题时,应使用与发行版和 GPU 相容的驱动安装方式;不要在不了解系统包管理状态时混装多个驱动来源。修复后重新运行 nvidia-smi,确认 GPU 可见,再重启 Ollama 服务:
sudo systemctl restart ollama
先检查磁盘空间和服务日志:
df -h
sudo journalctl -u ollama -n 80 --no-pager
如果磁盘空间不足,先确认哪些目录可清理,再按服务器数据保留策略处理;不要直接删除未知目录或模型文件。若日志表明网络连接失败,核对服务器 DNS、出站访问和到模型仓库的连接情况。下载失败并不必然表示显卡或 Ollama 安装故障。
先确认 GPU 当前剩余显存,并检查是否有其他进程占用:
nvidia-smi
ollama ps
如果模型权重和运行余量超过可用显存,选择更小模型或更低量化占用的标签;也可以先缩短 num_ctx。如果部分运行在 CPU,通常会使推理速度下降。不要通过盲目增加并发或上下文来“测试性能”,应先让单个请求稳定完成,再依据实际资源余量调整。
确认服务状态、端口监听和本地请求:
sudo systemctl status ollama --no-pager
curl -sS http://127.0.0.1:11434/api/tags
如果服务未运行,查看 journalctl 输出;如果服务运行但 /api/tags 无响应,核对本机地址、端口和服务日志。首次部署只需验证本机回环地址,不建议为了排查而直接开放公网访问。
首次部署可按以下条件验收:
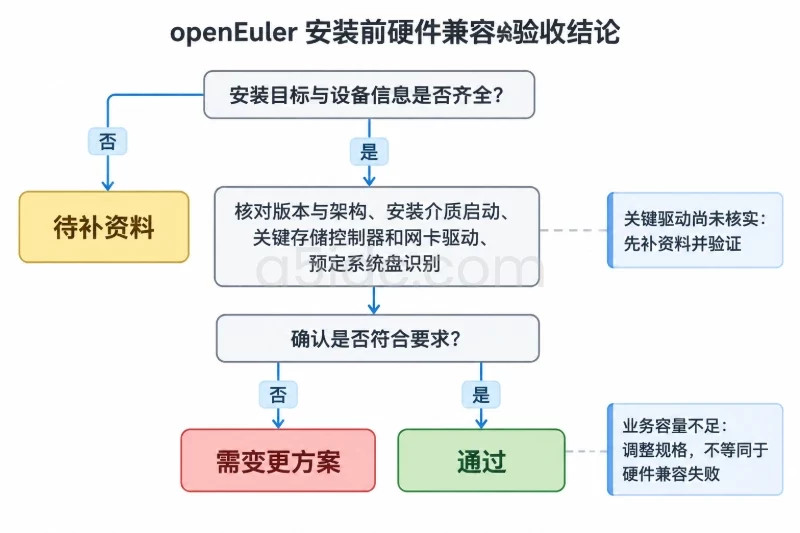
nvidia-smi 能识别目标 GPU,驱动状态正常,显存有可用余量。systemctl status ollama 显示服务正在运行,ollama --version 能返回版本信息。ollama list 能看到目标模型,ollama run 能返回一段有效文本。/api/generate 返回有效 JSON,且 done 状态正常。ollama ps 和 nvidia-smi 核对 GPU 使用情况;如果未使用 GPU,记录为待处理项,不要把“API 有响应”当作 GPU 验收通过。如果首次部署不符合预期,可先停止服务,避免继续占用资源:
sudo systemctl disable --now ollama
这会停止并禁用 Ollama 服务,不会自动删除模型文件。停止前确认当前没有正在执行的推理任务,并记录服务状态及日志。若只需回退本次验证,保留模型和安装文件通常更利于后续排查;若需要彻底卸载,应先确认安装脚本实际创建的服务、二进制文件和模型目录,再按服务器变更流程备份并移除。不要直接删除不确定路径,也不要在未核对数据保留要求时清空模型目录。回滚后再次检查服务状态、磁盘占用和 GPU 进程,确认服务器恢复到预期状态。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/8216.html