香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


回退 containerd 不是简单地把当前二进制替换成旧版本。生产环境中需要同时确认 containerd 与 kubelet、CRI、runc、CNI、内核 cgroup、快照存储、镜像元数据及 systemd 服务配置的关系,并提前确定“回退后必须恢复到什么状态、出现什么现象就停止观察并回滚”。
只有当目标版本的依赖关系已经核对、运行时配置和关键状态具备可恢复的备份、节点业务影响已经被隔离,回退才适合进入执行窗口。服务无法启动、CRI 不可用、节点变为 NotReady、新容器无法创建或镜像解包失败,通常都应作为明确的回滚触发条件,而不能仅以 systemctl status containerd 显示 active 作为成功依据。
A5idc数据提供中国香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器资源,可为承载 containerd、CRI 及容器工作负载的节点提供不同 CPU、内存、NVMe 或机械硬盘配置。面向镜像缓存、数据库、多任务容器和本地状态数据,香港、美国等地的 AMD、Xeon、存储及多带宽线路方案,也能构成与业务区域和运行负载相匹配的基础设施。
同样是 Linux 服务器,containerd 的回退影响可能完全不同:
ctr、上层平台或自研服务管理容器。先记录实际的服务名、配置路径和启动参数,不要直接假设服务一定使用默认路径:
sudo systemctl list-unit-files | grep -E 'containerd|docker'
sudo systemctl status containerd --no-pager
sudo systemctl show containerd \
  -p FragmentPath \
  -p ExecStart \
  -p Environment \
  -p ActiveState \
  -p SubState

containerd --version
runc --version
uname -a
cat /etc/os-release
如果 containerd 服务不存在,或者实际服务名不是 containerd.service,应先根据 systemctl 的结果修正后续操作。不同发行版提供的包名也可能不同,例如 containerd、containerd.io 并不代表完全相同的打包来源,不能混用安装命令。
需要把当前版本、目标版本和周边组件放在同一张变更记录中。建议至少记录以下内容:
| 核对对象 | 需要确认的内容 | 可能的回退影响 |
|---|---|---|
| containerd | 当前精确版本、目标精确版本、安装来源、二进制路径 | 配置项、插件、元数据格式或服务参数不兼容 |
| Kubernetes/kubelet | kubelet 版本、CRI endpoint、节点运行状态 | kubelet 无法连接 CRI,节点变为 NotReady |
| runc | 精确版本、安装来源、cgroup 支持 | 容器启动失败、权限或资源限制异常 |
| Linux 内核 | 内核版本、cgroup v1/v2、overlayfs 或其他快照后端 | 容器创建、资源限制、挂载操作失败 |
| CNI | CNI 配置目录、插件版本、网络命名空间行为 | 新容器无法配置网络,已有业务可能仍暂时可用 |
| snapshotter | overlayfs、devmapper、btrfs 等后端及数据目录 | 旧版本无法读取现有快照或镜像元数据 |
| containerd 配置 | config.toml、CRI 插件、registry、日志和沙箱镜像配置 | 服务能启动但 CRI 或镜像操作不可用 |
在 Kubernetes 节点上,可以补充以下信息:
kubectl get node "$(hostname)" -o wide
kubectl get node "$(hostname)" \
  -o jsonpath='{.status.nodeInfo.containerRuntimeVersion}{"\n"}'

sudo crictl info
sudo crictl ps -a
sudo crictl images

sudo ctr plugins ls | grep -E 'cri|snapshot|runtime'
sudo find /etc/cni -maxdepth 2 -type f -print 2>/dev/null
crictl 如果没有配置 endpoint,可能会提示无法连接或尝试多个默认 socket。此时应查看 /etc/crictl.yaml、kubelet 启动参数和 containerd 的 ExecStart,确认实际使用的 Unix socket,而不是随意改成常见路径。
回退前要特别关注 /var/lib/containerd。其中可能包含内容存储、镜像元数据、容器元数据和快照数据。不同版本之间通常不能仅凭“旧版本曾经运行过”就推断可以安全读取当前状态。
需要确认以下问题:
containerd 数据目录不是数据库备份,也不能替代业务数据库、持久卷或应用层备份。对于有状态业务,应单独确认应用数据的备份和恢复方案。
在正式窗口前,至少保留以下基线:
Ready,节点上有哪些关键 Pod。config.toml、systemd unit 和包管理器记录。示例记录命令如下:
sudo mkdir -p /var/tmp/containerd-baseline

containerd --version \
  | tee /var/tmp/containerd-baseline/containerd-version.txt
runc --version \
  | tee /var/tmp/containerd-baseline/runc-version.txt

sudo systemctl status containerd --no-pager \
  | tee /var/tmp/containerd-baseline/containerd-status.txt
sudo systemctl cat containerd \
  | tee /var/tmp/containerd-baseline/containerd-unit.txt
sudo journalctl -u containerd --since "-2 hours" --no-pager \
  | tee /var/tmp/containerd-baseline/containerd-journal.txt

sudo ctr plugins ls \
  | tee /var/tmp/containerd-baseline/containerd-plugins.txt

dpkg-query -W -f='${Package}\t${Version}\n' 2>/dev/null \
  | grep -E 'containerd|runc' \
  | tee /var/tmp/containerd-baseline/packages.txt || true

rpm -qa 2>/dev/null \
  | grep -E 'containerd|runc' \
  | tee -a /var/tmp/containerd-baseline/packages.txt || true
变更单中应写入完整版本号,而不是“回退到 1.6”或“安装仓库中的旧版本”。至少包含:
目标版本应先在与生产节点相同的发行版、内核、CPU 架构和 cgroup 模式中验证。需要查看目标版本对应的发行说明、发行版依赖关系以及现有 Kubernetes 版本对 CRI 的要求。尤其要区分发行版自带的 containerd 包和其他仓库提供的 containerd.io 包,它们的 systemd unit、默认配置路径和依赖关系可能不同。
不要在执行窗口中临时搜索“可用旧版本”,也不要使用未锁定版本的通配安装。包下载、校验和依赖检查应提前完成,执行时只安装经过审批的精确版本。
配置备份应在停止服务前完成,至少包括 /etc/containerd、systemd unit、环境变量和包信息:
BACKUP="/var/backups/containerd-pre-rollback-$(date +%Y%m%d-%H%M%S)"

sudo install -d -m 0700 "$BACKUP"

if [ -d /etc/containerd ]; then
  sudo cp -a /etc/containerd "$BACKUP/"
fi

sudo systemctl cat containerd > "$BACKUP/containerd.service.txt"
sudo systemctl show containerd > "$BACKUP/containerd.systemd-show.txt"
containerd --version > "$BACKUP/containerd-version.txt"
runc --version > "$BACKUP/runc-version.txt" 2>&1 || true

if [ -f /etc/containerd/config.toml ]; then
  sudo sha256sum /etc/containerd/config.toml \
    | sudo tee "$BACKUP/config.toml.sha256"
fi
不要因为目标版本较旧,就直接用新版本生成的默认配置覆盖现有配置。应先比较配置差异,重点检查:
version 配置格式。sandbox_image 是否仍可访问。SystemdCgroup 设置是否与 kubelet 和 runc 的运行方式一致。只备份配置文件,不能保证 containerd 状态可恢复。对于普通无状态节点,可以在排空后依靠重新拉取镜像恢复;对于本地镜像多、镜像拉取受限或包含重要本地容器数据的节点,应增加存储级恢复点。
优先级通常如下:
/var/lib/containerd 所在文件系统。如果需要制作目录级备份,必须在批准的中断窗口中停止服务,不要在 containerd 正在写入时直接打包数据目录:
sudo systemctl stop containerd

sudo tar --xattrs --acls --numeric-owner \
  -C /var/lib \
  -cpf "$BACKUP/containerd-state.tar" \
  containerd

sudo systemctl start containerd
这段操作可能产生较大的磁盘读写和中断时间,应先估算剩余空间。对于数据目录较大的节点,存储快照通常比在线路中制作压缩包更适合作为回滚锚点。
Kubernetes 节点应先停止继续接收新 Pod。是否执行 drain,要根据副本数、PodDisruptionBudget、DaemonSet、本地存储和有状态组件的策略决定。不能为了完成命令而使用 --force 或强制删除本地数据。
常见的排空前操作为:
kubectl cordon <node-name>
kubectl drain <node-name> \
  --ignore-daemonsets \
  --delete-emptydir-data=false \
  --grace-period=<approved-seconds> \
  --timeout=<approved-duration>
如果 drain 因本地存储、PDB 或特殊 Pod 中断,应由变更负责人判断是否调整业务调度策略,而不是直接跳过保护条件。无法排空的节点仍然可以执行回退,但必须把“节点上现有工作负载可能受到运行时中断影响”列为已确认风险。
独立运行容器的服务器,应明确 containerd 停止期间容器、shim、日志和管理命令的行为。不能将“已有容器可能暂时继续运行”当作可用性保证,执行时应按运行时不可用设计窗口。
进入窗口后,先确认以下事项:
同时重新记录当前版本,避免在等待窗口内发生自动更新:
containerd --version
sudo systemctl is-active containerd
sudo systemctl show containerd -p ExecStart
在停止服务前,保留现场日志:
sudo journalctl -u containerd --since "-30 minutes" --no-pager \
  > "$BACKUP/containerd-before-stop.log"

sudo systemctl stop containerd
sudo systemctl is-active containerd || true
包管理操作必须按实际发行版和包名执行。以下仅表示操作形式,不能直接替代目标服务器的包名和版本:
# Debian/Ubuntu 系列示例:先确认精确版本,再执行
apt-cache policy containerd containerd.io
sudo apt-get install --download-only <package-name>=<exact-target-version>
sudo apt-get install --allow-downgrades <package-name>=<exact-target-version>

# RHEL/Rocky/Alma 等系列示例:先确认仓库中的版本
dnf list --showduplicates <package-name>
sudo dnf downgrade <package-name>-<exact-target-version>
如果包管理器提示要同时降级或删除 runc、CNI、内核相关依赖,不应自动确认。先暂停变更,重新评估依赖范围。containerd 回退不应在未审批的情况下演变为运行时、内核和网络组件的组合变更。
安装完成后,先确认包是否改写了 systemd unit 或配置文件:
sudo systemctl daemon-reload
sudo systemctl show containerd -p ExecStart -p FragmentPath

if [ -f /etc/containerd/config.toml ]; then
  sudo sha256sum /etc/containerd/config.toml
fi
配置未被改写且目标版本能够读取时,优先保留经过验证的现有配置。只有出现明确的配置格式不兼容、插件加载失败或目标版本要求旧格式时,才从备份恢复指定文件。恢复前要保留当前文件副本:
sudo cp -a /etc/containerd/config.toml \
  "$BACKUP/config.toml.after-package"

sudo cp -a "$BACKUP/containerd/config.toml" \
  /etc/containerd/config.toml
不要在发现启动失败后直接删除 /var/lib/containerd,也不要使用 ctr containers rm、清空镜像目录等方式“修复”版本不兼容。这些操作可能破坏后续回滚所需的现场和数据。
启动服务后,先观察服务日志和插件加载情况:
sudo systemctl start containerd
sudo systemctl status containerd --no-pager

sudo journalctl -u containerd -b --no-pager -n 120
sudo ctr version
sudo ctr plugins ls
如果系统仍使用预期的配置和 socket,再继续做 CRI、镜像和业务验证。服务启动成功但 CRI 插件未加载、snapshotter 不可用或 registry 配置失效,都应视为未完成变更,而不是直接恢复调度。
Kubernetes 节点可继续执行:
sudo crictl info
sudo crictl ps -a
sudo crictl images
kubectl get node <node-name> -o wide
建议按照“进程与插件—CRI—节点—容器—镜像—业务”的顺序验证。
| 验证层次 | 验证点 | 通过标准 |
|---|---|---|
| 服务层 | systemd 状态、重启次数、日志 | 服务稳定运行,无持续重启和致命配置错误 |
| 插件层 | CRI、runtime、snapshotter | 需要的插件已加载,无初始化失败 |
| CRI 层 | crictl info、容器列表 | kubelet 能获取运行时信息和容器状态 |
| 节点层 | Node Ready、kubelet 日志 | 节点状态恢复,未出现新的运行时连接错误 |
| 容器层 | 已有容器、指定 canary 重启 | 容器能创建、停止、重启,探针正常 |
| 镜像层 | 已有镜像和一次受控拉取 | 镜像可读取、解包和启动 |
| 网络存储层 | CNI、挂载卷、日志 | 新容器网络和必要挂载正常 |
| 业务层 | 健康检查、错误率、延迟 | 关键业务指标回到基线范围 |
已有容器继续运行并不能证明回退成功,因为它们可能尚未触发新的 CRI 调用、镜像解包或快照创建。至少应在已隔离的 canary 工作负载上执行一次受控重启;如果业务允许,再验证一次新镜像拉取和新容器创建。
在 Kubernetes 环境中,可以检查节点和 Pod:
kubectl get node <node-name>
kubectl get pods -A -o wide --field-selector spec.nodeName=<node-name>
kubectl describe node <node-name>
如果出现以下信息,需要结合时间点判断是否与回退相关:
failed to get sandbox imagefailed to create containerd taskfailed to setup networkfailed to unpack imagerpc errorcontext deadline exceeded观察窗口应覆盖至少一次业务高峰、一次发布周期或一个完整的工作负载重启周期,具体时间按业务 SLO 和节点任务类型确定。可以采用如下记录方式:
只有在所有必要验证点通过后,才执行:
kubectl uncordon <node-name>
恢复调度后仍要继续观察,因为新 Pod 可能在此时才落到该节点。多节点集群建议分批回退,先观察一个节点,再扩展到同一故障域的其他节点,避免一次性改变全部运行时版本。
回滚条件应在执行前写入变更单,并由业务和平台负责人共同确认。以下条件通常足以触发停止观察或立即回退:
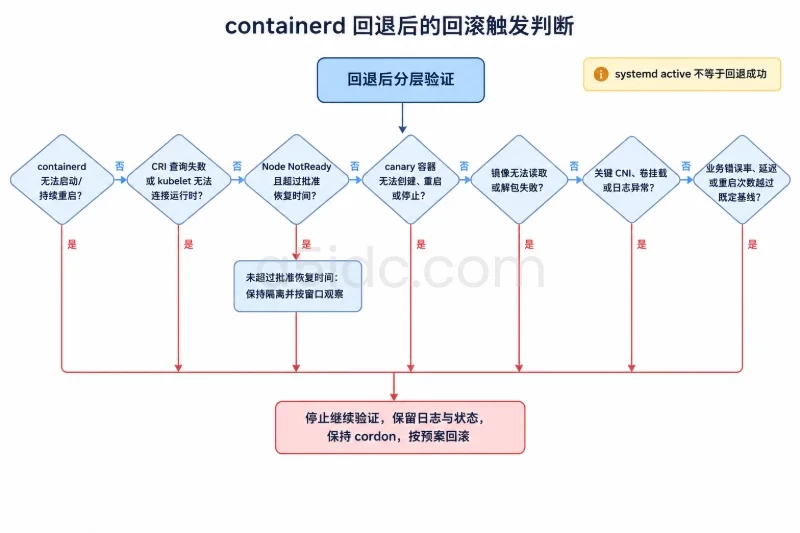
| 触发条件 | 处理判断 |
|---|---|
| containerd 无法启动,或启动后持续重启 | 立即停止继续验证,进入回滚 |
| CRI 查询失败,kubelet 无法连接运行时 | 节点维持 cordon,优先回滚 |
节点进入 NotReady 且在批准的恢复时间内不能恢复 | 回滚,不通过反复重启掩盖问题 |
| canary 容器无法创建、重启或停止 | 回滚前先保留日志和状态信息 |
| 现有镜像无法读取,或新镜像解包失败 | 判断 snapshotter/元数据兼容性,通常回滚 |
| CNI、卷挂载或日志能力异常 | 若影响关键 Pod,立即回滚 |
| 业务错误率、延迟或重启次数超出既定基线 | 按业务阈值执行回滚 |
| 发现需要同时修改 kubelet、runc、内核或 CNI | 暂停当前变更,重新评审,不现场扩展范围 |
其中“业务指标超出基线”不应使用脱离业务的固定数字。可以采用变更前 30 分钟的指标作为基线,并使用已批准的错误率、延迟和恢复时间阈值。例如,变更前业务错误率长期低于约定范围,回退后连续多个采样周期明显升高,且节点侧出现容器创建或运行时错误,就不能仅以服务状态正常为由继续观察。
发生失败后,先保留证据,再执行回滚。不要边改配置、边删除容器、边切换版本,导致故障原因和恢复路径混在一起。
cordon,必要时停止继续向该节点发送业务流量。uncordon。回滚命令的形式仍取决于实际发行版:
sudo systemctl stop containerd

# 按变更单中的原始包名和精确版本执行
sudo apt-get install --allow-downgrades \
  <package-name>=<exact-original-version>

# 或使用已审批的 RPM 包/仓库版本
sudo dnf downgrade <package-name>-<exact-original-version>

sudo systemctl daemon-reload
sudo systemctl start containerd
sudo systemctl status containerd --no-pager
sudo journalctl -u containerd -b --no-pager -n 120
如果错误表现为旧版本无法读取当前 /var/lib/containerd 的元数据,继续卸载、清空目录或重复启动都可能扩大损失。此时应停止服务并恢复存储快照;恢复快照会影响该文件系统上的其他变化,必须按照快照恢复方案执行。
回退完成后,至少再次验证 containerd --version、CRI、Node Ready、canary 容器、镜像读取和关键业务指标。节点即使恢复为 Ready,也应继续观察一个完整的约定窗口;在观察窗口内再次出现服务重启、CRI 错误、容器创建失败、镜像解包失败或业务指标越过既定阈值,应再次触发回滚处置,而不是直接解除节点隔离。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/7662.html