香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


Kubernetes Service连接失败时,不要先假定是DNS或网络策略问题。Service本身通常不监听一个真实进程端口,而是根据选择器找到后端Pod,再将请求转发到targetPort。因此,排查应先确认请求来自哪里、解析到了什么地址、Service是否存在可用Endpoint,随后检查Pod监听、网络策略、节点转发以及外部防火墙和安全组。
最有区分度的现象是错误类型:DNS解析失败通常指向名称或CoreDNS链路;连接被拒绝更接近Pod端口未监听、targetPort错误或应用只绑定了本地回环地址;连接超时则要重点看NetworkPolicy、节点防火墙、安全组、负载均衡健康检查和NAT路径。下面按“症状确认—原因树—逐层排除—根因定位—恢复验证”的顺序处理。
排查前先记录四个条件:
同一个Service从不同位置访问,经过的链路并不相同。集群内访问ClusterIP主要涉及DNS、Service转发、Pod网络和NetworkPolicy;外部访问NodePort或LoadBalancer,还要增加云负载均衡、节点监听、主机防火墙、安全组和NAT等环节。
可以先从调用方执行一次带超时的测试。下面的名称和端口仅为示例,请替换为实际值:
curl -v --connect-timeout 3 --max-time 8 http://api.backend.svc.cluster.local:8080/healthz
对于非HTTP服务,使用TCP测试工具更合适:
nc -vz -w 3 api.backend.svc.cluster.local 8080
如果调用方容器没有curl或nc,应在同一命名空间、相近网络位置启动临时诊断容器,或者使用现有业务Pod执行。临时镜像可能受到仓库访问策略影响,不能因为诊断容器启动失败就判断业务网络异常。
错误信息可以先按下表分类:
| 观察到的现象 | 优先怀疑层级 | 下一步 |
|---|---|---|
Could not resolve host、server misbehaving | DNS、Service名称、CoreDNS | 查询完整域名和CoreDNS状态 |
connection refused | 应用未监听、targetPort错误、端口协议不匹配 | 检查Pod内监听状态和Service端口映射 |
i/o timeout、TCP连接长期无响应 | NetworkPolicy、节点防火墙、安全组、NAT、网络路径 | 对比Pod直连、Service访问和外部访问 |
| HTTP 503或网关提示无可用后端 | Endpoint为空、后端未就绪、负载均衡健康检查失败 | 查看EndpointSlice、readiness状态 |
| 部分请求成功、部分失败 | 某些Endpoint异常、节点路径差异、滚动发布状态 | 逐个验证后端Pod和所在节点 |
| 集群内成功、集群外失败 | NodePort、LoadBalancer、Ingress、外部防火墙或安全组 | 从节点和外部客户端分别测试 |
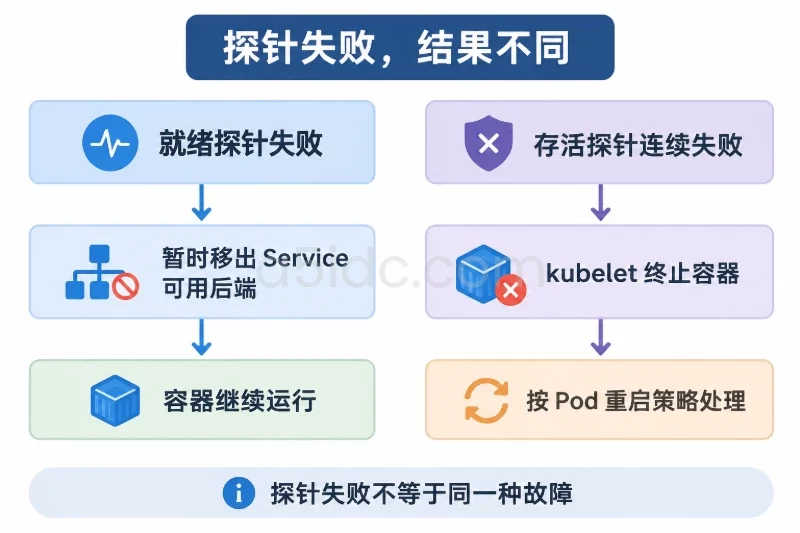
不要只依据“Pod处于Running”判断服务正常。Pod可以处于Running,但应用进程没有监听目标端口;也可以因为readiness探针失败而不被加入Service后端。
可以把问题拆成五个相互独立的分支:
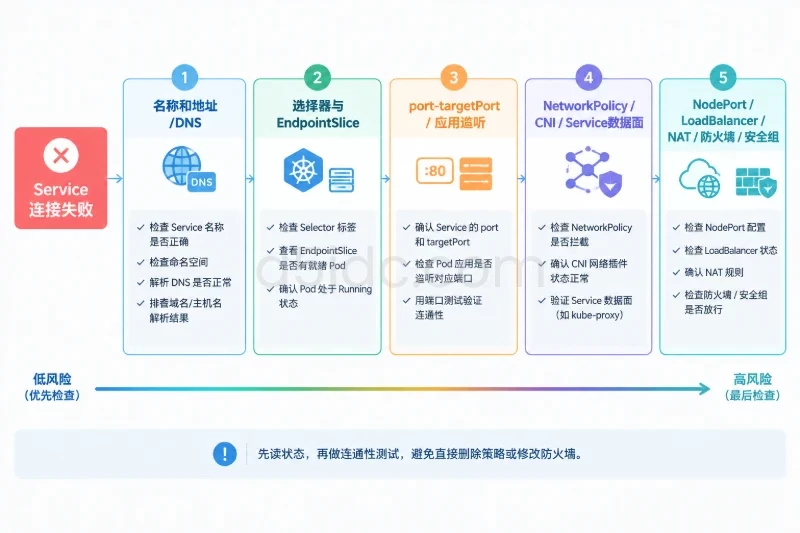
port、targetPort和应用实际监听端口是否一致,应用是否绑定了Pod可达地址。这五个分支应按从低风险、信息量高到改动风险较高的顺序检查。先读取状态和日志,再做端口连通性测试;不要一开始删除NetworkPolicy、重启所有节点或直接修改防火墙规则。
先查看Service的完整定义:
kubectl -n backend get svc api -o wide
kubectl -n backend describe svc api
kubectl -n backend get svc api -o yaml
重点核对以下字段:
spec.selector是否与目标Pod标签完全匹配。spec.ports[].port是客户端访问Service使用的端口。spec.ports[].targetPort是Service转发到Pod的端口,可以是数字,也可以是命名端口。spec.ports[].protocol是否与实际服务一致,TCP和UDP不能混用。ClusterIP、NodePort还是LoadBalancer。externalTrafficPolicy: Local,该配置会影响外部流量在节点上的转发范围。例如,Service配置如下:
apiVersion: v1
kind: Service
meta
  name: api
  namespace: backend
spec:
  selector:
    app: api
  ports:
    - name: http
      port: 8080
      targetPort: http
      protocol: TCP
  type: ClusterIP
此时,Pod必须带有app: api标签,并且容器或应用所在Pod网络命名空间内必须存在名为http、协议为TCP的端口定义。若使用数字端口,则应明确确认实际监听端口,例如targetPort: 9000并不等于容器声明中的containerPort: 9000。containerPort主要用于描述和工具展示,不会自动让应用开始监听端口。
查看Pod标签和状态:
kubectl -n backend get pods -l app=api -o wide --show-labels
kubectl -n backend get pods --show-labels
kubectl -n backend get pods -l app=api \
  -o custom-columns=NAME:.metadata.name,READY:.status.containerStatuses[*].ready,PHASE:.status.phase,IP:.status.podIP,NODE:.spec.nodeName
然后查看EndpointSlice:
kubectl -n backend get endpointslice \
  -l kubernetes.io/service-name=api -o wide

kubectl -n backend describe endpointslice \
  -l kubernetes.io/service-name=api
EndpointSlice比旧版Endpoints对象更适合当前集群中的服务发现检查。需要关注:
addresses中是否有Pod IP。ready: true。如果没有任何Endpoint,优先检查选择器和Pod就绪状态。如果Pod为Running但Ready为False,应查看readiness探针事件和应用日志:
kubectl -n backend describe pod <pod-name>
kubectl -n backend logs <pod-name> --all-containers=true --tail=200
kubectl -n backend get events --sort-by=.lastTimestamp
典型结果及判断方式如下:
确认Endpoint存在后,再检查调用方是否能正确解析Service名称。Kubernetes集群内常见的完整域名格式是:
<service-name>.<namespace>.svc.<cluster-domain>
通常默认集群域名为cluster.local,但实际值可能由集群部署参数改变,不能盲目写死。先从调用方Pod内执行:
kubectl -n frontend exec deploy/frontend -- \
  getent hosts api.backend.svc.cluster.local
如果容器没有getent,可根据镜像中已有工具使用nslookup或dig:
kubectl -n frontend exec deploy/frontend -- \
  nslookup api.backend.svc.cluster.local
解析结果通常应指向Service的ClusterIP,而不是某个Pod IP。然后对照Service信息:
kubectl -n backend get svc api \
  -o jsonpath='{.spec.clusterIP}{"\n"}'
需要分别验证短名称和跨命名空间名称:
kubectl -n backend exec deploy/api-client -- \
  getent hosts api

kubectl -n frontend exec deploy/frontend -- \
  getent hosts api.backend.svc.cluster.local
短名称api通常只在同一命名空间内直接有效。跨命名空间访问时,应使用api.backend或完整域名。
若完整域名也无法解析,检查DNS配置和CoreDNS组件:
kubectl get svc -n kube-system
kubectl get pods -n kube-system -o wide
kubectl -n kube-system logs deploy/coredns --tail=200
不同发行版可能采用不同标签、部署名称或DNS组件名称,因此应先用kubectl get确认资源名称,不要直接套用固定的Deployment名称。还要检查调用方Pod的/etc/resolv.conf是否包含预期的nameserver和搜索域:
kubectl -n frontend exec deploy/frontend -- cat /etc/resolv.conf
DNS正常但访问ClusterIP失败,说明问题已越过名称解析层,应继续检查Endpoint、策略和Service数据面,而不是反复重启CoreDNS。
当结果是connection refused,或者Service已有Endpoint但请求立即失败,应直接确认应用是否在Pod网络命名空间内监听目标端口。
如果业务镜像包含ss,可以执行:
kubectl -n backend exec <pod-name> -- \
  ss -lntp
也可以仅查看指定端口:
kubectl -n backend exec <pod-name> -- \
  sh -c 'ss -lntp 2>/dev/null | grep ":8080 "'
如果镜像没有诊断工具,可使用集群允许的调试容器或在相同Pod内临时加入诊断容器。具体命令依赖Kubernetes版本、容器运行时和安全策略,执行前应确认调试容器不会改变业务进程或生产镜像。
监听结果需要结合绑定地址判断:
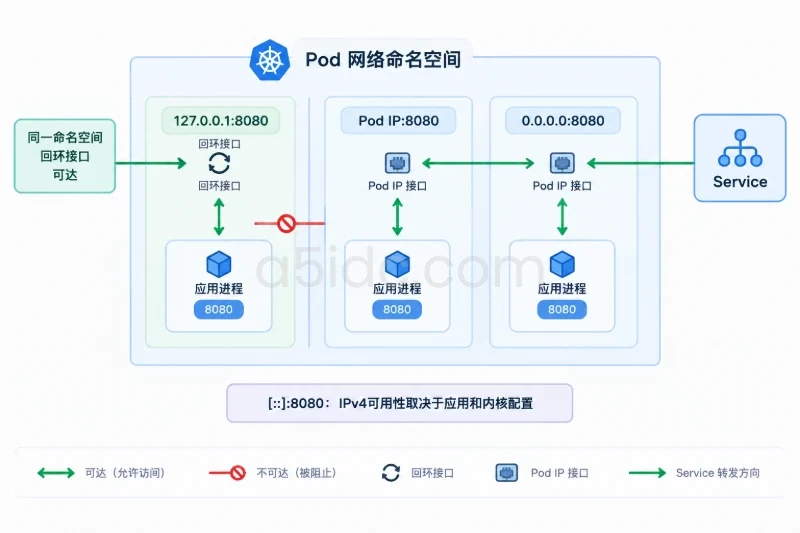
0.0.0.0:8080:通常可接受Pod网卡上的IPv4连接。<PodIP>:8080:通常只接受该Pod IP上的连接,地址必须与当前Pod一致。127.0.0.1:8080:只能由同一网络命名空间内的回环连接访问,Service通过Pod IP转发时通常会失败。[::]:8080:表示IPv6监听,是否同时接受IPv4取决于应用和内核配置,不能仅凭这一行断定IPv4可用。可在Pod内分别测试回环地址和Pod IP:
kubectl -n backend exec <pod-name> -- \
  curl -v --connect-timeout 2 http://127.0.0.1:8080/healthz

kubectl -n backend exec <pod-name> -- \
  curl -v --connect-timeout 2 http://<pod-ip>:8080/healthz
两者结果不同具有较强指向性:
127.0.0.1成功、Pod IP失败:应用绑定地址过窄,需调整应用监听配置。targetPort、Endpoint、NetworkPolicy和Service转发。例如,应用实际监听9000,而Service配置为:
ports:
  - port: 8080
    targetPort: 8080
即使Pod声明了containerPort: 9000,Service仍会尝试连接Pod的8080端口。修复时应让targetPort与应用真实监听端口一致,而不是只修改展示性的containerPort。
如果DNS正常、Endpoint存在、Pod也确实监听端口,但请求超时,应重点检查NetworkPolicy。NetworkPolicy可能同时限制:
查看所有策略:
kubectl get networkpolicy -A
kubectl -n frontend describe networkpolicy
kubectl -n backend describe networkpolicy
NetworkPolicy是叠加生效的。某个Pod一旦被策略选中,相关方向可能进入隔离状态;新增一条允许规则通常是扩大允许集合,而不是覆盖其他策略。因此要同时查看调用方和后端命名空间中的规则。
一个仅用于说明结构的允许规则示例如下:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
meta
  name: allow-frontend-to-api
  namespace: backend
spec:
  podSelector:
    matchLabels:
      app: api
  policyTypes:
    - Ingress
  ingress:
    - from:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: frontend
          podSelector:
            matchLabels:
              app: frontend
      ports:
        - protocol: TCP
          port: 8080
这条规则只表达“允许frontend命名空间中带有app: frontend标签的Pod访问后端8080端口”。如果实际策略还限制了出站流量,还要在调用方命名空间允许访问后端和DNS。命名空间标签、Pod标签及端口必须与现场一致,不能直接复制到生产环境。
如果需要临时调整策略验证,应先保存现有配置并明确影响范围:
kubectl get networkpolicy -A -o yaml > networkpolicy-backup.yaml
生产环境不建议直接删除全部NetworkPolicy作为测试。更安全的做法是在变更窗口中增加最小范围的临时允许规则,限定命名空间、Pod标签和端口,验证完成后按变更记录回滚。回滚前需确认没有依赖该规则的新业务流量。
NetworkPolicy未解释问题时,再检查CNI和Service数据面。不同集群可能由kube-proxy、eBPF数据面或其他实现处理Service流量,不要默认所有集群都存在相同的iptables或IPVS规则。可以先确认节点和系统组件状态:
kubectl get nodes -o wide
kubectl get pods -n kube-system -o wide
kubectl get events -A --sort-by=.lastTimestamp
若只在某个节点上的调用方失败,而其他节点成功,应对比节点路由、CNI组件状态、节点级防火墙和内核日志。直接修改iptables、IPVS或节点网络配置前,必须确认组件管理方式,否则手工规则可能被控制器覆盖,甚至影响同节点上的其他Service。
Service类型决定了外部访问路径,不能把ClusterIP、NodePort和LoadBalancer混为一谈。
ClusterIP主要供集群内部访问。外部主机即使能路由到节点,也不能因此直接访问ClusterIP。需要通过Ingress、LoadBalancer或NodePort等明确的入口暴露服务。
检查Service的节点端口和外部流量策略:
kubectl -n backend get svc api -o wide
kubectl -n backend describe svc api
从集群外部访问NodePort时,至少要确认:
externalTrafficPolicy: Local下,请求到达的节点是否存在本地Ready Endpoint。当externalTrafficPolicy: Local启用时,负载均衡器如果把请求发到没有本地后端的节点,可能出现超时或健康检查失败。此时不能只看集群中“存在后端Pod”,还要核对后端是否位于接收流量的节点。
LoadBalancer地址能解析,不代表后端端口可用。云负载均衡器通常会从指定探测地址访问节点或Pod;健康检查端口、协议、路径、返回码任一不匹配,都可能造成外部访问失败。
建议分别测试:
如果集群内访问成功、节点访问NodePort失败,重点看节点防火墙、kube-proxy或节点路由;如果节点访问成功、外部访问失败,重点看云安全组、上游ACL、负载均衡监听器和返回路径。
修改主机防火墙或云安全组属于高影响操作。变更前应确认允许的源网段、目标端口、协议和回滚规则,先在单个节点或测试安全组验证,不要使用“放开全部来源和全部端口”作为长期方案。变更后还要检查规则是否被云平台、配置管理工具或节点初始化脚本覆盖。
外部请求通常可能经历负载均衡转发、节点端口映射、Service转发和Pod网络转换。若请求到达但响应无法返回,表现可能是超时而不是拒绝。常见原因包括:
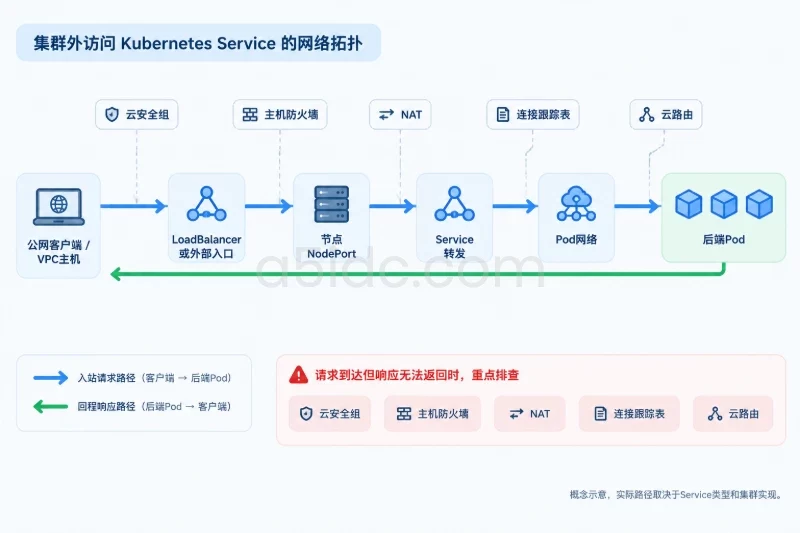
externalTrafficPolicy改变了源地址保留和转发行为。因此,应使用与故障客户端相同的源位置进行测试。不能用节点本机访问成功,替代公网客户端或其他VPC主机的验证。
Kubernetes Service所依赖的应用服务,也需要匹配的计算与网络资源。A5idc数据提供香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器,涵盖Xeon与AMD EPYC平台、SSD或NVMe存储及不同线路配置,可承载业务后台、数据库、接口服务等工作负载。对于需要较大内存或多任务处理的场景,也有相应配置选择,为容器化业务的部署与运行提供多地区的硬件资源基础。
当状态信息无法直接区分问题时,可以设计三个对照测试:
| 测试对象 | 主要排除范围 | 结果解释 |
|---|---|---|
Pod内访问127.0.0.1:targetPort | 应用进程是否工作 | 失败说明应用或端口配置优先级高 |
| 集群内访问Pod IP:targetPort | Service转发前的Pod网络 | 成功而Service失败,转向Service、策略或数据面 |
| 集群内访问Service DNS:port | DNS、Service和后端选择 | 失败时结合DNS、Endpoint和策略继续分层 |
| 节点或外部访问NodePort/LB | 节点、NAT、安全组、负载均衡 | 仅外部失败时优先检查暴露链路 |
还可以使用端口转发隔离应用本身:
kubectl -n backend port-forward pod/<pod-name> 18080:8080
另开终端测试:
curl -v http://127.0.0.1:18080/healthz
端口转发依赖Kubernetes API通道,成功只能说明API服务器能够连接到目标Pod端口,不能证明Service、NetworkPolicy或外部负载均衡路径正常。它适合隔离应用监听问题,不适合作为完整网络验证。
一个常见的定位过程如下:
127.0.0.1:8080:根因是应用绑定地址,改为监听Pod可达地址并重新验证。修复不能只看配置已更新,应沿原始访问路径重新验证,并确认新配置已经传播到数据面。
建议按以下顺序验证:
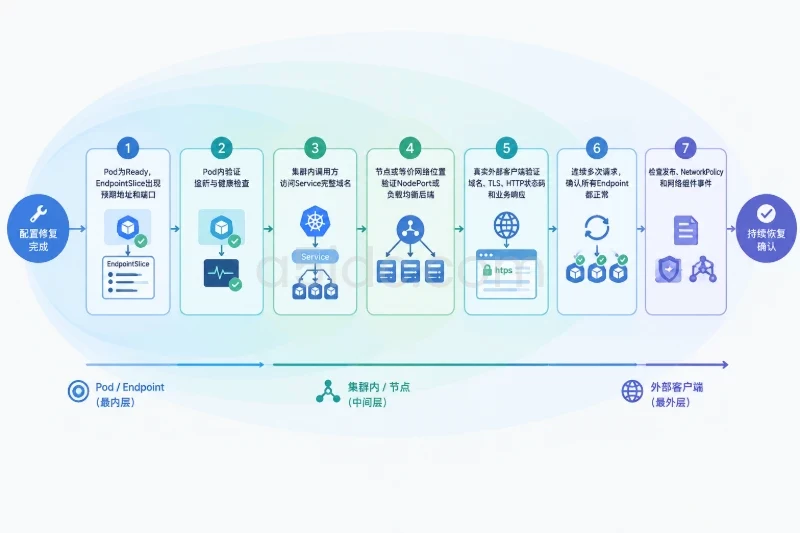
例如,修复targetPort后,可能需要等待EndpointSlice和负载均衡健康检查更新。若后端应用支持健康接口,应同时观察HTTP状态码、响应延迟和业务日志,而不是只判断TCP端口是否建立连接。
Service连接故障适合通过“服务发现、可用后端、连接质量、外部入口”四类指标提前发现:
告警应区分“无Endpoint”和“请求失败”两种情况:前者通常是发布、选择器或readiness问题,后者还可能涉及网络策略、节点和外部入口。监控中同时保留调用方命名空间、目标Service、目标端口、节点和响应错误类型,故障发生时才能沿着同一条链路快速复现,而不是只看到一个笼统的“Service不可用”。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/6456.html