香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


当 Pod 因数据卷无法挂载而停留在 ContainerCreating,或迁移到另一节点后出现 Multi-Attach、挂载超时、旧节点仍持有卷等现象时,先不要把问题归结为“PVC 配错了”。访问模式决定卷允许的挂载方式,但实际结果还受 PV、StorageClass、CSI 驱动、存储后端状态及节点上的旧挂载影响。排查时要先区分是调度与配置不匹配、卷仍附着在旧节点,还是底层存储或网络不可达。
通常可以从三处建立证据链:Pod 事件说明调度器或 kubelet 遇到了什么;PV 和 VolumeAttachment 说明 Kubernetes 记录的卷与节点关系;CSI 控制器、节点插件及存储系统日志则用于确认实际的附着和挂载结果。只看 PVC 显示 Bound,不能证明卷已经在目标节点挂载成功。
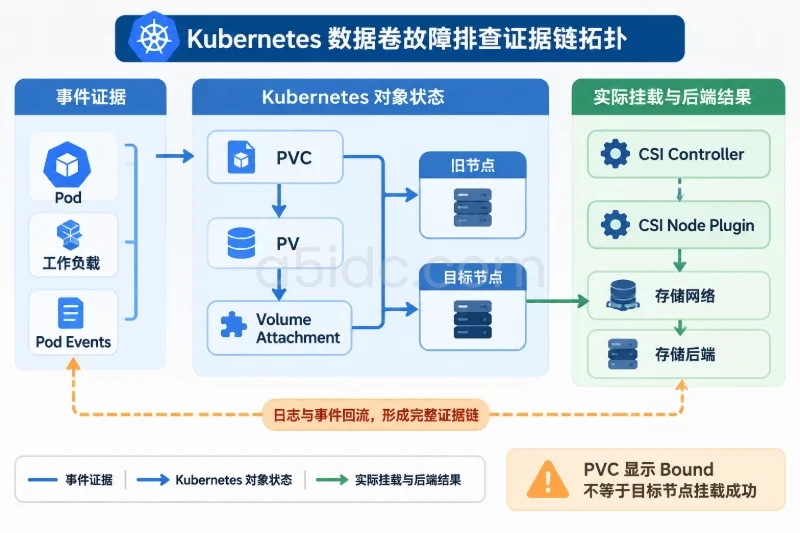
先记录受影响的 Pod、PVC、PV、节点,以及故障开始时间。查看 Pod 事件、所在节点和 PVC 状态:
kubectl get pod -n <命名空间> -o wide
kubectl describe pod -n <命名空间> <Pod名称>
kubectl get pvc -n <命名空间>
kubectl describe pvc -n <命名空间> <PVC名称>
重点看 Events 中是否出现以下信息:
| 观察到的现象 | 优先检查方向 |
|---|---|
Multi-Attach error、卷已附着到其他节点 | 访问模式、旧节点和旧附着状态 |
FailedMount、挂载超时或设备不可用 | CSI 节点插件、节点状态、存储网络与后端 |
FailedScheduling、PVC 未绑定或无可用卷 | PVC 与 PV 匹配条件、容量、拓扑和 StorageClass |
| 卷已挂载但应用报权限或文件错误 | 文件系统权限、容器安全上下文、应用并发访问方式 |
上述文字是常见事件类型的判断示例,实际事件措辞会随 Kubernetes 版本、CSI 驱动和存储产品而变化。应以现场的事件和驱动日志为准,不要仅凭某个关键字直接执行强制卸载或重建卷。
再判断故障范围:只有一个 Pod 失败,还是同一 PVC 的多个 Pod、同一节点上的其他卷,或同一存储类下的多个工作负载也受影响?单个 Pod 失败更适合从其声明、节点和容器配置入手;多个卷同时挂载失败,则要提高对 CSI 服务、节点插件或存储网络故障的怀疑。
先检查 PVC 请求的访问模式、绑定的 PV 实际访问模式,以及使用该声明的 Pod 分布在哪些节点:
kubectl get pvc -n <命名空间> <PVC名称> -o yaml
kubectl get pv <PV名称> -o yaml
kubectl get pod -n <命名空间> -o wide
kubectl get storageclass <StorageClass名称> -o yaml
常见访问模式的含义如下:
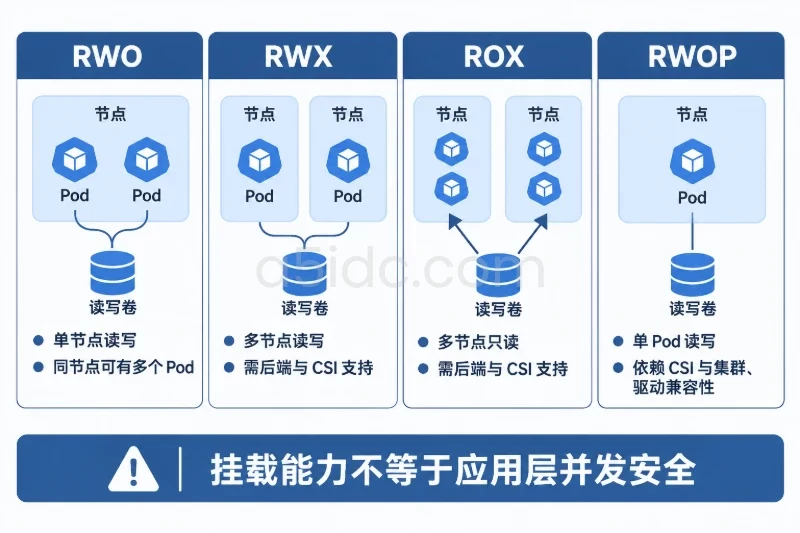
ReadWriteOnce(RWO):卷可由一个节点以读写方式挂载。它不是“只能被一个 Pod 使用”;同一节点上的多个 Pod 仍可能共同使用该卷。它也不代表应用可以安全地并发写入。ReadWriteMany(RWX):卷可由多个节点以读写方式挂载,但前提是存储后端和 CSI 驱动支持该能力。它本身不提供应用级文件锁或数据一致性保证。ReadOnlyMany(ROX):卷可由多个节点以只读方式挂载,仍要确认后端及驱动支持,并核实应用实际以只读方式使用。ReadWriteOncePod(RWOP):将读写使用范围限制到单个 Pod,适用于需要避免多个 Pod 同时使用的情形;它依赖 CSI 支持及相应的集群和驱动版本,启用前应核对兼容性。访问模式既用于 PVC 与 PV 的匹配,也描述卷的挂载能力;它不能替代存储系统的权限控制,也不能保证应用层面的并发安全。特别是 RWO 的限制在节点层面,不应误读成单 Pod 独占。
若工作负载可能被调度到不同节点,而使用的后端只允许单节点读写,Pod 迁移时就可能遇到旧节点仍持有卷的冲突。若确实需要跨节点读写,应确认存储后端支持 RWX,并确认文件系统、CSI 驱动和应用都能处理并发访问。仅把 PVC 的访问模式改成 RWX,并不会自动让不支持多节点挂载的块设备具备该能力。
还要检查 Pod 是否引用了预期的 PVC,PVC 是否绑定到预期 PV,以及 PV 是否包含节点亲和性约束。StorageClass 的 volumeBindingMode 若为 WaitForFirstConsumer,卷可能会等待调度器结合 Pod 的节点和拓扑条件再完成绑定;这不一定是故障。若 PV 的节点亲和性与工作负载可调度节点不相容,Pod 可能无法按预期落位。
查看 Kubernetes 中的卷附着记录:
kubectl get volumeattachments.storage.k8s.io \
  -o custom-columns=NAME:.metadata.name,PV:.spec.source.persistentVolumeName,NODE:.spec.nodeName,ATTACHED:.status.attached
找到对应 PV 后,检查关联记录和状态:
kubectl describe volumeattachment <VolumeAttachment名称>
kubectl get node <节点名称> -o wide
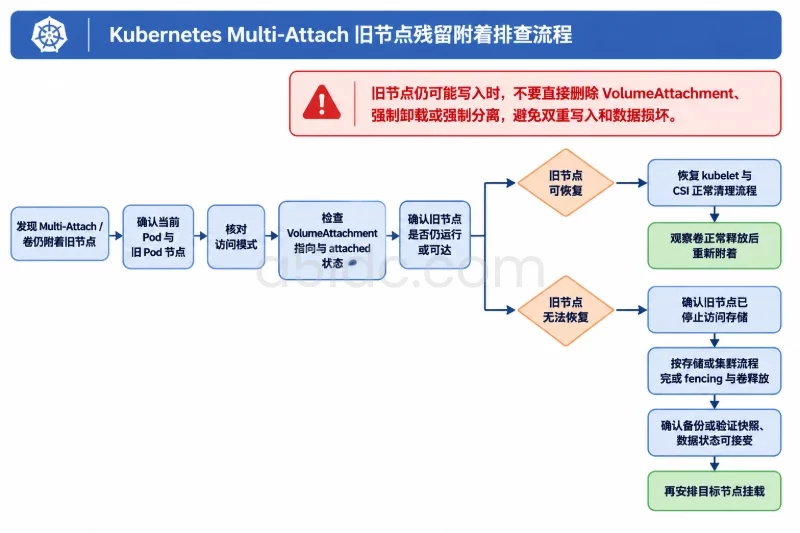
如果卷仍显示附着在旧节点,先核实旧节点是否只是暂时不可达、仍在运行,或者其上的旧 Pod 是否仍在使用该卷。Pod 已被删除,不代表节点上的挂载和存储端附着已立即清理完毕;节点失联、kubelet 异常、CSI 分离流程卡住,都可能造成状态暂时不一致。
以下迹象更支持“旧附着未释放”:Pod 已被重新调度到新节点;事件报告卷仍附着于旧节点;VolumeAttachment 指向旧节点;CSI 控制器日志显示 detach 失败或持续重试。相反,如果附着记录已经转到目标节点,但仍无法挂载,则应转向检查节点插件、设备映射、文件系统和存储后端,而不是继续处理旧节点。
不要在没有确认旧节点状态时,直接删除 VolumeAttachment、在节点上强制卸载,或在存储控制台强制分离卷。Kubernetes 或 CSI 可能仍认为卷归旧节点所有;旧节点若继续运行,还可能造成双重写入和数据损坏。
若配置与附着关系看起来合理,再按节点、CSI 和后端顺序排查:
Ready,磁盘、内核设备和 kubelet 是否正常;检查同一节点上其他卷是否也挂载失败。多个卷集中出错时,节点侧问题的可能性会增加。ControllerPublish、NodeStage、NodePublish 或 detach 错误。容器名称因驱动而异,可先查看 Pod,再读取相关容器日志: kubectl get pods -n <CSI命名空间> -o wide
kubectl describe pod -n <CSI命名空间> <CSI-Pod名称>
kubectl logs -n <CSI命名空间> <CSI-Pod名称> -c <容器名称> --since=30m
securityContext 和应用对共享文件的并发操作。此类问题通常不会表现为卷仍附着在另一节点。节点上的挂载检查应在确认目标节点后进行,并结合 findmnt、设备信息及 kubelet 日志判断:
findmnt -R /var/lib/kubelet
lsblk -f
/var/lib/kubelet 下的具体挂载路径会随卷类型、驱动和 Kubernetes 实现而异。不要假设某个目录名在所有集群中都适用;更不要对仍由 kubelet 管理的挂载点直接执行卸载。
如果 PVC 不是 Bound,先对照 PVC 与 PV 的访问模式、容量、存储类和卷模式,再检查 PV 是否满足 Pod 的节点拓扑要求。若事件提示没有匹配的 PV,应查找具体不匹配项;若使用动态供给,则核实 StorageClass 的供给器和拓扑配置。
此时不要先处理节点上的挂载。卷尚未绑定或 Pod 尚未调度,问题通常还没有进入实际挂载阶段。PVC 为 Bound 但 Pod 仍失败,则继续查看 Pod 事件和 VolumeAttachment,不要把绑定成功当作挂载成功。
核对当前 Pod 与旧 Pod 的节点、卷访问模式、VolumeAttachment 指向的节点,以及旧节点是否健康。若旧节点可恢复,优先让其恢复正常的 kubelet 和 CSI 清理流程,使卷按正常生命周期释放,再观察新节点的附着状态。
如果工作负载由 Deployment、StatefulSet 或其他控制器管理,还需确认控制器是否正在重建旧 Pod,或是否存在多个副本同时使用同一个单节点读写卷。停止或调整工作负载前,应评估副本数、服务中断范围、PodDisruptionBudget 和应用数据一致性;避免照搬针对某一种控制器的删除或缩容操作。
旧节点无法恢复时,先确认节点确已停止访问存储,并按存储厂商或集群运维流程完成隔离(fencing)和卷释放,再安排目标节点重新挂载。对关键数据卷,在进行强制分离等高风险操作前应有可用备份或经过验证的快照,并明确受影响的卷、Pod 和业务范围。强制分离可能导致未落盘数据丢失;如果旧节点仍能写入,单纯在控制面释放卷并不能防止数据损坏。回退也不等于把卷重新挂回旧节点:只有在确认目标端不再访问、数据状态可接受后,才应按存储流程恢复挂载。
若 VolumeAttachment 已指向目标节点,而 Pod 仍出现 FailedMount,检查 CSI 节点插件日志和节点本地状态。重点区分设备未出现、文件系统识别失败、挂载参数不兼容、权限不足和后端路径不可达。不同错误需要不同处置:设备未映射应查 CSI 与存储端;格式或文件系统问题应先确认卷上数据和文件系统状态,不能直接格式化;权限错误则核对容器用户、卷权限及安全上下文。
若只有某一节点失败而同一卷在其他节点正常,应优先比较节点内核、插件版本、挂载依赖和网络路径,不要先改 PVC 访问模式。若同一存储类的多节点同时失败,则检查 CSI 控制面和存储端服务状态。
如果 Pod 已进入运行状态,挂载路径也存在,但应用仍报错,检查应用实际访问的路径是否与 volumeMounts.mountPath 一致,容器是否以只读方式挂载,以及进程身份是否有相应权限。多个 Pod 共享 RWX 卷时,还需确认应用是否依赖本地文件锁、临时文件原子替换或单写者约束;RWX 只说明挂载能力,不保证多个应用进程可以无冲突地修改同一份数据。
根因应由至少两类证据相互印证,而不是只依赖一条事件。例如:
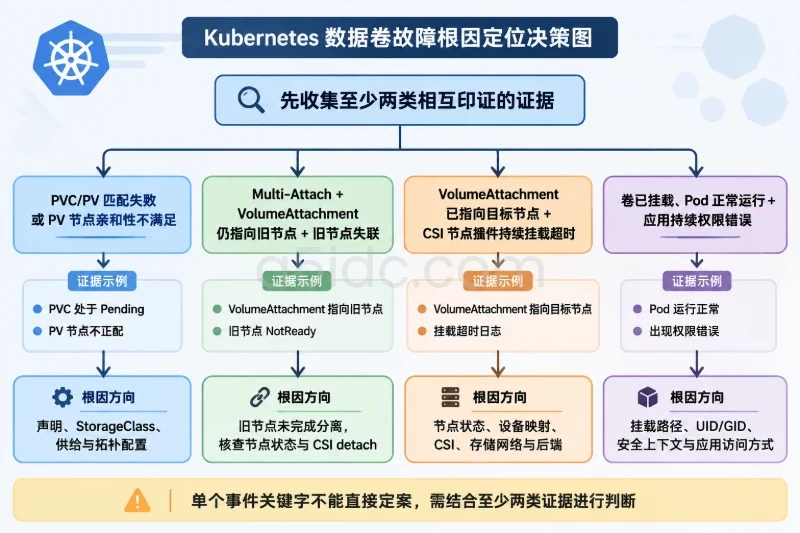
Multi-Attach 事件、卷仍指向旧节点,且旧节点失联:更符合旧节点未完成分离。VolumeAttachment 已指向新节点,但 CSI 节点插件反复报告挂载超时:更符合节点侧或存储网络问题。修复后按同一条链路验证:
describe pod 中不再出现新的挂载失败事件。VolumeAttachment 指向当前节点,CSI 日志不再持续重试或报告同一错误。如果为了处理故障更改了访问模式、StorageClass、节点约束或工作负载副本策略,应记录原配置,并在确认数据安全及业务要求后再决定是否恢复。不要为了让 Pod 变成 Running,把单节点卷改成未经后端支持的多节点读写,也不要删除仍有数据价值的 PVC 或 PV。
持续关注 Pod 挂载失败事件、Multi-Attach 次数、PVC 长时间未绑定、CSI 附着与分离耗时、节点 NotReady、CSI Pod 重启,以及存储后端的连接超时和容量告警。告警阈值应结合集群正常的调度与存储操作耗时设定,避免把一次短暂重试当成持续故障。
对状态型工作负载,维护卷与节点、访问模式、存储拓扑及应用副本策略的对应关系;定期验证节点失联时的隔离和卷恢复流程,并确保备份或快照可以按预期恢复。这样在下一次迁移或节点故障时,才能更快判断是访问模式不匹配、旧挂载未释放,还是 CSI、网络或应用层问题。
A5idc数据提供香港、美国、日本等地区的物理服务器租用,产品覆盖Xeon Gold、AMD EPYC等平台,并提供NVMe、SSD及大容量HDD等存储配置。对于运行Kubernetes状态型工作负载、数据库或业务后台的自建环境,可结合计算资源、磁盘类型与部署地区构建节点和数据承载基础;多地区及不同线路方案也适用于面向不同用户区域的业务部署。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9569.html