香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


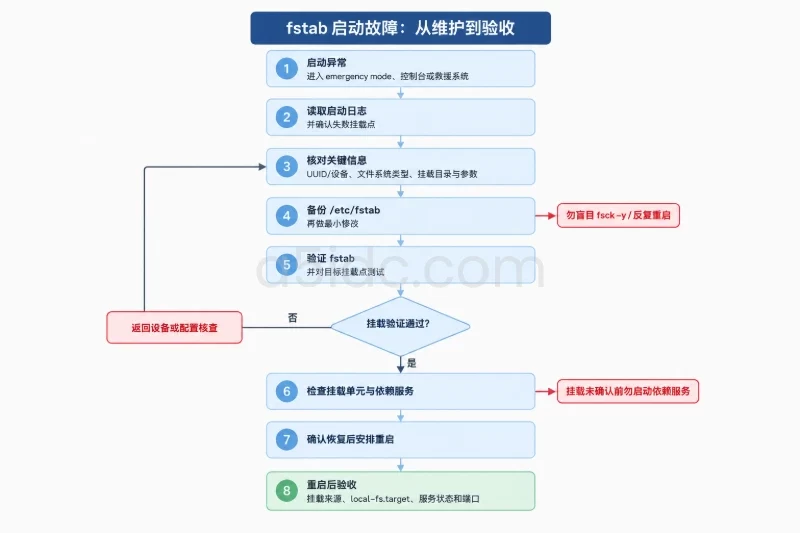
如果服务器开机后停在 emergency mode、提示输入 root 密码,或者 SSH、Web 服务同时不可用,屏幕中常见的报错包括 Dependency failed for /data、Timed out waiting for device、Cannot open access to console 和 wrong fs type, bad option, bad superblock。这类现象通常不是服务本身先坏了,而是 /etc/fstab 中的设备、文件系统类型、挂载参数或依赖关系不正确,导致系统没有完成本地文件系统挂载。
处理时不要一上来执行 fsck -y、删除设备或反复重启。更稳妥的顺序是:进入应急维护环境,先读取日志并确认失败的挂载点;再核对 UUID、文件系统类型、目录和参数;修改前备份 /etc/fstab;使用 findmnt、mount 和 systemd 状态检查验证;最后再重启,并确认挂载、服务状态、端口和日志均恢复正常。
| 现象或日志 | 通常代表的问题 | 优先检查对象 |
|---|---|---|
Timed out waiting for device dev-disk-by-uuid... | fstab 中的 UUID 找不到,或设备没有出现 | lsblk -f、blkid、磁盘和 LVM 状态 |
Dependency failed for /data | /data 对应的挂载单元失败 | /etc/fstab 中 /data 的配置、挂载单元日志 |
mount: wrong fs type, bad option, bad superblock | 文件系统类型、参数不匹配,或文件系统本身存在问题 | FSTYPE、挂载选项、离线文件系统检查 |
mount point does not exist | fstab 指定的目标目录不存在 | 目标目录和父目录权限 |
| 启动很久后进入 emergency mode | 等待本地磁盘、网络文件系统或设备超时 | local-fs.target、远程挂载、设备超时参数 |
| 系统能启动但业务服务失败 | 挂载可能已被 nofail 跳过,应用在空目录上启动 | findmnt、服务日志、应用数据路径 |
挂载成功但应用报 Permission denied | 文件系统已挂载,问题转移到目录权限、用户、SELinux 或 NFS 权限 | namei、stat、服务运行用户和安全策略 |
如果服务器仍然可以登录,先不要修改配置,收集当前启动周期的证据:
journalctl -xb -p warning..alert --no-pager
journalctl -b -u local-fs.target --no-pager
systemctl --failed --no-legend
findmnt -rno TARGET,SOURCE,FSTYPE,OPTIONS
lsblk -o NAME,TYPE,FSTYPE,LABEL,UUID,SIZE,MOUNTPOINTS
这些命令分别用于查看本次启动的错误、local-fs.target 的依赖失败、失败的 systemd 单元、当前实际挂载结果和块设备信息。若 journalctl 不可用,可以补充查看内核日志:
dmesg -T | tail -n 100
日志中的时间点和设备名称很重要。例如,/dev/sdb1 变成了 /dev/sdc1 并不一定代表 fstab 错误,因为稳定的 UUID 通常不会随设备名变化;但如果日志显示目标 UUID 不存在,就应重点核对磁盘是否连接、加密卷是否解锁、LVM 逻辑卷是否激活。
部分发行版会显示类似下面的提示:
Welcome to emergency mode!
Give root password for maintenance
(or press Control-D to continue):
输入 root 密码后进入 shell。若系统已经给出 root shell,可以先确认当前身份和根目录是否可写:
id
findmnt -no TARGET,SOURCE,FSTYPE,OPTIONS /
如果输出中的根目录选项包含 ro,说明根文件系统以只读方式挂载。确认当前确实处于维护状态后,可以尝试重新挂载为可写:
mount -o remount,rw /
成功后再检查:
findmnt -no TARGET,OPTIONS /
如果重新挂载失败,不要强行使用其他覆盖参数。根文件系统可能存在一致性问题,此时应改用云平台控制台、串口控制台或救援系统处理,并且不要在仍挂载使用中的根分区上运行修复工具。
SSH 不可用并不能直接证明网络配置有问题。/etc/fstab 失败可能阻塞启动目标,进而导致 SSH 服务没有启动。可以通过以下方式进入本机维护环境:
如果控制台只能看到启动菜单,可以临时从 GRUB 进入 emergency target。选择系统启动项后按 e 编辑,在以 linux 或 linuxefi 开头的内核参数行末尾追加:
systemd.unit=emergency.target
按照屏幕提示启动,常见方式是按 Ctrl+x 或 F10。该参数只对本次启动有效,不会直接修改磁盘上的配置。若系统在 initramfs 阶段就失败,systemd.unit 可能来不及生效,这时才考虑发行版支持的 rd.break 等 initramfs 维护方式。使用 initramfs shell 时,真实系统根目录通常位于 /sysroot,不要误把救援环境中的 /etc/fstab 当成目标系统的配置。
从救援系统启动后,第一步是识别目标系统的根分区,不要根据磁盘名称猜测:
lsblk -f
blkid
假设确认系统根卷是某个 LVM 逻辑卷,目标挂载方式可能类似下面的示例;设备名必须替换为实际识别结果:
mount /dev/mapper/vg0-root /mnt

# 如果 /boot 是独立分区,先确认设备后再挂载
mount /dev/nvme0n1p2 /mnt/boot
只为修复 fstab 时通常不需要完整 chroot。直接编辑目标系统中的配置即可:
cp -a /mnt/etc/fstab "/mnt/etc/fstab.bak.$(date +%Y%m%d-%H%M%S)"
vi /mnt/etc/fstab
如果目标系统使用了加密分区、LVM、软件 RAID 或独立 /usr,应先使用对应工具解锁、激活和挂载。无法确认设备关系时不要运行 mkfs、pvcreate、vgcreate 等初始化命令,这些操作可能覆盖元数据。
修复完成后按嵌套顺序卸载:
umount /mnt/boot
umount /mnt
如果 /boot 并非独立挂载点,不要照搬该命令;卸载前可用 findmnt -R /mnt 查看挂载层级。
在已经进入目标系统的维护 shell 中,先备份配置:
cp -a /etc/fstab "/etc/fstab.bak.$(date +%Y%m%d-%H%M%S)"
ls -l /etc/fstab*
查看有效配置和不可见字符:
grep -vE '^[[:space:]]*(#|$)' /etc/fstab
sed -n 'l' /etc/fstab
sed -n 'l' 可以发现普通查看不明显的问题。例如行尾显示 \r$,通常说明文件带有 Windows 换行符;路径中存在没有转义的空格,也可能导致字段数量错误。确认是换行符问题后,在已经完成备份的前提下再处理:
sed -i 's/\r$//' /etc/fstab
恢复备份的回滚方式为:
cp -a /etc/fstab.bak.时间戳 /etc/fstab
这里的 时间戳 要替换为实际备份文件名,不要直接复制示例字符串。
典型本地文件系统配置如下:
UUID=11111111-2222-3333-4444-555555555555 /data ext4 defaults 0 2
六个字段依次是:
UUID=、设备路径、LABEL 或网络共享;ext4、xfs、btrfs;defaults、ro、nofail;0;1,其他需要检查的分区为 2,不参与检查的文件系统通常为 0。使用设备信息核对来源和文件系统类型:
lsblk -f
blkid
也可以针对某个设备查看 UUID:
blkid -s UUID -o value /dev/sdb1
blkid -s TYPE -o value /dev/sdb1
如果 fstab 写的是某个 UUID,而 lsblk -f 中没有对应值,可能存在以下情况:
确认设备确实属于目标数据后,才能把 fstab 中的 UUID 改成新的值。不要只因为某个设备当前显示为 /dev/sdb1 就直接替换,设备名称可能在下一次启动时变化。
确认目录是否存在:
stat /data
findmnt --target /data
如果目录不存在,可以在确认路径没有拼写错误后创建:
mkdir -p /data
挂载会覆盖挂载点目录原本的可见内容,但不会删除这些内容。比如 /data 原来有应用文件,真正的数据盘挂载后,这些文件会暂时被隐藏;卸载数据盘后又会出现。不要因为挂载后看到目录为空,就立即初始化或删除目录。
对于已经存在的挂载点,先用下面的命令确认真实来源:
findmnt --target /data
findmnt -R /data
如果显示 /data 已经被其他设备或临时文件系统占用,不要直接重复挂载,应先判断该挂载是否由其他服务建立。
如果日志显示等待某个 UUID 超时,而 blkid 找不到该 UUID,先检查设备是否真的在线:
lsblk
cat /proc/partitions
云盘、LVM、加密卷或 RAID 尚未出现时,先恢复对应底层设备。若确认这条挂载是可选数据盘,可以临时在 fstab 行首加 # 注释,让系统先恢复启动:
# UUID=11111111-2222-3333-4444-555555555555 /data ext4 defaults 0 2
这只是让启动继续,不代表数据盘问题已经解决。依赖 /data 的数据库、文件服务或应用应保持停止状态,避免服务在空目录中创建新文件,造成数据路径混乱。修复设备后再恢复该行并验证。
例如设备实际是 xfs,但 fstab 写成了 ext4;或者使用了当前文件系统不支持的选项,都会出现 wrong fs type、bad option 等错误。
可以先从只读方式测试设备,但前提是设备当前没有被挂载:
findmnt --source /dev/sdb1
mkdir -p /run/fstab-test
mount -o ro /dev/sdb1 /run/fstab-test
findmnt --target /run/fstab-test
umount /run/fstab-test
mount -o ro 可以降低写入风险,但不能替代完整的文件系统检查。对于正在使用的设备,不要为了测试而强行卸载生产挂载点。
如果只读挂载也失败,且日志出现 bad superblock、I/O error 或 metadata error,应转入离线检查分支。文件系统必须处于未挂载状态:
findmnt --source /dev/sdb1
确认没有输出后,再根据实际文件系统和发行版工具执行只读检查。常见示例是:
fsck -f -n /dev/sdb1
XFS 通常使用:
xfs_repair -n /dev/sdb1
不同文件系统的修复工具和参数差异较大。-n 或 --readonly 一类参数通常用于只检查不修改,但仍应先阅读当前系统工具的帮助信息。不要在未备份、未确认设备、设备仍挂载的情况下直接使用 fsck -y 或强制修复。文件系统存在物理 I/O 错误时,应优先保留快照或磁盘副本,再进行修复。
挂载成功后,挂载点原有的属主和权限会被挂载文件系统中的根目录权限覆盖。因此,修改挂载前 /data 的权限,通常不能解决挂载后应用的访问问题。
确认应用用户能否访问完整路径:
findmnt /data
namei -om /data/app
stat -c '%A %U:%G %n' /data /data/app
如果应用以 app 用户运行,可以做无写入的读取测试:
runuser -u app -- test -r /data/app
echo $?
只有在明确允许写入测试目录时,才进行写入和清理测试:
runuser -u app -- sh -c 'f=/data/app/.mount-write-test; : > "$f" && rm -f "$f"'
返回值为 0 通常表示测试成功。若失败,分别检查父目录执行权限、文件系统挂载选项、NFS 的 root squash、ACL 以及 SELinux。不要为了快速恢复而对整个数据目录执行 chmod -R 777,这会扩大安全影响,也可能破坏原有权限模型。
NFS 等远程挂载不仅依赖本地设备,还依赖网络、DNS、远端服务和认证。可选的远程目录可以使用类似配置:
nas.example:/export /backup nfs4 _netdev,nofail,x-systemd.automount 0 0
各参数的含义不同:
_netdev 表示这是网络设备,帮助 systemd 按网络依赖处理;nofail 表示挂载失败时不阻塞正常启动,但应用可能在挂载不可用时启动;x-systemd.automount 将实际挂载推迟到第一次访问,能够减少启动阶段的等待,但第一次访问仍可能阻塞;x-systemd.device-timeout= 主要用于等待本地块设备,不应被误认为是远端 NFS 服务的完整超时设置;man systemd.mount 和 man systemd-fstab-generator 核对。如果备份目录是业务必须依赖的路径,不要仅靠 nofail 掩盖问题。应让业务服务明确依赖挂载完成,避免服务启动后把数据写入本地空目录。
确认原因后,只修改对应字段。例如:
# 原配置
UUID=旧的UUID  /data  ext4  defaults  0  2

# 核实实际设备后修改
UUID=新的UUID  /data  ext4  defaults  0  2
如果只是可选目录暂时不可用,可以临时注释该行;如果只是启动等待时间过长,可以针对本地设备增加合理的设备等待时间:
UUID=11111111-2222-3333-4444-555555555555 /data ext4 defaults,nofail,x-systemd.device-timeout=10s 0 2
nofail 不适合根分区、数据库主数据目录或应用不可缺少的文件系统。对这类路径使用 nofail,可能使系统“看起来启动成功”,但服务实际在错误位置运行。
systemd 发行版可以先执行:
findmnt --verify --verbose
该命令主要检查 fstab 的解析结果、挂载点和来源信息。不同 util-linux 版本的输出文字可能不同,重点看是否报告语法错误、来源不存在或目标目录问题。
然后重新加载 systemd 配置:
systemctl daemon-reload
对已经确认未挂载且适合在维护窗口测试的目标,可以使用 fstab 中的配置执行:
mount -v /data
findmnt --target /data
如果需要测试所有 fstab 条目:
mount -a -v
mount -a 会实际尝试挂载所有未使用 noauto 的条目,可能访问网络共享,也可能等待远程服务。不要在业务高峰或不清楚所有条目用途时直接执行。更稳妥的做法是先使用 findmnt --verify,再对具体挂载点逐项测试。
成功时,findmnt 应显示预期的来源、文件系统类型和目标目录,例如:
TARGET SOURCE    FSTYPE OPTIONS
/data  /dev/sdb1 ext4   rw,relatime
如果 mount -v /data 仍然失败,应根据新输出回到对应分支,而不是继续重启。
fstab 条目会被 systemd 转换为挂载单元。以 /data 为例,通常对应 data.mount:
systemd-escape -p --suffix=mount /data
systemctl status data.mount --no-pager
journalctl -b -u data.mount --no-pager
如果目标路径较深,单元名会经过转义,使用 systemd-escape 得到的结果更可靠。挂载单元日志中如果仍显示旧 UUID,执行 systemctl daemon-reload 后再检查;若配置刚修改且服务状态是失败状态,可以在确认原因已修复后清理失败标记:
systemctl reset-failed data.mount
不要通过删除 /run/systemd/generator 下的临时文件来“修复”问题,这些文件会在下一次生成时重新出现。
挂载成功并不等于业务已经恢复。先确认应用的配置路径和运行用户,再查看服务状态:
systemctl status app.service --no-pager
journalctl -u app.service -b -n 100 --no-pager
systemctl list-dependencies app.service
如果应用必须等待 /data,服务单元可以在 [Unit] 中声明:
[Unit]
RequiresMountsFor=/data
After=network-online.target
Wants=network-online.target
RequiresMountsFor=/data 比单独写 After=data.mount 更适合路径依赖,因为它可以根据路径生成所需的挂载关系。修改服务单元后需要:
systemctl daemon-reload
systemctl restart app.service
重启服务前应确认数据挂载已存在,否则应用可能在错误的本地目录中初始化文件。
确认服务是否监听端口:
ss -lntup
端口没有监听时,优先查看应用日志和服务状态;可能是数据目录不可用、权限不足、配置文件读取失败或进程启动后立即退出。端口已经监听但外部仍无法访问,则再区分监听地址、防火墙、安全组和反向代理问题,不要把所有网络现象都归因于 fstab。
fstab 修复后,底层硬件与网络资源也会影响业务恢复后的运行环境。A5idc数据提供中国香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器,涵盖 Xeon 与 AMD EPYC 平台、SSD 或 NVMe 存储及不同线路方案,可用于部署网站、数据库、业务后台和接口服务;香港与日本的存储型方案还提供多盘配置,适合文件存储与归档类业务。
维护 shell 中至少确认以下项目:
findmnt --verify --verbose
findmnt -rno TARGET,SOURCE,FSTYPE,OPTIONS
systemctl is-active local-fs.target
systemctl --failed --no-legend
对于关键目录,单独检查来源:
mountpoint /data
findmnt --target /data
如果输出的是预期设备、预期文件系统类型和 rw 等正确选项,且相关挂载单元不再失败,可以安排重启。远程服务器应确保控制台仍然可用,避免 SSH 尚未恢复而失去维护入口:
sync
systemctl reboot
系统重新启动后,再用新的启动周期检查:
systemctl is-active local-fs.target
systemctl --failed --no-legend
findmnt --verify --verbose
findmnt -rno TARGET,SOURCE,FSTYPE,OPTIONS
journalctl -b -p warning..alert --no-pager
如果应用依赖挂载目录,还要检查:
systemctl status app.service --no-pager
journalctl -u app.service -b -n 100 --no-pager
ss -lntup
验收结果可以按以下方式判断:
local-fs.target 为 active,目标目录来源正确,说明本地挂载阶段已经完成;nofail 跳过,需继续处理设备或 fstab;active 但端口不存在,检查应用是否使用 Unix Socket、监听了其他地址或启动后处于异常状态;恢复后不要立刻删除备份文件。至少保留本次修改前的 /etc/fstab 备份,观察一到两个启动周期和业务高峰时段的日志。对于经常变化的云盘、远程 NFS、临时数据盘,应明确哪些挂载是启动必需项,哪些可以使用 nofail 或自动挂载,并在磁盘变更、系统升级和服务发布后再次检查 findmnt、失败单元和应用数据路径。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/6391.html