香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


对象存储分片上传要解决的,不只是把大文件切成若干块发送,还要在客户端进程退出、网络中断或单个分片失败后,判断哪些数据已经落到存储端,并在文件未变化的前提下继续上传。对接 S3 兼容对象存储时,通常由 CreateMultipartUpload 创建上传任务,UploadPart 上传分片,ListParts 查询已接收分片,最后通过 CompleteMultipartUpload 合并为对象。断点续传依赖上传任务 ID 和分片状态;失败重试则要避免把已成功的分片重复计入完成清单。
下文以自建或托管的 S3 兼容存储为例说明。不同存储服务对分片大小、对象上限、校验和、超时及生命周期清理的支持可能不同,正式部署前应核对目标服务的兼容说明。示例使用 Python 的 boto3 SDK 演示核心流程,不绑定某一家对象存储产品。
A5数据提供香港、日本、美国等地区的物理服务器资源,覆盖NVMe、SSD及大容量企业级硬盘配置,可为对象存储服务、文件上传后台和数据归档业务提供相应的计算与存储基础。结合不同地区的网络线路、带宽及多IP方案,能够适配跨区域访问、分片并发传输和持续增长的数据存储需求。
一次分片上传会产生两类状态:
客户端不能只靠“本地已经发过第几片”判断进度:请求可能在服务端接收成功后,响应却在网络中丢失。反过来,也不能只保存上传任务 ID 而不校验本地文件;如果续传时文件内容已经变化,旧分片和新分片可能被合并到同一个对象中。
部署前应确认以下条件:
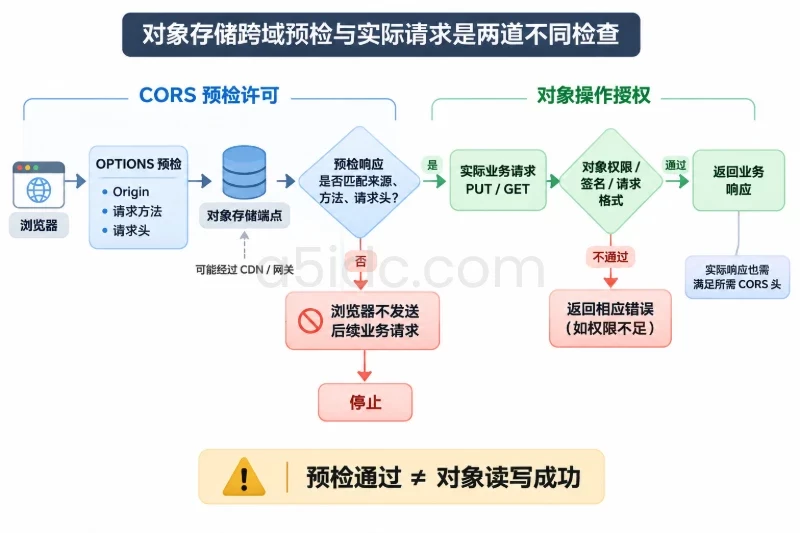
若浏览器直接上传,上传凭证不应包含服务端主密钥。应由业务后端鉴权后生成限定存储桶、对象键、分片编号和有效期的预签名请求,并按实际需要配置跨域规则。
业务端首先为本次上传生成一个稳定的业务标识,例如订单附件 ID 或文件记录 ID,并由后端确定对象键。对象键不宜直接信任客户端传入的任意路径,避免覆盖其他业务对象或造成路径混淆。
随后,后端或受控客户端创建分片上传任务,存储服务返回 UploadId。客户端按固定大小读取文件,每片带上唯一分片编号上传。存储服务确认分片后返回 ETag;客户端收到响应并不意味着整个对象已经可用,只有合并请求成功,完整对象才形成。
典型路径如下:
UploadId、存储桶、对象键、文件大小、分片大小及本地文件标识。业务状态宜显式区分“上传中”“合并中”“完成”“失败待恢复”和“已取消”。不要在第一片上传成功时就把业务文件标为可下载。
分片过小会增加请求数量、签名和状态记录开销;分片过大则会增加单次失败后需要重传的数据量,也会提高客户端内存占用。可从 8 MiB 至 64 MiB 的分片大小开始评估,再根据文件规模、网络质量、存储服务限制和并发能力调整。这是工程起点,不是对所有业务都适用的固定值。
分片数量按“文件大小除以分片大小后向上取整”计算。例如,假设文件为 2 GiB,分片设为 16 MiB,按二进制口径计算,分片数为 2,048 MiB ÷ 16 MiB = 128 片。若分片数接近服务端上限,应增大分片尺寸或采用其他上传方式。
并发数应受客户端带宽、存储端处理能力和业务流量共同约束。可以先用 2 至 4 个并发分片验证稳定性,再逐步调整。并发越高不一定越快:它可能挤占其他业务带宽,也会增加重试时的瞬时请求量。每个分片仍应有独立编号,合并时按编号排序,不能按请求完成先后排序。
以下示例适用于支持 S3 分片接口的服务。安装依赖:
python -m pip install boto3
先通过环境变量配置端点、区域和凭证。不同服务的区域名、签名要求可能不同,应以服务端配置为准;不要将访问密钥写进代码仓库。
export S3_ENDPOINT_URL="https://s3.example.com"
export AWS_ACCESS_KEY_ID="替换为访问密钥"
export AWS_SECRET_ACCESS_KEY="替换为密钥"
export AWS_DEFAULT_REGION="us-east-1"
示例采用单进程顺序上传,并将 UploadId 等任务信息保存到本地 JSON 文件。生产系统应把同类状态写入可靠数据库,并限制同一上传任务被多个工作进程同时处理。
import json
import os
import tempfile
from pathlib import Path

import boto3
from botocore.config import Config


def save_state(path, state):
    path = Path(path)
    path.parent.mkdir(parents=True, exist_ok=True)

    fd, temp_path = tempfile.mkstemp(dir=str(path.parent))
    try:
        with os.fdopen(fd, "w", encoding="utf-8") as f:
            json.dump(state, f)
            f.flush()
            os.fsync(f.fileno())
        os.replace(temp_path, path)
    finally:
        if os.path.exists(temp_path):
            os.unlink(temp_path)


def list_all_parts(client, bucket, key, upload_id):
    parts = []
    marker = None

    while True:
        args = {
            "Bucket": bucket,
            "Key": key,
            "UploadId": upload_id,
        }
        if marker is not None:
            args["PartNumberMarker"] = marker

        result = client.list_parts(**args)
        parts.extend(result.get("Parts", []))

        if not result.get("IsTruncated"):
            return parts

        marker = result.get("NextPartNumberMarker")


def upload_resumable(file_path, bucket, key, state_path,
                     part_size=16 * 1024 * 1024):
    file_path = Path(file_path)
    stat = file_path.stat()
    file_size = stat.st_size

    if file_size == 0:
        raise ValueError("空文件应使用普通 PutObject,而不是分片上传")
    if part_size < 5 * 1024 * 1024:
        raise ValueError("示例要求分片不小于 5 MiB")

    client = boto3.client(
        "s3",
        endpoint_url=os.environ["S3_ENDPOINT_URL"],
        region_name=os.environ.get("AWS_DEFAULT_REGION", "us-east-1"),
        config=Config(
            retries={"mode": "standard", "max_attempts": 5},
            connect_timeout=10,
            read_timeout=120,
        ),
    )

    state_path = Path(state_path)
    identity = {
        "bucket": bucket,
        "key": key,
        "size": file_size,
        "mtime_ns": stat.st_mtime_ns,
        "part_size": part_size,
    }

    if state_path.exists():
        state = json.loads(state_path.read_text(encoding="utf-8"))
        for name, value in identity.items():
            if state.get(name) != value:
                raise RuntimeError(
                    f"本地文件或上传参数已变化({name}),"
                    "不要继续复用旧 UploadId"
                )
        upload_id = state["upload_id"]
    else:
        result = client.create_multipart_upload(
            Bucket=bucket,
            Key=key,
        )
        upload_id = result["UploadId"]
        state = {**identity, "upload_id": upload_id}
        save_state(state_path, state)

    remote_parts = list_all_parts(client, bucket, key, upload_id)
    completed = {
        p["PartNumber"]: p
        for p in remote_parts
    }

    part_count = (file_size + part_size - 1) // part_size
    if part_count > 10000:
        raise ValueError("分片数量超过示例所适用的常见上限,请增大分片尺寸")

    with file_path.open("rb") as f:
        for part_number in range(1, part_count + 1):
            offset = (part_number - 1) * part_size
            expected_size = min(part_size, file_size - offset)

            existing = completed.get(part_number)
            if existing and existing.get("Size") == expected_size:
                continue

            f.seek(offset)
            data = f.read(expected_size)
            if len(data) != expected_size:
                raise IOError("读取到的分片长度与预期不一致")

            result = client.upload_part(
                Bucket=bucket,
                Key=key,
                UploadId=upload_id,
                PartNumber=part_number,
                Body=data,
            )
            completed[part_number] = {
                "PartNumber": part_number,
                "ETag": result["ETag"],
                "Size": expected_size,
            }

    parts = [
        {
            "PartNumber": number,
            "ETag": completed[number]["ETag"],
        }
        for number in range(1, part_count + 1)
    ]

    client.complete_multipart_upload(
        Bucket=bucket,
        Key=key,
        UploadId=upload_id,
        MultipartUpload={"Parts": parts},
    )

    head = client.head_object(Bucket=bucket, Key=key)
    if head["ContentLength"] != file_size:
        raise RuntimeError("合并后对象大小与本地文件大小不一致")

    state_path.unlink(missing_ok=True)
    return head
这个示例通过 ListParts 恢复已确认分片,避免仅依赖本地“已上传到第几片”的记录。对已存在的分片,它检查编号和大小;若文件可能在相同大小、相同时间戳下被替换,应在任务状态中额外保存文件哈希或可靠的业务版本标识,并在续传前校验。对象存储返回的 ETag 也不应普遍当作文件 MD5 使用,特别是在分片上传或启用服务端加密时;需要端到端完整性校验时,应使用服务支持的校验和字段,或在业务侧单独保存并验证文件摘要。
SDK 的标准重试策略可处理一部分瞬时错误,但它不等于完整的业务恢复机制。示例遇到未处理异常会保留状态文件和 UploadId;再次运行时重新查询服务端分片状态。正式环境还应记录每片的尝试次数、错误类型和最后一次结果,避免无限重试。对限流、服务繁忙和临时网络错误采用有上限的指数退避,并加入随机抖动;对权限错误、参数错误或对象键冲突等不可重试错误,应停止任务并告警。
服务端可能已保存分片,客户端却因超时不知道结果。不要立即换一个编号重复提交,也不要直接把本地记录标为成功。恢复时调用 ListParts:若对应编号和大小已存在,可将其视作服务端已接收;若不存在,再上传该片。再次以相同编号上传通常会替换该编号对应的分片,因此要确保内容来自同一份未变化的文件。
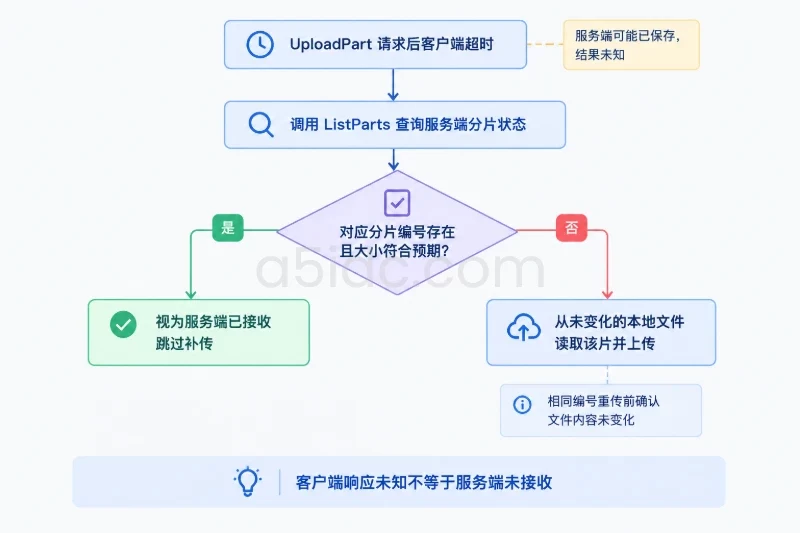
保留 UploadId 和任务记录,区分短暂故障与确定性错误。网络抖动可等待后重试;鉴权失败应先修复权限,不要靠增加重试次数掩盖问题。客户端重启后先检查任务记录与文件身份,再查询服务端分片列表。若服务端返回上传任务不存在,说明任务可能已被取消、过期清理或已经合并,不能盲目重新创建并认为原任务仍可续传。
合并请求可能已经成功,但响应丢失。此时直接重新创建上传任务会产生重复对象或遗留分片任务。先对对象执行 HeadObject,结合对象键、大小和业务上传标识判断是否已经完成。生产设计可在对象元数据中写入稳定的业务任务 ID,或由业务数据库记录合并状态。只有确认对象未完成且原上传任务仍有效时,才继续原任务;如果服务端提示 NoSuchUpload,还需核对对象是否已经生成,再决定标记完成或重新发起上传。
合并请求要求提供有效分片编号及对应 ETag。提交前应从服务端状态重建清单,确保编号连续且顺序正确。若服务返回分片缺失或 ETag 不匹配,重新查询 ListParts,定位缺失片或客户端状态不一致的片,修正清单后再提交;不要把响应顺序当作分片顺序。
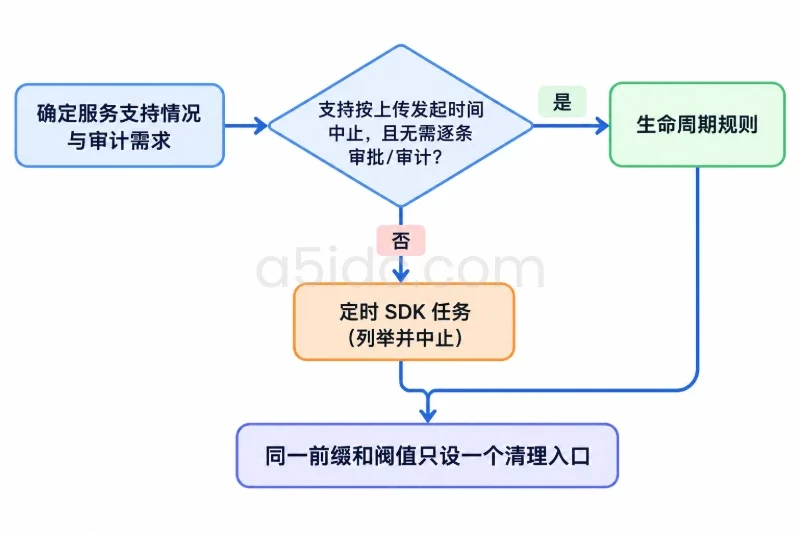
用户取消、业务单据作废或上传长期无人恢复时,应调用 AbortMultipartUpload 释放未完成任务占用的空间。调用前核对上传任务与业务记录的关联,避免取消仍在使用的任务。还可在存储服务侧配置未完成分片的生命周期清理规则作为兜底,但清理周期应留出业务恢复窗口。规则的设置位置和行为因存储产品而异,配置后要用测试任务验证是否按预期生效。
上线前至少验证以下场景,并核对业务状态、存储对象和任务记录三者是否一致:
因此,判断分片上传是否真正具备断点续传能力,重点不是客户端是否保存了进度条,而是进程重启后能否凭任务标识查询服务端真实分片状态,并在请求超时、合并结果不明和文件变化时作出不同处理。部署验证时优先检查 UploadId 持久化、ListParts 恢复、合并后的对象核验,以及未完成任务的清理策略。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5824.html