香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


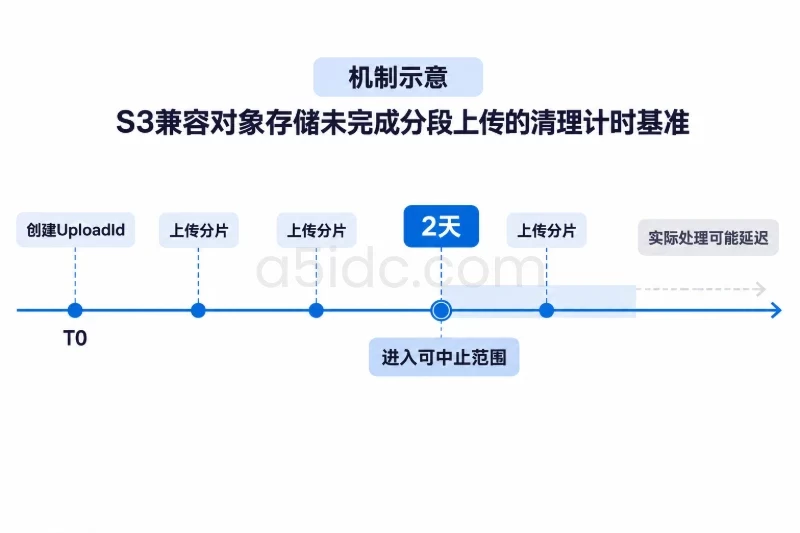
大文件上传中断后,已经上传的分段不会自动组成对象,也通常不会出现在普通对象列表中;如果不主动清理,它们可能继续占用存储空间并产生费用。常见做法是在对象存储桶上配置未完成分段的生命周期清理;如果存储服务不支持相应生命周期动作,或需要逐条审批和审计,则可用定时任务调用对象存储 API,筛选超过保留时间的分段上传并中止。
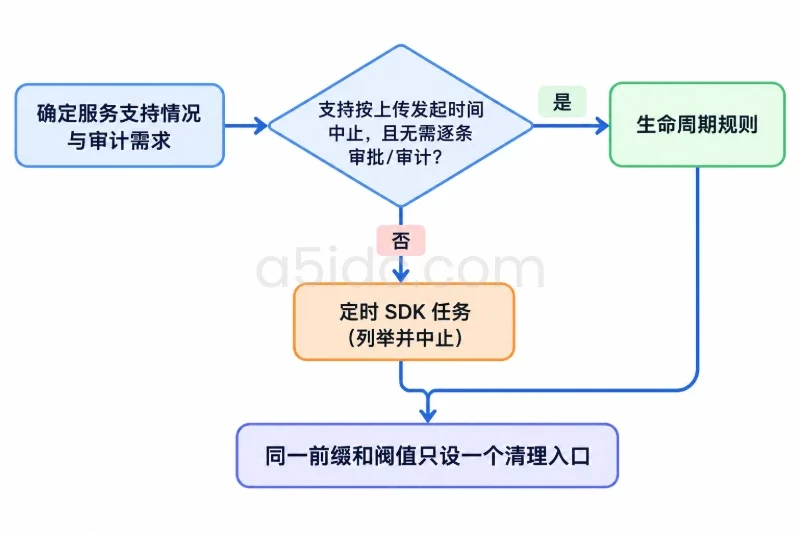
以下以 S3 API 兼容存储为例。不同服务对生命周期规则、权限名称和定时任务的支持可能不同,实施前应核对目标服务文档及其 S3 兼容性说明。清理阈值要大于正常上传可能持续的时间和重试窗口:例如上传通常在一天内完成,可先以七天作为评估值,而不是直接采用会影响长时间上传的短阈值。
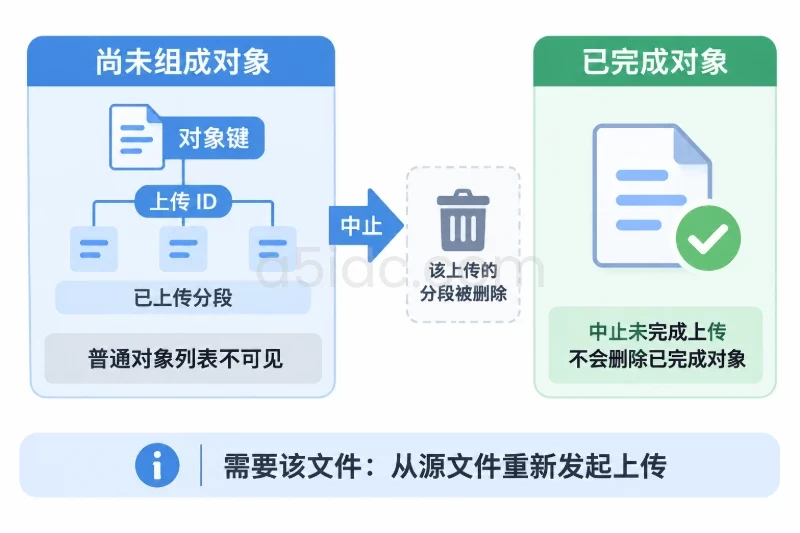
未完成的分段上传由对象键、上传 ID 和已上传的分段组成。中止上传会删除其已上传分段,不能通过回滚生命周期规则或恢复配置找回;若仍需要该文件,通常要从源文件重新发起上传。中止不会删除已经完成的对象,但应避免把“清理未完成上传”误配置成普通对象过期删除规则。
执行前至少确认以下条件:
uploads/ 下的上传。若多个应用共用一个前缀,应先确认该前缀下的上传都适用相同保留时间。普通对象列表接口只能说明已完成对象的状态,不能用来确认未完成的分段上传。排查和验收时应使用对象存储的“列出分段上传”接口。
若服务支持按上传发起时间中止未完成分段,生命周期规则通常比自行维护清理脚本更简单:清理由存储服务执行,无须长期运行一台清理主机或自行处理分页、重试和任务并发。
下面的示例仅清理 uploads/ 前缀下,发起时间已达到七天的未完成分段上传:
{
  "Rules": [
    {
      "ID": "abort-incomplete-uploads-7d",
      "Status": "Enabled",
      "Filter": {
        "Prefix": "uploads/"
      },
      "AbortIncompleteMultipartUpload": {
        "DaysAfterInitiation": 7
      }
    }
  ]
}
其中 DaysAfterInitiation 是示例值,应按实际上传时长和恢复窗口调整。Filter.Prefix 匹配对象键前缀;uploads/ 与 uploads 的匹配范围并不相同,应使用业务实际采用的命名方式。生命周期动作通常不是即时执行,规则达到阈值后,符合条件的上传可能还要等待存储服务处理。
生命周期配置可能还包含已完成对象的转储、过期或其他业务规则。直接提交只含清理规则的配置,有覆盖现有规则的风险。先检查并保存当前配置:
BUCKET="example-bucket"

aws s3api get-bucket-lifecycle-configuration \
  --bucket "$BUCKET" \
  --output json > lifecycle-before.json
如果命令返回“没有生命周期配置”,应确认这确实是该服务表示空配置的响应;不要把权限错误、网络错误或其他 API 失败当成空配置处理。若已有规则,将新规则合并进原配置,并检查所有规则的范围与状态。
应用完整配置:
aws s3api put-bucket-lifecycle-configuration \
  --bucket "$BUCKET" \
  --lifecycle-configuration file://lifecycle.json
对 AWS CLI 而言,这个操作提交的是桶的生命周期配置,而不是只追加一个规则。执行前应检查 lifecycle.json 是否保留了所有既有规则。若变更后发现配置错误,可将保存的旧配置重新提交:
aws s3api put-bucket-lifecycle-configuration \
  --bucket "$BUCKET" \
  --lifecycle-configuration file://lifecycle-before.json
恢复配置只能停止或改变后续规则,不能恢复已经中止的上传;对已被服务排队处理的动作,也不要假定恢复配置能撤销处理结果。
在 Terraform 管理的环境中,可把清理规则纳入桶的生命周期资源。例如:
resource "aws_s3_bucket_lifecycle_configuration" "uploads" {
  bucket = aws_s3_bucket.data.id

  rule {
    id     = "abort-incomplete-uploads-7d"
    status = "Enabled"

    filter {
      prefix = "uploads/"
    }

    abort_incomplete_multipart_upload {
      days_after_initiation = 7
    }
  }
}
部署前运行 terraform plan,查看变更是否会删除或替换现有生命周期规则。此类资源通常管理桶的整套生命周期配置,应把需要保留的其他规则一并纳入管理;不要让 Terraform 和人工命令分别维护同一桶的完整配置。执行 terraform apply 后,再通过服务 API 读取配置,确认规则 ID、状态、前缀和天数与计划一致。
如果目标存储不支持未完成分段的生命周期动作,或者需要逐条审计,可以使用 SDK 定期列出符合条件的上传并调用中止接口。先以默认的“只报告”模式运行,审核候选记录后再加上执行参数。下面的 Python 示例需要安装 boto3,使用 SDK 默认凭据链获取权限;可选的 AWS_REGION 和 S3_ENDPOINT_URL 用于设置区域或兼容服务端点。
#!/usr/bin/env python3
import argparse
import logging
import os
import sys
from datetime import datetime, timedelta, timezone

import boto3
from botocore.exceptions import ClientError


def main():
    parser = argparse.ArgumentParser(
        description="清理指定前缀下超龄的未完成分段上传"
    )
    parser.add_argument("--bucket", required=True)
    parser.add_argument("--prefix", required=True)
    parser.add_argument("--older-than-days", type=int, required=True)
    parser.add_argument(
        "--execute",
        action="store_true",
        help="实际中止上传;不指定时只报告候选项",
    )
    args = parser.parse_args()

    if args.older_than_days < 1:
        parser.error("--older-than-days 必须大于或等于 1")

    logging.basicConfig(
        level=logging.INFO,
        format="%(asctime)s %(levelname)s %(message)s",
    )

    client_args = {}
    region = os.getenv("AWS_REGION")
    endpoint = os.getenv("S3_ENDPOINT_URL")
    if region:
        client_args["region_name"] = region
    if endpoint:
        client_args["endpoint_url"] = endpoint

    s3 = boto3.client("s3", **client_args)
    cutoff = datetime.now(timezone.utc) - timedelta(days=args.older_than_days)
    paginator = s3.get_paginator("list_multipart_uploads")

    candidates = 0
    aborted = 0
    failures = 0

    try:
        for page in paginator.paginate(
            Bucket=args.bucket,
            Prefix=args.prefix,
        ):
            for upload in page.get("Uploads", []):
                key = upload["Key"]
                upload_id = upload["UploadId"]
                initiated = upload["Initiated"]

                # 再次核对前缀,避免配置或兼容行为异常导致扩大范围。
                if not key.startswith(args.prefix) or initiated > cutoff:
                    continue

                candidates += 1

                if not args.execute:
                    logging.info(
                        "DRY_RUN bucket=%s key=%r upload_id=%s initiated=%s",
                        args.bucket, key, upload_id, initiated.isoformat(),
                    )
                    continue

                try:
                    s3.abort_multipart_upload(
                        Bucket=args.bucket,
                        Key=key,
                        UploadId=upload_id,
                    )
                    aborted += 1
                    logging.info(
                        "ABORTED bucket=%s key=%r upload_id=%s initiated=%s",
                        args.bucket, key, upload_id, initiated.isoformat(),
                    )
                except ClientError as exc:
                    code = exc.response.get("Error", {}).get("Code", "Unknown")
                    if code == "NoSuchUpload":
                        # 可能有上传客户端或其他清理任务已处理该上传。
                        logging.info(
                            "ALREADY_GONE bucket=%s key=%r upload_id=%s",
                            args.bucket, key, upload_id,
                        )
                    else:
                        failures += 1
                        logging.exception(
                            "ABORT_FAILED bucket=%s key=%r upload_id=%s code=%s",
                            args.bucket, key, upload_id, code,
                        )
    except ClientError:
        logging.exception("无法列出指定桶的未完成分段上传")
        return 2

    logging.info(
        "完成 candidates=%d aborted=%d failures=%d execute=%s",
        candidates, aborted, failures, args.execute,
    )
    return 1 if failures else 0


if __name__ == "__main__":
    sys.exit(main())
先检查候选项,不加 --execute:
python3 mpu-cleaner.py \
  --bucket example-bucket \
  --prefix uploads/ \
  --older-than-days 7
确认桶名、前缀、发起时间和数量都符合预期后,再执行:
python3 mpu-cleaner.py \
  --bucket example-bucket \
  --prefix uploads/ \
  --older-than-days 7 \
  --execute
该脚本按精确经过的时间计算阈值;生命周期服务可能按自身规则处理“天数”,两者不保证在同一分钟触发。不要用单次测试的执行时刻推断生命周期的具体清理时刻。
可通过现有任务调度平台运行脚本;若使用 cron,下面的例子每天凌晨 3:17 执行,并将输出追加到日志:
17 3 * * * /usr/bin/python3 /opt/mpu-cleaner.py --bucket example-bucket --prefix uploads/ --older-than-days 7 --execute >> /var/log/mpu-cleaner.log 2>&1
上线前先以相同的运行用户执行只读模式,确认 Python 环境、网络、凭据和目标范围正常。脚本不应把访问密钥写在文件或命令参数里;优先使用主机角色、工作负载身份或服务本身支持的短期凭据。日志可能包含对象键和上传 ID,应按运维日志管理,限制读取权限并设置适当保留时间。
清理任务应只获得完成工作所需的权限:列举指定桶的未完成分段上传,以及对指定对象键范围执行中止。配置生命周期规则的身份则需要读取和写入桶生命周期配置的权限。服务商的 API 和权限名称可能不同,授权策略应按目标服务文档核对;避免给任务账号无关的桶管理或对象删除权限。
生命周期规则与定时脚本不要在同一前缀、同一阈值下重复承担清理工作。选择一个作为清理入口,另一个用于监测时也要明确它只读,避免重复中止或难以判断清理记录来自哪里。
应用生命周期配置后,读取配置并逐项核对;运行定时脚本后,检查任务退出码、日志和下一轮列举结果。生命周期清理具有异步性,短时间内仍能列出已达到阈值的上传,不一定表示配置无效;应先确认规则已启用、前缀匹配、阈值正确,并留出服务处理时间。
AWS CLI 可列出指定前缀下的未完成分段上传:
aws s3api list-multipart-uploads \
  --bucket "$BUCKET" \
  --prefix "uploads/" \
  --query 'Uploads[].{Key:Key,UploadId:UploadId,Initiated:Initiated}' \
  --output table
检查时应关注:
NoSuchUpload。普通对象清单中的对象数量不能代替分段上传列表作为验收依据。清理前后,对象清单可能完全不变,因为未完成的分段原本就不是已完成对象。
清理任务没有列出任何上传时,先核对桶、前缀和执行身份,再用分段上传列表接口检查是否确实存在目标上传。也要确认上传客户端使用的对象键是否落在规则前缀内;命令中的 uploads/ 不会自动匹配其他路径。
有候选项但中止时报权限错误时,检查列举权限与中止权限是否分别授予了正确资源范围。不要为了快速验证临时授予整个账号的管理权限;可先在测试桶验证策略,再按实际服务的权限模型收窄范围。
出现 NoSuchUpload时,可能是客户端已完成或放弃上传,也可能是另一清理任务已中止它。该响应不应被当成可恢复分段的证据。重新列举并确认状态;若上传本应成功,检查业务端是否已完成对象并记录最终上传结果。
误中止了仍在进行的上传时,已删除的分段无法从生命周期配置中恢复。先停用定时任务或禁用相应规则,避免继续扩大影响;再由上传端使用源文件重新发起上传,并核对应用是否妥善处理失效的上传 ID。若使用生命周期规则,修改桶配置前先保存当前配置并检查所有规则;若使用脚本,移除调度任务或取消其执行权限,并确认是否存在并行实例。已被服务处理或已执行的中止操作,不能通过恢复旧配置撤销。
上线前可按以下清单验收:
面向大文件、备份与归档等存储场景,A5idc数据提供香港存储系列物理服务器,配有多块企业级机械硬盘及H730控制器;日本CTG系列也有大容量HDD和多盘SSD方案,可为自建文件存储环境及相关数据管理工作负载提供硬件资源。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9789.html