香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


节点排空卡住时,先检查工作负载是否允许被安全驱逐,而不是马上加上 --force、--delete-emptydir-data 或关闭驱逐保护。最常见的直接原因是 PodDisruptionBudget(PDB)没有可用的中断配额;其次是 DaemonSet、未被控制器管理的 Pod、本地临时数据、存储挂载或替换 Pod 无法调度。
从运维排障角度,应先确认到底是哪一个 Pod 阻塞了排空,再按“PDB → 控制器与副本 → 本地数据与存储 → 调度约束 → Pod 终止与节点组件”的顺序检查。这样可以先处理低风险的配置和容量问题,避免在原因不明时删除 Pod 或强制拆除存储。
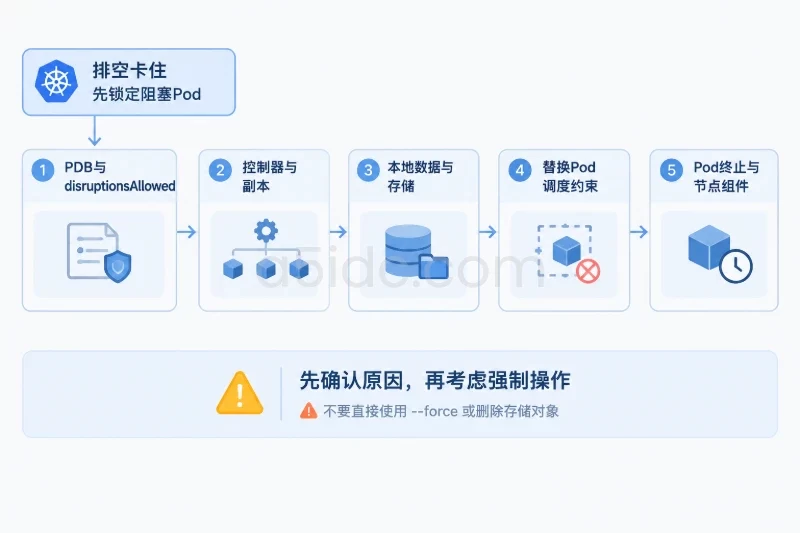
以下命令以 Linux 或 macOS 的 Bash 环境为例,执行账号需要具备查看节点、Pod、事件和 PDB 的权限。先设置待维护节点名称,并确认当前集群上下文,防止在错误集群执行排空操作。
NODE=worker-a

kubectl config current-context
kubectl version --client
kubectl get node "$NODE" -o wide
kubectl describe node "$NODE"
重点查看以下信息:
Ready。MemoryPressure、DiskPressure 或 PIDPressure。SchedulingDisabled。如果还没有开始排空,建议先执行封锁节点。cordon 只会阻止新的 Pod 调度到该节点,不会删除已有 Pod,风险低于直接执行 drain。
kubectl cordon "$NODE"
kubectl get node "$NODE"
预期结果中会看到 SchedulingDisabled。如果发现节点状态异常、维护窗口被取消,可以用下面的命令撤销封锁:
kubectl uncordon "$NODE"
但如果节点本身存在硬件、内核、磁盘或 kubelet 故障,不要为了恢复调度而立即执行 uncordon。
查看节点上的全部 Pod:
kubectl get pods --all-namespaces \
  --field-selector spec.nodeName="$NODE" \
  -o wide
再查看近期事件:
kubectl get events --all-namespaces --sort-by=.lastTimestamp
如果已经执行过排空命令,可以在授权的维护窗口内使用较短超时重现输出。该命令会实际发起驱逐,不是只读检查,因此不要在没有确认影响范围时重复执行。
kubectl drain "$NODE" \
  --ignore-daemonsets \
  --timeout=60s \
  --v=6
--timeout=60s 只限制客户端等待时间,并不会撤销已经发出的 Pod 驱逐请求。命令超时后,Pod 可能仍处于 Terminating,所以应先根据输出锁定 Pod,而不是不断重试。
常见提示与第一判断如下:
| 排空输出或现象 | 优先检查位置 | 通常意味着什么 |
|---|---|---|
Cannot evict pod as it would violate the pod's disruption budget | PDB 状态、Pod 就绪状态 | 当前没有足够的可用中断配额 |
pod managed by DaemonSet | DaemonSet、--ignore-daemonsets | 该 Pod 由 DaemonSet 管理,通常应保留在节点上 |
cannot delete Pods not managed by a ReplicationController | ownerReferences、静态 Pod | Pod 没有普通控制器接管,删除后可能不会自动恢复 |
pod has local storage | emptyDir、hostPath、本地 PV | 删除 Pod 可能丢失节点本地数据 |
| 长时间等待后超时 | Pod 删除时间、生命周期钩子、kubelet、CSI | Pod 没有完成终止,或节点组件没有正常响应 |
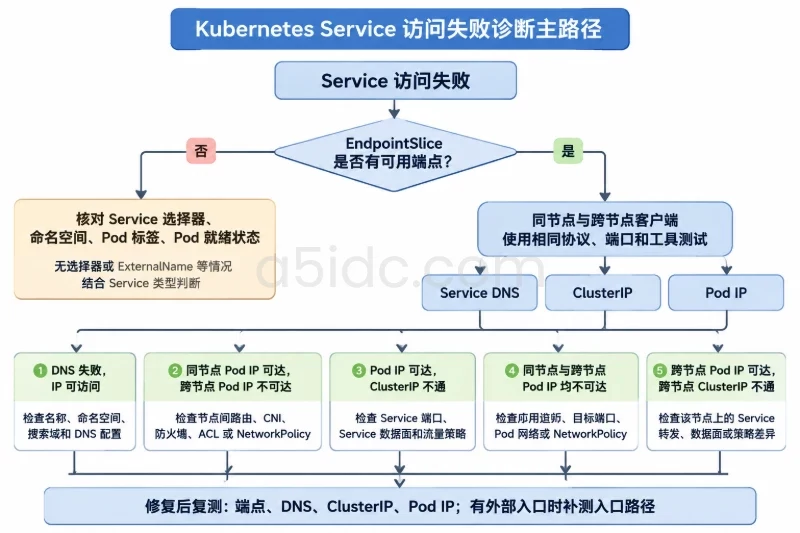
替换 Pod 长时间 Pending | 资源、污点、亲和性、拓扑约束 | 新 Pod 没有符合条件的目标节点 |
PDB 是节点排空中最容易被误判的配置。它保护的是应用在自愿中断场景下的最低可用数量,kubectl drain 默认会优先使用 Eviction API,因此会受到 PDB 限制。
先列出所有命名空间的 PDB:
kubectl get pdb --all-namespaces \
  -o custom-columns='NAMESPACE:.metadata.namespace,NAME:.metadata.name,MIN:.spec.minAvailable,MAX:.spec.maxUnavailable,CURRENT:.status.currentHealthy,DESIRED:.status.desiredHealthy,ALLOWED:.status.disruptionsAllowed,EXPECTED:.status.expectedPods'
重点看 ALLOWED,也就是 disruptionsAllowed:
0:至少当前 PDB 允许一定数量的驱逐,但还要继续确认 Pod 是否被其他 PDB、存储或终止状态阻塞。0:当前不能再驱逐符合该 PDB 选择器的 Pod。EXPECTED 为 0 或状态信息不完整:可能是 PDB 选择器没有匹配到预期工作负载,或者控制器状态尚未收敛,不能只凭名称判断配置是否正确。查看具体 PDB:
kubectl describe pdb -n payments payments-pdb
kubectl get pdb -n payments payments-pdb -o yaml
例如,一个典型配置可能如下:
apiVersion: policy/v1
kind: PodDisruptionBudget
meta
  name: payments-pdb
  namespace: payments
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: payments
若该应用期望运行 3 个副本,但其中 1 个 Pod 处于未就绪状态,PDB 可能显示:
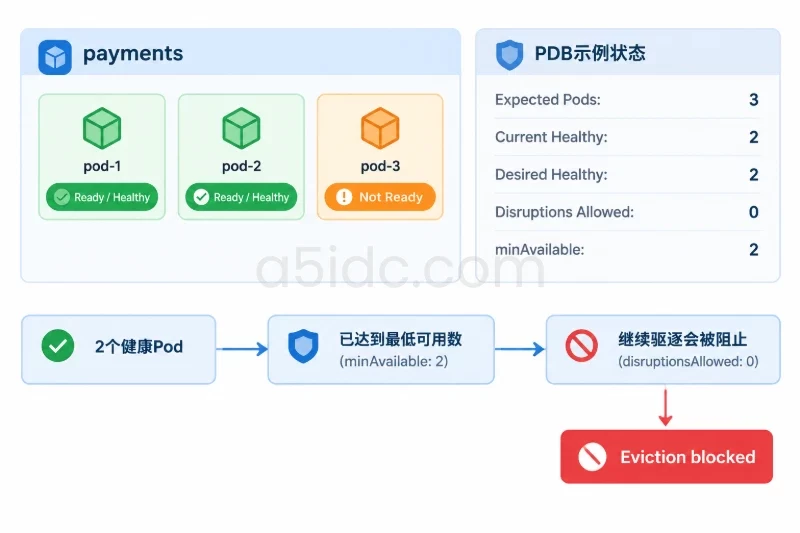
Expected Pods: 3
Current:        2
Desired:        2
Disruptions Allowed: 0
这表示当前已经只剩下最低要求的 2 个健康 Pod,再驱逐 1 个就会低于 minAvailable: 2,因此排空会停住。
PDB 不通过 Deployment 或 StatefulSet 名称关联工作负载,而是通过标签选择器匹配 Pod。先查看选择器,再核对 Pod 标签:
kubectl get pdb -n payments payments-pdb \
  -o jsonpath='{.spec.selector}{"\n"}'

kubectl get pods -n payments --show-labels
需要重点排除三类配置问题:
matchLabels 过于宽泛,意外匹配了多个应用的 Pod。matchLabels 和 matchExpressions,实际匹配范围比预想更大。如果多个 PDB 都匹配同一个 Pod,应逐个检查它们的 disruptionsAllowed。不要只看到其中一个 PDB 有配额,就认为排空一定可以继续。
minAvailable 和 maxUnavailable 不能同时设置。常见影响如下:
maxUnavailable: 0 会禁止任何自愿中断。minAvailable 等于当前副本数时,也会让 disruptionsAllowed 变成 0。Running 数量。如果 PDB 的值符合业务要求,优先恢复未就绪 Pod、增加可用副本或补充可调度节点。不要为了完成维护直接删除 PDB。删除 PDB 没有自动回滚能力,而且会让其他排空、升级或节点故障同时失去应用中断保护。
如果确认 PDB 配置本身错误,应先保存当前配置,并在 Deployment、Helm 或 GitOps 的配置源中修改,而不是只修改集群内对象:
kubectl get pdb -n payments payments-pdb -o yaml > payments-pdb.backup.yaml
修改后应重新检查 currentHealthy、desiredHealthy 和 disruptionsAllowed。如果变更造成业务风险,回滚配置源中的变更,再重新应用经过审核的版本。直接把带有旧 resourceVersion 或运行时状态的完整 YAML 原样覆盖回集群,可能产生冲突,因此备份文件主要用于比对和恢复配置内容。
PDB 没有明显问题时,检查阻塞 Pod 是否由 Deployment、StatefulSet、Job 或其他控制器管理。
POD=payments-7d9c6f7d8b-abcde
NS=payments

kubectl get pod "$POD" -n "$NS" \
  -o jsonpath='{range .metadata.ownerReferences[*]}{.kind}/{.name}{"\n"}{end}'

kubectl get pod "$POD" -n "$NS" -o yaml
如果 ownerReferences 为空,通常说明它可能是:
排空默认不愿意删除没有控制器接管的 Pod,因为删除后不一定会重新创建。此时不要直接使用 --force。先确认该 Pod 是否有配置文件、镜像参数、挂载卷和业务数据,再将它纳入 Deployment、StatefulSet 或其他适合的控制器管理。
如果 Pod 属于 DaemonSet,检查对应 DaemonSet:
kubectl get daemonset --all-namespaces -o wide
kubectl describe daemonset -n kube-system kube-proxy
排空时使用 --ignore-daemonsets 的含义是“忽略并保留 DaemonSet Pod”,不是删除它们。节点上仍能看到这类 Pod 属于预期结果。只有在 DaemonSet 本身需要迁移、缩容或变更节点选择器时,才应修改 DaemonSet 配置。
静态 Pod 通常由节点上的 kubelet 根据本地清单创建,API Server 中看到的对象可能带有 mirror pod 相关注解。删除 API 对象通常不能解决问题,因为 kubelet 仍会根据本地清单重新创建它。处理静态 Pod 前,必须确认节点登录权限、清单路径、组件职责和回滚文件,避免误删控制面或节点关键组件。
如果排空提示 pod has local storage,先查看 Pod 的卷定义:
kubectl get pod "$POD" -n "$NS" -o yaml
kubectl describe pod "$POD" -n "$NS"
重点查找:
emptyDir;hostPath;preStop 生命周期钩子和较长的 terminationGracePeriodSeconds。emptyDir 的数据只存在于当前节点。--delete-emptydir-data 会允许排空删除使用 emptyDir 的 Pod,但不会把数据迁移到新节点,容器重建后这些内容也不会自动恢复。只有确认数据是缓存、临时文件或已经备份,并得到业务负责人确认后,才可以考虑使用该选项。
hostPath 和本地 PV 的风险更高,因为数据可能直接依赖节点文件系统。应先确认数据目录、备份状态、应用一致性和恢复方案。对数据库、消息队列或其他持久化服务,不要通过强制删除 Pod 来“解决”挂载问题。
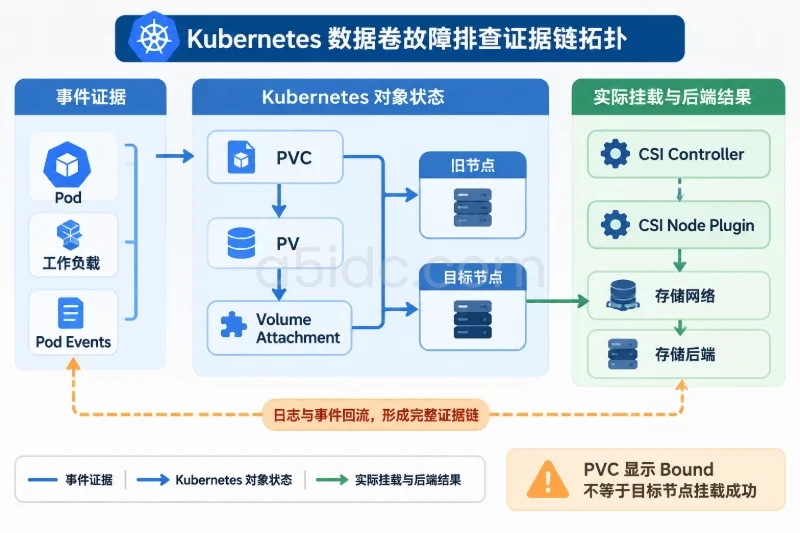
对于 CSI 卷,可以查看 PVC、PV 和 VolumeAttachment:
kubectl get pvc -n "$NS"
kubectl describe pvc -n "$NS" PVC_NAME

kubectl get volumeattachment.storage.k8s.io -o wide
kubectl describe volumeattachment.storage.k8s.io VOLUME_ATTACHMENT_NAME
如果卷仍显示挂载在旧节点,或者 CSI 控制器报告 detach、attach、节点访问错误,应先处理存储系统和节点连接问题。不要手工删除 VolumeAttachment、PV 或 PVC 来加速排空,这可能导致卷仍被旧节点使用时发生数据损坏或双重挂载。
当节点失联而卷仍被认为挂载时,还需要确认存储平台是否支持节点级 fencing。没有完成 fencing 前,强制让卷在新节点上线会带来脑裂风险。此类操作应遵循存储驱动和云平台的维护流程,而不是套用通用的 kubectl delete 命令。
PDB 只解决“能不能中断”,不解决“新的 Pod 能不能找到位置”。排空过程中,如果旧 Pod 已经被驱逐,但新 Pod 因调度约束处于 Pending,后续驱逐可能再次被 PDB 阻止。
检查控制器和副本:
kubectl get deployment,statefulset,replicaset -n "$NS" -o wide
kubectl get pods -n "$NS" -o wide
查看处于 Pending 的替换 Pod:
kubectl describe pod -n "$NS" PENDING_POD_NAME
kubectl get events -n "$NS" --sort-by=.lastTimestamp
事件中的以下提示很有代表性:
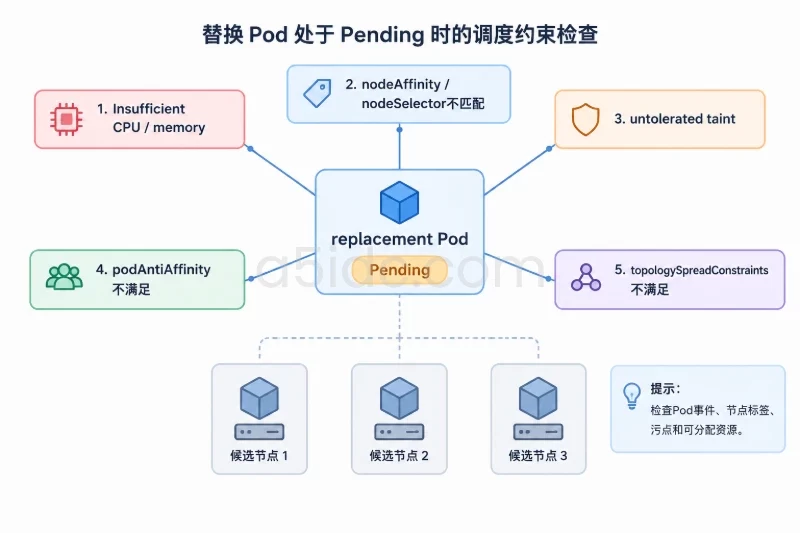
Insufficient cpu 或 Insufficient memory:其他节点没有足够可分配资源。didn't match Pod's node affinity/selector:节点亲和性或节点选择器没有匹配目标。had untolerated taint:目标节点有污点,而 Pod 没有对应容忍。didn't satisfy existing anti-affinity rules:Pod 反亲和性阻止了共置。node(s) didn't match topology spread constraints:拓扑分布约束无法满足。查看 Pod 配置中的调度字段:
kubectl get pod -n "$NS" PENDING_POD_NAME -o yaml
kubectl get nodes --show-labels
kubectl get nodes -o custom-columns='NAME:.metadata.name,TAINTS:.spec.taints'
重点检查:
nodeSelector;nodeAffinity 和 podAntiAffinity;topologySpreadConstraints;tolerations;节点被 cordon 后不会再接收新的 Pod,因此如果一个工作负载只有当前节点符合亲和性条件,替换 Pod 可能没有落点。修复顺序通常是先补充符合条件的节点或释放资源,再考虑调整应用约束。直接删除亲和性、反亲和性或拓扑分布配置,可能改变副本隔离和故障域分布,应先保存原始清单,并在维护完成后按计划恢复。
如果必须临时扩容以满足 PDB,可以先确认集群容量和业务承载能力,再将副本数增加到可用状态。扩容后要观察新副本是否真正 Ready,而不是只看 Deployment 的期望副本数。维护完成并确认服务稳定后,再按原配置缩回副本数,缩容动作也要考虑 PDB 和业务流量。
如果阻塞对象已经带有 deletionTimestamp,说明驱逐请求已经被接受,问题从“能不能驱逐”转为“为什么没有完成终止”。
kubectl get pod "$POD" -n "$NS" \
  -o jsonpath='deletionTimestamp={.metadata.deletionTimestamp} phase={.status.phase} node={.spec.nodeName}{"\n"}'

kubectl describe pod "$POD" -n "$NS"
重点检查:
preStop 钩子是否等待外部服务;terminationGracePeriodSeconds 是否很长;如果是应用退出缓慢,应先查看应用日志和生命周期钩子的执行逻辑。排空命令的超时不等于 Pod 的优雅终止时间,不能因为客户端超时就立即强制删除。
如果存在 finalizer,应先找出负责移除它的控制器或外部系统。直接清空 finalizer 可能跳过资源清理、解绑或数据保护流程,且通常没有可逆回滚。只有确认该 finalizer 已失效、资源不再需要清理,并完成配置和数据备份后,才应在明确的应急流程中处理。
如果 Pod 删除后仍留在节点上,检查节点状态和 kubelet 日志。以下命令适用于使用 systemd 管理 kubelet 的 Linux 节点,只读查看不会重启服务:
kubectl describe node "$NODE"

sudo systemctl status kubelet --no-pager
sudo journalctl -u kubelet -n 100 --no-pager
如果节点存在磁盘压力、容器运行时无响应或网络中断,应先恢复节点组件。直接重启 kubelet、容器运行时或节点可能影响该节点上所有 Pod,因此需要维护窗口、监控确认和节点级回滚方案。不要把重启组件当作 PDB 或存储问题的替代处理。
disruptionsAllowed=0先确认是应用不健康、容量不足,还是 PDB 配置过严:
Ready 状态和最近事件。Ready。不建议直接删除 PDB,也不建议使用 --disable-eviction 绕过 Eviction API。该选项会改变 PDB 保护边界,可能让节点维护与应用故障同时发生。
如果排空输出明确表明剩余对象由 DaemonSet 管理,并且普通工作负载已经迁移,通常不应把这些 Pod 视为排空失败。确认节点上没有其他业务 Pod 后,可以继续节点维护。
如果是静态 Pod,则检查节点清单和组件职责。删除 API 中的镜像对象通常不能持久解决问题,修改静态清单前要保留原文件并准备恢复动作。
先建立可恢复的控制器清单和数据备份,再决定是迁移、重建还是保留节点。--force 删除未被控制器管理的 Pod 后,Kubernetes 不会保证它自动回来;--delete-emptydir-data 也不会迁移 emptyDir 内容。这两类操作都没有针对已删除数据的命令级回滚。
Pending优先解决资源、污点、节点标签、亲和性和拓扑分布约束。修改调度配置时保存原始清单,并确认变更不会把多个副本集中到同一故障域。仅提高 PDB 配额不能解决“没有可调度节点”的问题。
Terminating先处理应用退出、finalizer、kubelet、容器运行时和 CSI 清理。强制删除 Pod 可能只移除 API 对象,不一定让节点上的进程立即停止,也不会自动解除底层存储占用。对有状态服务,强制删除前必须确认进程已停止、卷已安全隔离,并有恢复方案。
Kubernetes 节点维护涉及工作负载迁移、资源承载与数据存储,底层服务器资源也会影响集群的部署选择。A5数据提供香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地的物理服务器,覆盖常规计算、AMD 平台及多种 SSD、NVMe 和大容量硬盘配置,可为不同地区的容器集群、业务后台与数据服务提供硬件和网络资源基础。
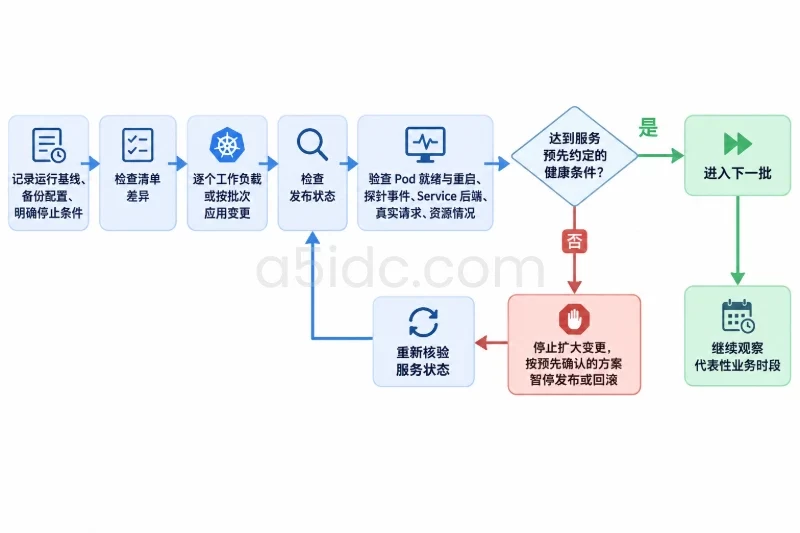
修复后不要只根据 kubectl drain 命令返回成功判断维护完成。先确认目标节点上的普通工作负载已经离开:
kubectl get pods --all-namespaces \
  --field-selector spec.nodeName="$NODE" \
  -o wide
剩余对象如果是 DaemonSet 或静态 Pod,应与预期清单逐一核对。再检查工作负载、副本和 PDB:
kubectl get deployment,statefulset --all-namespaces -o wide
kubectl get pdb --all-namespaces
kubectl get pods --all-namespaces -o wide
重点确认:
Running 且 Ready;Pending、CrashLoopBackOff 或持续 Terminating;currentHealthy 达到 desiredHealthy;disruptionsAllowed 没有因替换失败再次降为 0;如果节点维护已经完成且节点状态正常,再解除封锁:
kubectl uncordon "$NODE"
kubectl get node "$NODE"
解除封锁后继续观察几个控制器协调周期,并关注节点事件、Pod 就绪状态、业务错误率和存储挂载状态:
kubectl get pods --all-namespaces -o wide
kubectl get events --all-namespaces --sort-by=.lastTimestamp
如果复测发现新 Pod 又被调度回故障节点、PDB 再次变为零,或存储对象仍指向旧节点,应重新封锁节点并回到对应分支排查。排空成功的标准不是“命令退出码为 0”,而是工作负载约束、应用健康状态、存储状态和节点维护状态都已经达到预期。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5626.html