香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


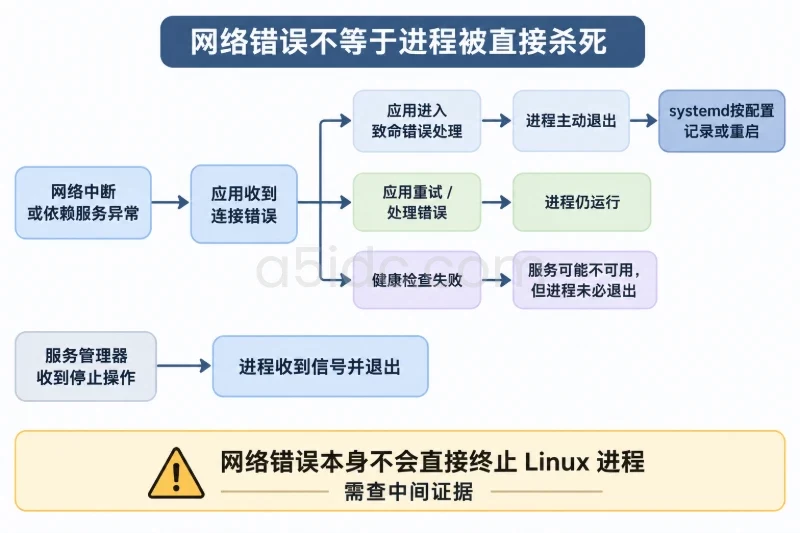
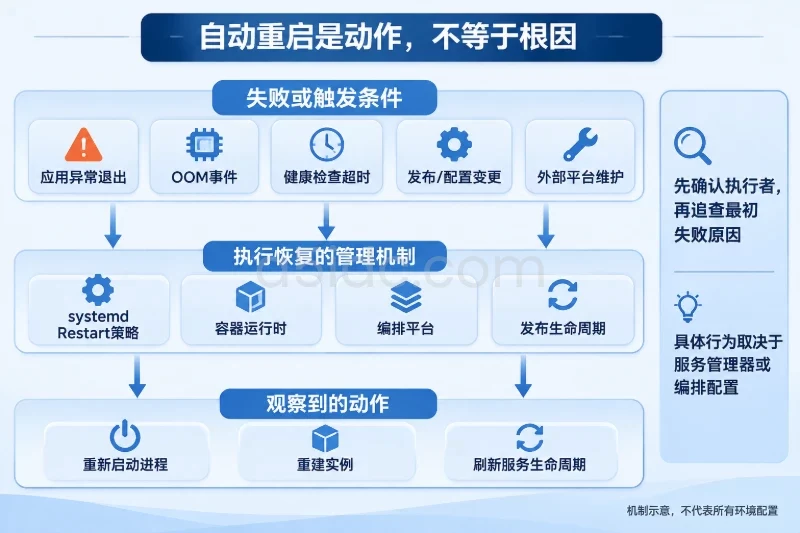
香港服务器上的接口偶尔返回 502,几秒后又恢复;监控显示进程 PID 不断变化,但服务器仍能登录。这类现象不能仅凭“服务重启了”判断原因:可能是主进程自行退出后被 systemd 拉起,也可能是内存不足被内核终止,或者是部署脚本、容器平台主动重建了进程。
排查时,我会先固定一次故障的时间窗口和服务标识,再把入口报错、服务管理器记录、应用日志、内核日志排成同一条时间线。最有价值的证据通常不是最后一条报错,而是“旧进程因什么退出、谁发起下一次启动、退出前发生了什么”。
以下命令以使用 systemd 的 Linux 服务器为例,myapp.service 应替换为实际单元名。先做只读检查,不急着调整重启策略。
date -Is
timedatectl
uptime -s
who -b
systemctl status myapp.service --no-pager -l
systemctl show myapp.service \
  -p ActiveState -p SubState -p Result \
  -p MainPID -p ExecMainCode -p ExecMainStatus \
  -p NRestarts -p Restart -p RestartUSec
date -Is 和 timedatectl 用于确认服务器当前时间与时区。服务器部署在香港,不代表系统时区一定是 Asia/Hong_Kong;应用、容器和监控平台也可能分别使用本地时间与 UTC。后续截取日志时,应先把它们换算到同一时区。uptime -s、who -b 若显示整机刚启动,还要把主机重启纳入调查,而不能只查应用。
MainPID 变化说明主进程被替换,但不直接说明是谁替换的。NRestarts 可辅助判断 systemd 是否反复自动拉起服务;它不是跨主机重启永久保存的事故总次数。Result、ExecMainCode 和 ExecMainStatus 提供最近一次运行结果,但新一轮启动可能覆盖部分状态,因此应尽快保存对应时间段的日志。
如果 Nginx 报 502,而应用 PID 始终未变,还应检查监听端口、上游连接和应用健康状态;此时把故障直接归为“服务重启”会走错方向。如果整机发生重启,则先调查上一次启动周期,而不是只看当前周期中“服务正常启动”的记录。
选定一次明确的故障窗口,例如监控报错前后各几分钟。下面的时间仅用于演示查询方式;journalctl --since、--until 输入的时间要按服务器本地时区填写。
入口日志用于确认业务受影响的时段。例如 Nginx 的错误日志中,connect() failed ... while connecting to upstream 可提示上游当时无法建立连接;upstream timed out 则不等同于进程退出,还可能是应用卡顿。应同时记录请求时间、上游地址、状态码以及应用的 PID 变化时刻。
随后查看 systemd 对该服务的记录:
journalctl -u myapp.service \
  --since "2025-03-08 10:00:00" \
  --until "2025-03-08 10:20:00" \
  -o short-iso-precise --no-pager
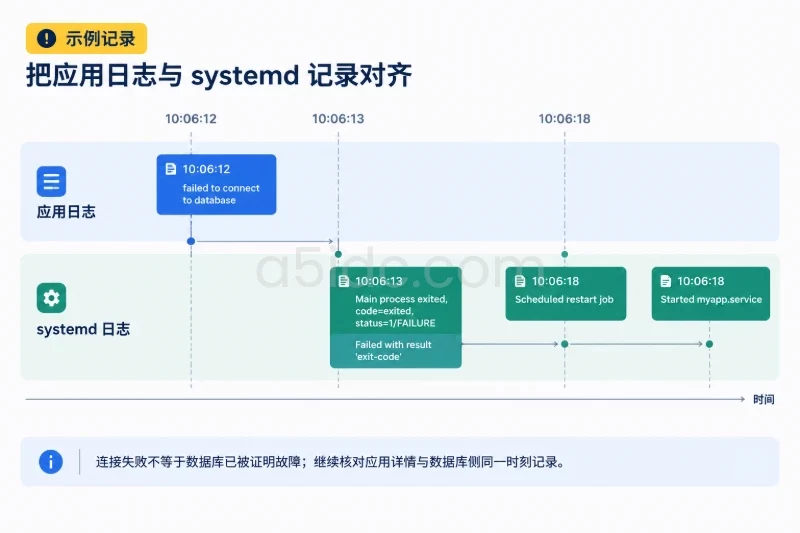
重点查找 Main process exited、Failed with result、Scheduled restart job、Started,以及启动前检查失败、超时等信息。一组示例记录可能呈现这样的顺序:
10:06:12 myapp[1842]: failed to connect to database
10:06:13 systemd[1]: myapp.service: Main process exited, code=exited, status=1/FAILURE
10:06:13 systemd[1]: myapp.service: Failed with result 'exit-code'.
10:06:18 systemd[1]: myapp.service: Scheduled restart job, restart counter is at 3.
10:06:18 systemd[1]: Started myapp.service.
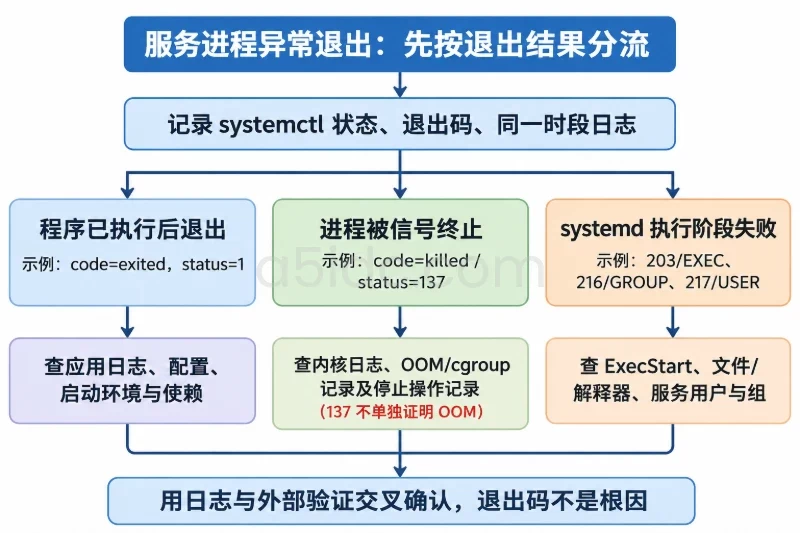
这组示例能说明:应用先报连接失败,主进程随后以退出码 1 结束,systemd 再执行自动重启。它还不能证明数据库本身故障;连接失败也可能由连接池耗尽、凭据变更或网络问题引起。下一步应核对应用错误详情及数据库侧同一时刻的记录。
若日志显示 code=exited, status=0/SUCCESS,说明主进程正常退出。此时若单元配置了 Restart=always,systemd 仍可能持续将其拉起。反过来,看到 status=9/KILL 等信号退出,也不能只凭一个数字断定发生了 OOM:人工终止、超时后的强制结束等都需要结合前后日志辨别。
应用日志可能在进程被突然终止前来不及写出最后一行。遇到 code=killed、日志戛然而止,或多个服务同时异常时,要查看内核和资源记录:
journalctl -k \
  --since "2025-03-08 10:00:00" \
  --until "2025-03-08 10:20:00" \
  -o short-iso-precise --no-pager

systemctl show myapp.service -p MemoryMax -p MemoryHigh
free -h
df -h
df -i
内核日志中若出现 Out of memory、Killed process,应核对被终止进程的名称和 PID 是否与服务当时的主进程相符。还要区分主机整体内存不足与服务的内存限制:MemoryMax 显示的是 systemd 单元限制;容器另有自身限制,不能只凭当前 free -h 的空闲内存排除历史上的内存压力。
df -h 检查空间,df -i 检查 inode。二者反映的是查询当下的状态;若应用在故障时曾报 No space left on device,但现在空间已经释放,应继续查临时文件清理、日志轮转及相关监控,不能用当前读数否定之前的报错。
若整机重启过,可先确认是否还能访问上一启动周期:
journalctl --list-boots
journalctl -b -1 -k --no-pager
journalctl -b -1 -u myapp.service --no-pager
-b -1 指上一个启动周期。若系统未持久保存 journal,或者日志已被轮转清理,这些命令可能查不到完整记录;“没有查到 OOM”不等于“没有发生 OOM”。此时应转向已配置的监控、集中日志或其他可保留历史记录的来源。
先读取单元定义,再判断重启是否符合其配置:
systemctl cat myapp.service
systemctl show myapp.service \
  -p Type -p Restart -p RestartUSec \
  -p TimeoutStartUSec -p TimeoutStopUSec \
  -p StartLimitIntervalUSec -p StartLimitBurst
读取配置时注意,单元文件可能引用含敏感信息的环境文件,不要将未经脱敏的完整内容贴到公开工单。Restart=on-failure 通常指向失败后的自动重启;Restart=always 还可能在正常退出后重启。若出现 start-limit-hit,含义是短时间内启动次数触及限制,服务可能已停止继续尝试;应先找前面几次退出的共同原因,而不是只处理最后这条提示。
还要检查同一时间是否有部署、定时任务、人工操作或主机维护记录。服务管理器显示“启动”只能证明它执行了启动动作,不一定能证明最初的停止是应用自己发起的。
| 观察到的结果 | 优先核对什么 | 判断边界 |
|---|---|---|
code=exited 且退出码非 0 | 应用退出前的异常、依赖连接、启动参数 | 退出码说明程序报告失败,不自动指明失败根因 |
code=exited, status=0/SUCCESS 后再次启动 | Restart 策略、程序是否本就会运行完毕、外部启动记录 | 正常退出不等于服务符合长期驻留的预期 |
code=killed 或日志突然中断 | 同时刻内核日志、内存限制、超时及人工操作记录 | 单看信号编号不足以认定 OOM |
| 启动后很快失败 | ExecStart、启动前检查、配置和权限报错、端口占用 | 要分清“未成功启动”与“运行中崩溃” |
| 多个不相关服务同时中断 | 主机启动周期、资源、磁盘及维护事件 | 共同时刻更值得先查主机层事件 |
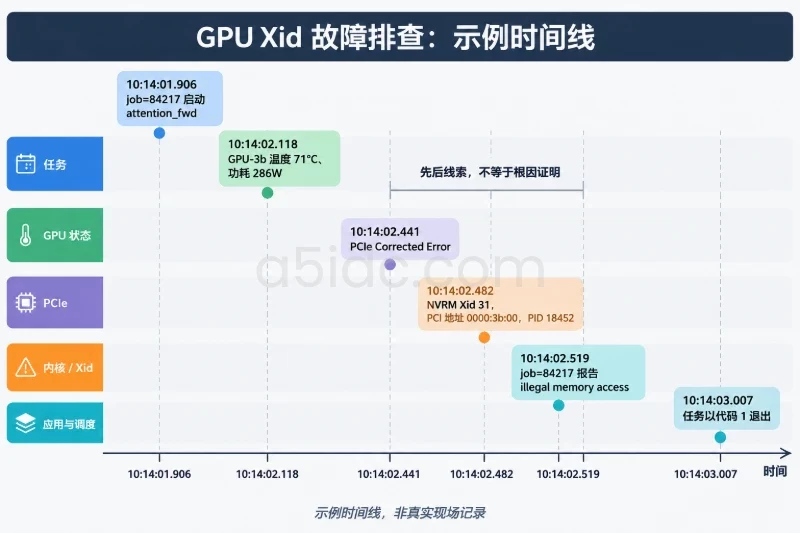
这里有一个重要的时间顺序:先发生的异常不一定就是根因,但后发生的入口报错通常只是影响表现。例如应用在 10:06:12 报配置读取失败,10:06:13 退出,10:06:14 Nginx 返回 502;排查重点应落在配置读取失败。若先有大量上游超时,数分钟后服务因健康检查或超时机制被重启,则还需调查重启前为何已经无法响应。
若 systemd 管理的是容器引擎,而应用运行在 Docker 容器内,仅查询 myapp.service 可能看不到应用真正的退出原因。可先确认容器状态,再查看对应时间的日志与事件。以下命令适用于已确认使用 Docker、且有权限读取相关信息的环境;容器名 myapp 需替换。
docker ps -a --filter "name=myapp"
docker inspect --format \
  'ExitCode={{.State.ExitCode}} OOMKilled={{.State.OOMKilled}} RestartCount={{.RestartCount}} StartedAt={{.State.StartedAt}} FinishedAt={{.State.FinishedAt}}' \
  myapp
docker logs --timestamps \
  --since "2025-03-08T02:00:00Z" \
  --until "2025-03-08T02:20:00Z" \
  myapp
docker events \
  --since "2025-03-08T02:00:00Z" \
  --until "2025-03-08T02:20:00Z" \
  --filter "container=myapp"
示例中 10:00–10:20 的香港时间对应 02:00–02:20 UTC。OOMKilled=true 是容器层的重要线索,仍应结合当时的限制、内核或平台记录确认。ExitCode=137 常见于收到强制终止信号的场景,却不能单独证明内存不足;RestartCount 增长也要结合重启策略与事件,区分容器自行重启和部署时被替换。若容器已被删除或重新创建,旧实例的检查结果可能无法从当前容器取得。
找到原因后再改动,避免用更激进的自动重启设置掩盖故障。应用退出码非 0,应先修复对应异常;确认是内存限制触发时,要同时评估峰值占用、并发与限制值;确认是部署或定时任务造成时,则修正触发流程和执行窗口。涉及配置、内存限制或服务单元变更,先备份原配置,明确会影响哪个实例、是否需要中断服务,并安排可回退的窗口。若变更后异常,恢复备份配置并按原发布流程重新加载或部署;不要在原因未明时批量重启所有实例。
复测应覆盖曾经触发故障的操作,而不仅是看到一次 active (running)。记录变更时间,再核对入口请求是否恢复、应用是否正常处理、PID 与重启计数是否继续变化,以及相同时间窗口内是否又出现退出与拉起记录。对于只在流量高峰或定时任务运行时出现的问题,观察期至少应覆盖对应场景;若暂时无法复现,就保留日志、内核事件和资源指标的采集,让下一次异常能够回答三个问题:何时开始、进程怎样退出、由谁重新启动。
A5数据提供多档香港物理服务器,涵盖Xeon Gold与AMD EPYC平台,并有不同内存、SSD或NVMe存储及CN2、国际带宽方案,可承载网站、业务后台、接口服务、数据库和容器化应用。在定位服务频繁重启的原因并完成修复后,这些计算、存储与网络资源也为业务按实际负载调整部署配置提供了选择。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5575.html