香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


已有 Nginx 或 Apache 访问日志时,要回答“某个时间段各状态码有多少请求”,不需要修改服务配置。先确认日志采用常见的 combined 格式,再用 awk 读取时间和状态码,把命中的请求同时计入“时间段 × 状态码”和“状态码总数”。关键是先按完整时间筛选,再归入整点或 15 分钟区间;否则查询从 14:10 开始时,容易把 14:00—14:09 的请求也算进去。
下面的命令只读取日志,不会清空、移动或改写文件。示例查询区间为日志所记时区的 2025-10-10 14:00:00 至 16:00:00,包含起点、不包含终点。
常见的 Nginx combined 日志大致如下:
192.0.2.10 - - [10/Oct/2025:14:05:09 +0800] "GET /index.html HTTP/1.1" 200 1234 "-" "ExampleClient/1.0"
在这种格式中,按空白分隔后的 $4 是 [10/Oct/2025:14:05:09,$5 是 +0800],$9 是状态码 200。Apache 常见的 combined 格式也可按这三个字段处理。但只要日志格式经过定制,就不能直接认定 $9 一定是状态码。
先在有读取权限的终端执行以下检查,将路径换成实际访问日志路径:
log=/var/log/nginx/access.log
ls -lh -- "$log"
awk 'NR <= 3 { print "time=" $4, "offset=" $5, "status=" $9 }' "$log"
期望看到类似输出:
time=[10/Oct/2025:14:05:09 offset=+0800] status=200
time=[10/Oct/2025:14:05:12 offset=+0800] status=404
核对原始日志后再判断这些字段是否对应。若文件不存在或无读取权限,应先核对服务实际使用的日志路径和当前账号权限,不要为了完成统计而更改生产日志权限。读取较大的日志会占用一定磁盘 I/O,可避开业务繁忙时段执行。
时间范围应按日志中的时区填写。上例的 +0800] 表示该行时间使用 UTC+08:00;命令不会自动把其他时区换算过来。如果同一批日志混有不同偏移量,需要先按时区分别统计,或使用能正确处理时区与夏令时的方式将时间统一后再汇总。
确认字段后执行下面的命令。minutes=60 表示按整点汇总,改为 minutes=15 则按每 15 分钟汇总。start 和 end 都必须填写完整的年月日与时分秒,tz 填写样本中看到的 $5 值。
log=/var/log/nginx/access.log

awk \
  -v start='2025-10-10 14:00:00' \
  -v end='2025-10-10 16:00:00' \
  -v tz='+0800]' \
  -v minutes=60 '
BEGIN {
    split("Jan Feb Mar Apr May Jun Jul Aug Sep Oct Nov Dec", names, " ")
    for (i = 1; i <= 12; i++) {
        month[names[i]] = i
    }
}
{
    read_lines++

    if ($4 !~ /^\[[0-9][0-9]\/[A-Z][a-z][a-z]\/[0-9][0-9][0-9][0-9]:[0-9][0-9]:[0-9][0-9]:[0-9][0-9]$/ ||
        $9 !~ /^[1-5][0-9][0-9]$/) {
        bad_format++
        next
    }

    split(substr($4, 2), t, /[\/:]/)
    if (!(t[2] in month) ||
        t[1] < 1 || t[1] > 31 ||
        t[4] > 23 || t[5] > 59 || t[6] > 59) {
        bad_format++
        next
    }

    if ($5 != tz) {
        wrong_tz++
        next
    }

    key = sprintf("%s-%02d-%s %s:%s:%s",
                  t[3], month[t[2]], t[1], t[4], t[5], t[6])

    if (key < start || key >= end) {
        outside++
        next
    }

    bucket = sprintf("%sT%s:%02d",
                     substr(key, 1, 10), t[4],
                     int(t[5] / minutes) * minutes)
    count[bucket, $9]++
    status_total[$9]++
    matched++
}
END {
    printf "CHECK read=%d matched=%d outside=%d wrong_tz=%d bad_format=%d\n",
           read_lines, matched, outside, wrong_tz, bad_format

    for (item in count) {
        split(item, parts, SUBSEP)
        printf "BUCKET %s %s %d\n", parts[1], parts[2], count[item]
    }
    for (code in status_total) {
        printf "STATUS %s %d\n", code, status_total[code]
    }
}' "$log" | LC_ALL=C sort -k1,1 -k2,2 -k3,3n
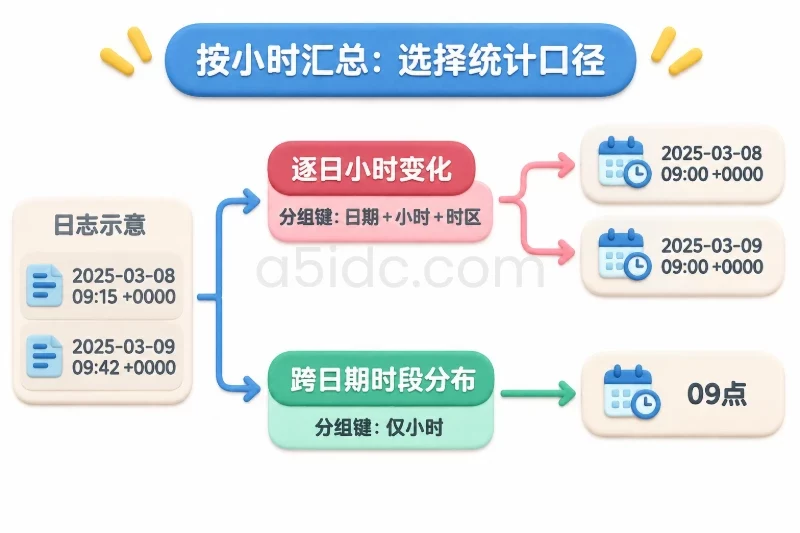
awk 先将日志时间转换为 YYYY-MM-DD HH:MM:SS,再判断它是否位于 [start, end)。只有通过筛选的记录才进入时间桶。例如选择 15 分钟时,14:23:45 会归入 14:15;选择 60 分钟时则归入 14:00。按月、日、时、分排序的时间字符串也便于按同一时区的时间范围比较。
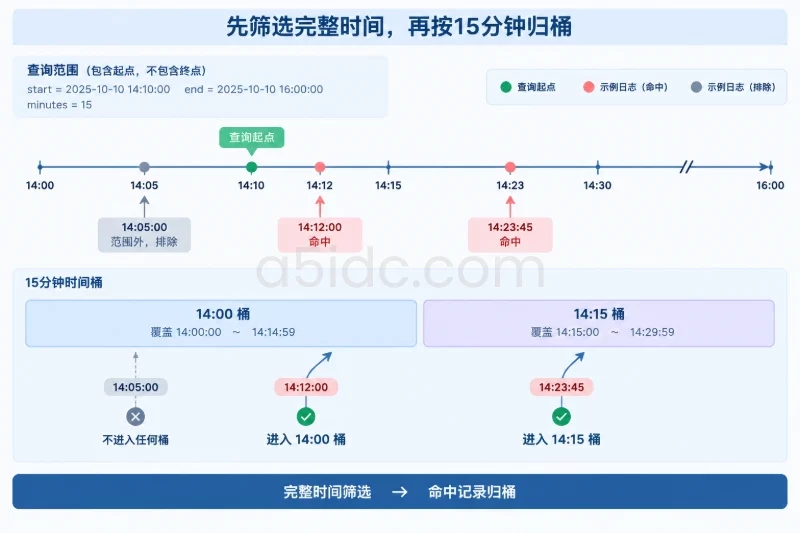
sort 仅整理输出顺序,不参与计数。脚本使用的是 awk 中的状态码字段,不会因为请求路径或 User-Agent 中出现“404”等字符而误计。
以下是示意输出,并非某台服务器的实际数据:
BUCKET 2025-10-10T14:00 200 100
BUCKET 2025-10-10T14:00 404 5
BUCKET 2025-10-10T14:00 500 3
BUCKET 2025-10-10T15:00 200 80
BUCKET 2025-10-10T15:00 404 7
BUCKET 2025-10-10T15:00 500 5
CHECK read=200 matched=200 outside=0 wrong_tz=0 bad_format=0
STATUS 200 180
STATUS 404 12
STATUS 500 8
读结果时分别核对三件事:
BUCKET 行给出某个时间段内某个状态码的请求数。本例 14:00 时间桶的 500 数量为 3;该桶覆盖 14:00:00—14:59:59,而不是仅指 14:00 这一分钟。STATUS 行给出整个查询范围内各状态码的数量。本例 200 + 404 + 500 的数量为 180 + 12 + 8 = 200,应等于 matched。CHECK 行解释记录去向。正常情况下,matched + outside + wrong_tz + bad_format 应等于 read。outside 是已解析但不在查询范围内的行,并不表示报错。如果要看 5xx 占查询范围内请求的比例,应将各 5xx 状态数量相加后除以 matched。在上述示例中只有 8 条 500,因此比例为 8 ÷ 200 = 4%。这只是该日志、该时间范围内的请求占比,不能直接当作服务可用性指标。
matched=0:先看 read。若 read=0,可能读到空文件,或者目标时段已落入轮转后的日志;确认路径与日志轮转情况。若 outside 接近 read,检查查询日期、起止时间以及是否把结束时间误写成了包含端点。若 wrong_tz 较多,重新查看原始日志的 $5,不要仅凭服务器当前显示的时区推断历史日志偏移量。
bad_format 较多:查看原始样本,重点确认 $4 和 $9。上面的脚本只接受示例时间格式及三位的 100—599 状态码;自定义 log_format、混入的非访问日志行,或字段位置变化都可能被排除。若字段位置不同,应先确定配置中的日志字段顺序,再调整脚本,不能把 bad_format 当作正常请求计入分母。
汇总比预期少:检查目标日期的日志是否已经轮转。未压缩的轮转文件可在确认时间范围和文件无重复后,与当前文件一同交给同一条 awk 命令读取,例如把命令末尾的 "$log" 改为 "$log" /var/log/nginx/access.log.1。压缩文件需要先解压到标准输出再统计;不要为了查询而覆盖当前日志,也不要直接拼接可能重复的备份文件,否则会重复计数。
日志统计与业务后台、网站服务和数据存储往往运行在同一类基础设施上。A5数据提供香港、美国、日本等地区的物理服务器,产品涵盖NVMe存储配置及面向大容量数据的存储方案,可为访问日志留存、后台处理和数据库等业务提供相应的计算与存储资源。
命令出现读取错误:先处理报错本身,再使用输出做判断。尤其在 awk | sort 管道中,不能仅凭屏幕上出现部分统计行就认定文件已经完整读完。需要检查管道退出状态时,可在 Bash 中预先启用 set -o pipefail 后重跑命令;它只改变当前 Shell 对管道失败状态的判断,不修改日志或服务。
这项统计是只读操作,正常执行后无需恢复配置。若发现字段选错或时间范围写错,修正参数并重新运行即可;不要通过编辑原始访问日志来“修正”报表。对于持续写入的当前日志,两次运行之间请求仍可能增加;需要固定口径的日报,应使用覆盖完整目标时段且已确认轮转范围的文件,并记录统计所用的文件名与时间区间。
提交或验收统计结果前,可逐项核对:
$4 为请求时间、$5 为时区偏移、$9 为状态码。minutes 按需要设为 60 或 15。CHECK 中各类行数之和等于 read,各 STATUS 数量之和等于 matched。bad_format 和 wrong_tz 均已解释。本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5547.html