香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


PCIe设备的NUMA归属不能仅凭机箱上的插槽编号或“靠近第几个CPU”判断。Linux主机上应先用PCI地址(BDF)锁定设备,再读取/sys/bus/pci/devices/<BDF>/numa_node;确认节点后,用numactl --hardware或lscpu把该节点对应到CPU和内存,最后检查业务进程的CPU允许运行范围与实际内存分布。
如果numa_node返回-1,它表示内核没有获得可靠的PCIe NUMA信息,不代表设备属于NUMA节点0。此时需要结合PCIe拓扑、固件设置和主机实际硬件结构交叉判断,不能直接把-1改写成某个节点。
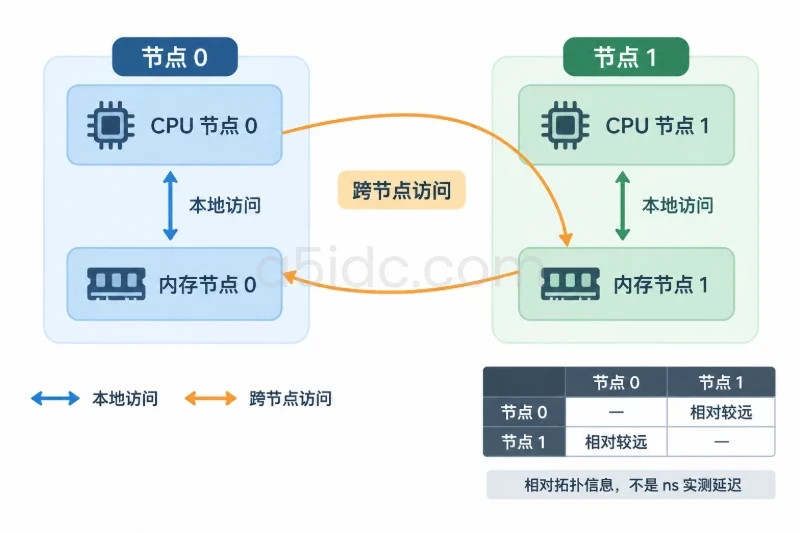
NUMA节点是操作系统对CPU和内存的逻辑分组。典型双路服务器可能有:
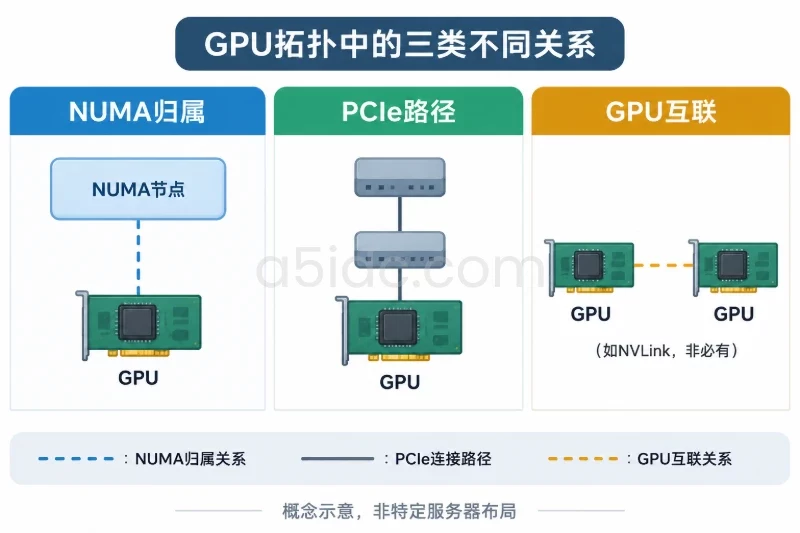
PCIe设备本身通常不会直接绑定到“CPU 8”或“CPU 32”。更准确的说法是:设备连接在某个PCIe根端口或上游桥下,而该路径被内核关联到某个NUMA节点。
因此,下面两句话含义不同:
二者需要同时满足,才有可能获得较好的CPU与PCIe设备局部性。
进程可以被限制只能运行在节点1的CPU上,但它分配的内存仍可能来自节点0。例如:
所以,不能只看taskset的CPU列表,就断定进程的内存也在同一个节点。CPU运行范围应与进程的实际内存分布分别核对。
设备属于节点1,只能说明它与节点1的PCIe路径更接近。它不能直接证明:
PCIe链路的速率和宽度还要看LnkSta,中断处理还要看IRQ亲和性,业务内存则要看进程的NUMA分布。
服务器固件会通过ACPI表向操作系统描述CPU、内存和PCIe根端口之间的距离关系,其中与NUMA局部性相关的信息通常由SRAT等表提供。Linux启动后,根据这些信息建立NUMA节点,并为PCI设备记录numa_node。
访问路径大致是:
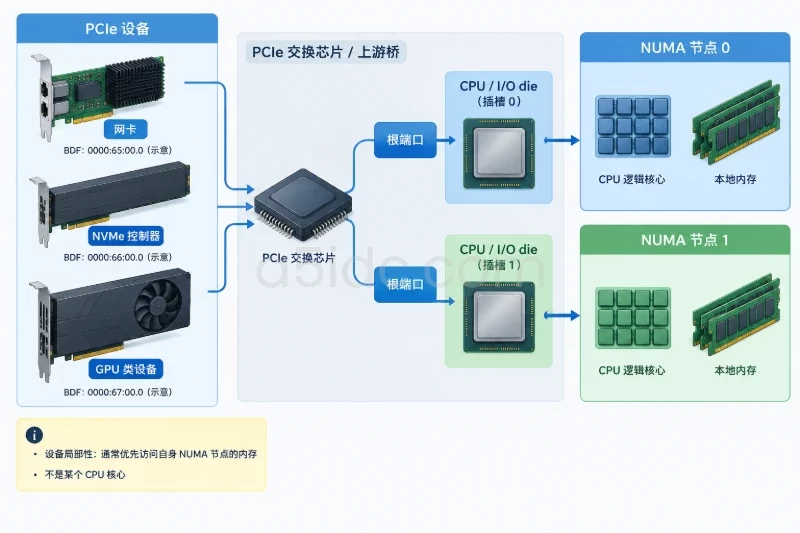
PCIe设备
  → PCIe交换芯片或上游桥
  → PCIe根端口
  → CPU插槽或I/O die
  → NUMA节点
设备如果经过PCIe交换芯片连接,内核通常会根据上游路径判断其局部节点。物理插槽编号、PCI总线号和NUMA节点号之间没有通用的数字对应关系,不能看到总线号为65就推断设备属于节点1。
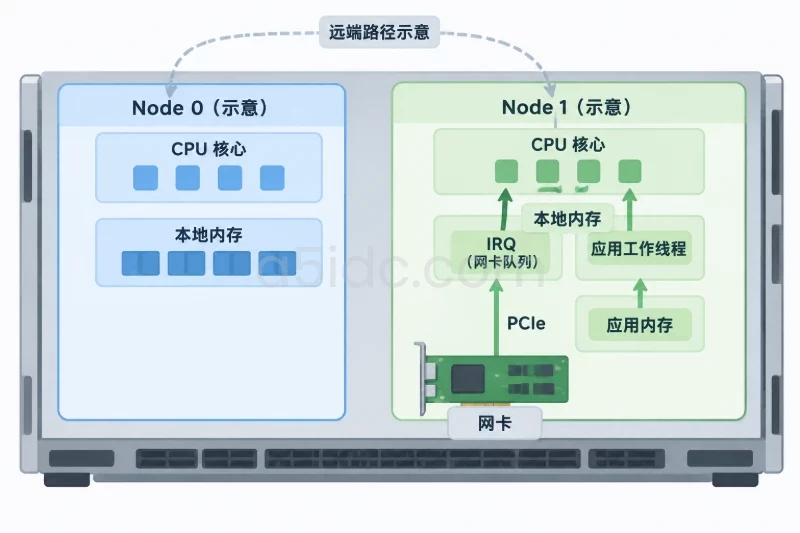
网卡、NVMe控制器和其他PCIe设备进行DMA时,会直接读写内存中的缓冲区。若设备属于节点1,而DMA缓冲区主要位于节点0,数据访问就需要跨NUMA互连;CPU处理设备中断、提交队列或访问MMIO寄存器时也可能发生跨节点访问。
这并不意味着跨节点访问必然导致故障。它更常见的影响是增加访问延迟、占用跨节点互连带宽,并在高并发或高吞吐场景下放大性能差异。
对于高速网卡、NVMe阵列和GPU,以下对象通常需要尽量保持同节点:
面向网卡、NVMe控制器等PCIe设备参与的数据处理场景,A5数据提供香港、美国、日本等地区的物理服务器,覆盖Xeon与AMD EPYC平台,并有不同的内存和SSD、NVMe存储配置,可为数据库、接口服务及多任务计算提供硬件资源基础。结合具体服务器的CPU、内存与PCIe拓扑,这些资源适用于部署需要关注设备、CPU和内存局部性的业务。
下面的命令以Linux物理服务器为前提,均以读取信息为主,不会修改设备配置。
先列出设备及其完整PCI地址:
lspci -Dnn
在设备较多的服务器上,可以按设备类型筛选:
lspci -Dnn | grep -Ei 'Ethernet|Network|Non-Volatile memory|VGA|3D controller|SAS|RAID'
示例输出可能如下:
0000:65:00.0 Ethernet controller [0200]: Example NIC [1a2b:3c4d]
0000:66:00.0 Non-Volatile memory controller [0108]: Example NVMe [144d:a808]
其中:
0000是PCI域;65或66是总线号;00是设备号;.0是功能号。完整地址0000:65:00.0称为BDF。多功能设备可能同时存在.0、.1等多个功能,核对时不要只看其中一个功能,尤其是网卡、加速卡和复合控制器。
把BDF代入sysfs路径:
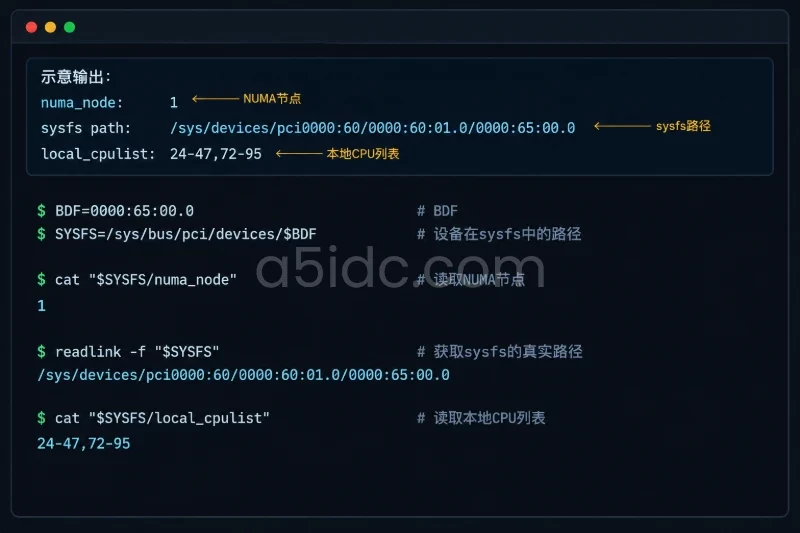
BDF=0000:65:00.0
SYSFS=/sys/bus/pci/devices/$BDF

printf 'device: '
lspci -Dnn -s "$BDF"

printf 'numa_node: '
cat "$SYSFS/numa_node"

printf 'sysfs path: '
readlink -f "$SYSFS"

if [ -r "$SYSFS/local_cpulist" ]; then
    printf 'local_cpulist: '
    cat "$SYSFS/local_cpulist"
fi
典型结果可能是:
device: 0000:65:00.0 Ethernet controller [0200]: Example NIC [1a2b:3c4d]
numa_node: 1
sysfs path: /sys/devices/pci0000:60/0000:60:01.0/0000:65:00.0
local_cpulist: 24-47,72-95
判断标准如下:
| 输出结果 | 含义 | 判断方式 |
|---|---|---|
0 | 设备被内核关联到NUMA节点0 | 继续核对节点0的CPU和内存 |
1或其他非负整数 | 设备被关联到对应编号的NUMA节点 | 不能仅凭节点号推断CPU编号 |
-1 | 内核没有获得可用的设备NUMA信息 | 不要直接归入节点0,需要交叉验证 |
| 文件不存在或读取失败 | 内核、sysfs或设备信息不完整 | 检查系统版本、设备状态和权限 |
readlink -f显示的路径可以帮助观察设备经过的上游桥。例如路径中可能先出现0000:60:01.0,再出现目标设备0000:65:00.0。它可以辅助确认设备的PCIe层级,但路径中的总线号仍然不等于NUMA节点号。
也可以用lspci查看设备的拓扑和链路信息:
lspci -D -vv -s "$BDF"
重点关注以下字段:
LnkCap: Port #0, Speed 16GT/s, Width x16
LnkSta: Speed 16GT/s, Width x16
Physical Slot: ...
NUMA node: 1
NUMA node是否显示取决于pciutils版本、内核和设备信息;因此应优先以sysfs中的numa_node作为判断依据。LnkCap和LnkSta用于核对链路能力与当前状态,不用于替代NUMA归属判断。
使用numactl查看系统的NUMA布局:
numactl --hardware
示例输出:
available: 2 nodes (0-1)
node 0 cpus: 0-23,48-71
node 0 size: 257000 MB
node 0 free: 231000 MB
node 1 cpus: 24-47,72-95
node 1 size: 257000 MB
node 1 free: 224000 MB
node distances:
node   0   1
  0:  10  21
  1:  21  10
如果设备的numa_node为1,则本例中的本地CPU集合是:
24-47,72-95
节点1的内存容量和可用量则由node 1 size与node 1 free体现。这里的free是系统层面的当前可用量,不代表某个进程已经使用的内存,也不代表设备DMA缓冲区的位置。
没有安装numactl时,可以直接读取sysfs中的节点CPU列表:
for n in /sys/devices/system/node/node[0-9]*; do
    [ -r "$n/cpulist" ] || continue
    printf '%s: ' "$(basename "$n")"
    cat "$n/cpulist"
done
再用lscpu查看逻辑CPU、Socket、核心和NUMA节点的对应关系:
lscpu -e=CPU,CORE,SOCKET,NODE
示例:
CPU  CORE SOCKET NODE
 0     0      0    0
 1     1      0    0
24    24      1    1
25    25      1    1
72     0      1    1
73     1      1    1
逻辑CPU编号可能因为超线程、BIOS设置或CPU拓扑而不连续。判断设备亲和性时,应使用NODE列或cpulist,不要用“CPU编号较大”作为节点判断依据。
先找出处理该设备的业务进程:
ps -eo pid,comm,args --sort=comm
假设进程ID为1234,查看其调度器CPU亲和性:
PID=1234
taskset -pc "$PID"
示例:
pid 1234's current affinity list: 24-47,72-95
如果设备属于节点1,而进程允许使用的CPU正好是节点1的CPU集合,说明调度层面的CPU亲和性是对齐的。
还可以查看进程最近一次运行所在的逻辑CPU:
ps -o pid,psr,comm -p "$PID"
例如:
  PID PSR COMMAND
 1234  31 worker
这里的PSR只能表示采样时或最近一次调度使用的CPU,不能替代taskset的允许运行范围,也不能证明进程始终运行在该CPU上。进程可能在多个允许的CPU之间迁移。
如果进程由systemd、容器或其他cgroup管理,还要检查cgroup限制。taskset只反映进程自身的调度亲和性,cgroup可能进一步缩小可用范围。先查看进程所属cgroup:
cat /proc/1234/cgroup
在cgroup v2环境中,找到对应目录后检查:
cat /sys/fs/cgroup/<对应路径>/cpuset.cpus.effective
cat /sys/fs/cgroup/<对应路径>/cpuset.mems.effective
cpuset.cpus.effective限制可用CPU,cpuset.mems.effective限制可使用的内存节点。两者都需要与PCIe设备所在节点进行比较。
查看进程的NUMA内存统计:
numastat -p 1234
不同版本的numastat排版略有差异,示意结果可能是:
Per-node process memory usage (in MBs)
                         Node 0    Node 1
Private                    420      7680
Heap                       110      3210
Stack                        4         8
Total                      534     10898
如果设备属于节点1,而进程内存大部分位于Node 1,可以认为进程的内存局部性较好。若Node 0占比明显更高,则设备DMA可能需要跨节点访问,即使进程CPU已经限制在节点1。
还可以查看更细粒度的页面分布:
grep -E '(^| )N[0-9]+=' /proc/1234/numa_maps | head -n 20
示例:
7f2a00000000 default anon=2048 dirty=2048 N1=2048
7f2a10000000 default file=/data/cache mapped=4096 N0=3072 N1=1024
其中:
N0=3072表示相关页面有一部分位于节点0;N1=2048表示另一部分位于节点1;numactl --hardware只能告诉你系统每个节点有多少内存,不能证明目标进程的内存位于哪个节点;numastat -p和/proc/<PID>/numa_maps才用于核对进程级分布。
可以把一次核对压缩为四个结果:
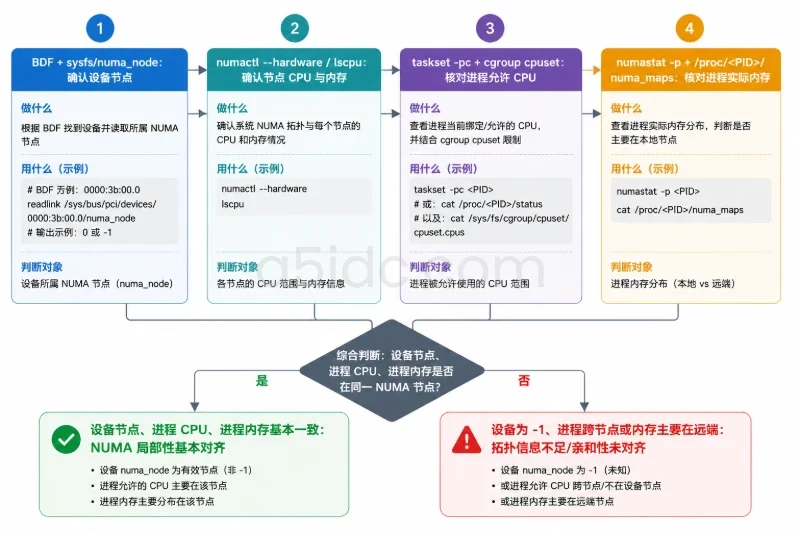
| 核对对象 | 关键命令 | 需要确认的结果 |
|---|---|---|
| PCIe设备 | lspci -Dnn、cat /sys/bus/pci/devices/<BDF>/numa_node | 得到设备BDF和NUMA节点 |
| 节点CPU | numactl --hardware、lscpu -e | 得到该节点对应的逻辑CPU集合 |
| 进程CPU | taskset -pc <PID>、cgroup cpuset | 进程允许使用的CPU是否包含或限定在设备节点 |
| 进程内存 | numastat -p <PID>、/proc/<PID>/numa_maps | 内存主要位于设备本地节点还是远端节点 |
例如:
设备 BDF:0000:65:00.0
设备 NUMA 节点:1
节点1 CPU:24-47,72-95
进程CPU亲和性:24-47,72-95
进程内存:Node0 534 MB,Node1 10898 MB
这个结果可以判断为:
如果结果是:
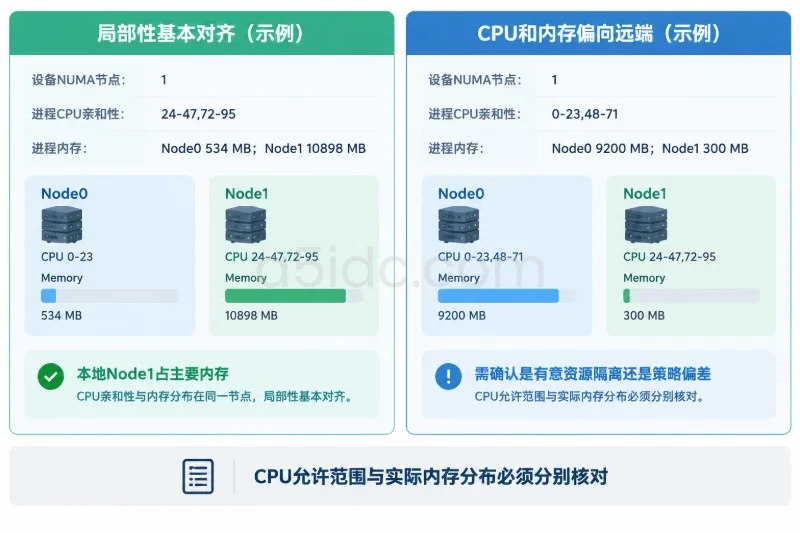
设备 NUMA 节点:1
进程CPU亲和性:0-23,48-71
进程内存:Node0 9200 MB,Node1 300 MB
则CPU和内存都主要位于设备的远端节点。此时应先确认这是有意的资源隔离,还是服务启动、线程绑核或内存分配策略造成的偏差。
如果进程CPU范围是:
0-23,24-47,48-71,72-95
这表示进程可以在两个NUMA节点上运行,不能称为“已经绑定到设备本地节点”。它可能在本地运行,也可能被调度到远端节点,需结合运行时采样和业务线程设置进一步确认。
对网卡、NVMe等高并发设备,仅检查进程还不够。设备中断可能由另一个CPU节点处理,导致数据路径出现额外的跨节点访问。
先查设备相关中断:
grep -iE 'nvme|eth|mlx|ixgbe|bnxt|hba' /proc/interrupts
获得IRQ编号后,查看该IRQ允许使用的CPU:
IRQ=145
cat /proc/irq/$IRQ/smp_affinity_list
新内核还可能提供实际生效的亲和性列表:
if [ -r /proc/irq/$IRQ/effective_affinity_list ]; then
    cat /proc/irq/$IRQ/effective_affinity_list
fi
如果设备属于节点1,而中断主要落在节点0,说明中断路径与设备局部性不一致。此时还要考虑:
irqbalance是否正在动态调整;这一步属于运行时路径核对,不应与PCIe设备的静态NUMA归属混为一谈。
如果需要验证服务在某个节点运行时的行为,可以对测试进程使用NUMA策略:
numactl --cpunodebind=1 --membind=1 -- /path/to/test-program
该命令表示:
numactl和内核策略影响;生产服务不应未经评估直接套用--membind。如果目标节点内存不足,严格的内存绑定可能导致分配失败,而不是自动使用其他节点。已有页面也不会因为重新设置进程策略就全部搬到本地节点,因此对照测试应结合numastat -p确认实际结果。
如果双路物理服务器在操作系统中只显示一个NUMA节点,或者节点数量与预期明显不符,应检查:
不同厂商和CPU平台的选项名称并不相同,不能仅凭“Socket 0/1”推断操作系统最终呈现的NUMA结构。
同一台服务器中,不同插槽可能分别连接到不同CPU侧;某些插槽还可能经过PCIe交换芯片或专用转接卡。设备实际插槽位置应结合:
lspci -Dtv
lspci -D -vv -s "$BDF"
readlink -f /sys/bus/pci/devices/$BDF
以及服务器厂商的主板拓扑文档判断。不能把机箱标注的“Slot 1”直接等同于NUMA节点0。
numa_node=-1不应被强行解释以下情况都可能导致设备显示-1:
此时可以先确认节点本身是否正常:
cat /sys/devices/system/node/online
numactl --hardware
lscpu
如果CPU和内存NUMA结构正常,但设备始终为-1,就需要根据上游桥、物理插槽和平台文档做人工确认。若要求精确比较延迟,还应使用受控基准测试,而不是仅凭节点编号下结论。
本文方法适用于物理服务器上的Linux系统。在虚拟机内执行时,看到的BDF可能是:
即使客户机显示设备属于NUMA节点1,也不能据此证明宿主机物理PCIe插槽位于宿主机节点1。直通场景需要同时查看宿主机的PCI拓扑、IOMMU分组和虚拟机的vNUMA配置。
最终核对时,至少保留四项证据:设备BDF、numa_node值、该节点的CPU/内存列表,以及目标进程的CPU和内存分布。只有这些结果相互一致,才能判断CPU、内存和PCIe设备形成了较完整的本地路径;如果设备节点为-1、进程跨多个节点运行,或内存主要位于远端节点,则应明确标记为“拓扑信息不足”或“亲和性未对齐”,而不是给出确定的本地性结论。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5297.html