香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


当 Kubernetes Pod 显示 ImagePullBackOff 时,通常意味着节点上的 kubelet 或容器运行时无法拉取容器镜像,经过多次重试后进入退避等待。它发生在容器进程启动之前,因此此时没有应用日志、监听端口或健康检查结果可供判断,优先检查镜像地址、标签、仓库权限以及发生故障的节点网络。
排查不应只盯着 Pod 状态本身。应先通过 Events 获取原始错误,再沿着“镜像引用 → 仓库认证 → 节点 DNS 与网络 → TLS 与运行时 → 存储和架构”的原因树逐层缩小范围。修复后,还要确认 Pod 已重新拉取镜像并进入 Running、Ready,避免仅看到状态短暂变化就认为故障已经恢复。
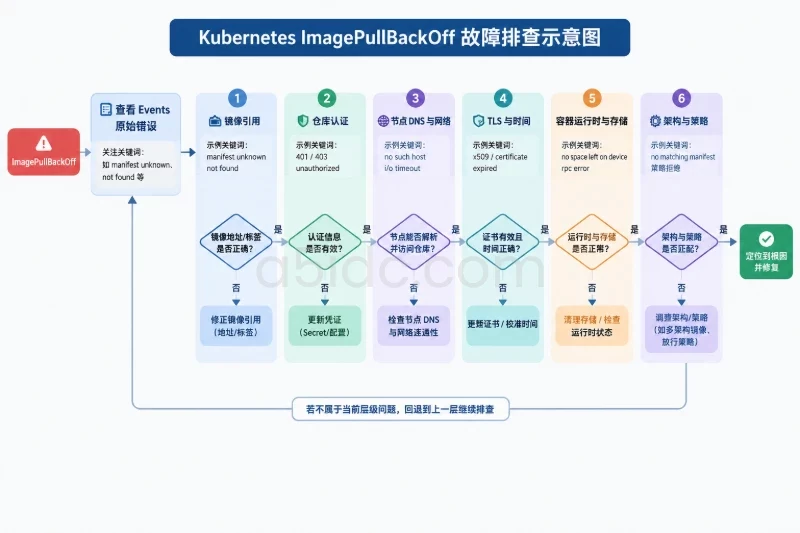
先确认是单个 Pod、同一节点上的多个 Pod,还是整个命名空间甚至整个集群都受到影响。范围不同,排查方向也不同:
先查看 Pod 的状态和调度节点:
kubectl get pod <pod-name> -n <namespace> -o wide
kubectl get pod <pod-name> -n <namespace> -o jsonpath='{range .status.containerStatuses[*]}{.name}{"\t"}{.state.waiting.reason}{"\t"}{.state.waiting.message}{"\n"}{end}'
然后查看描述信息,尤其是末尾的 Events:
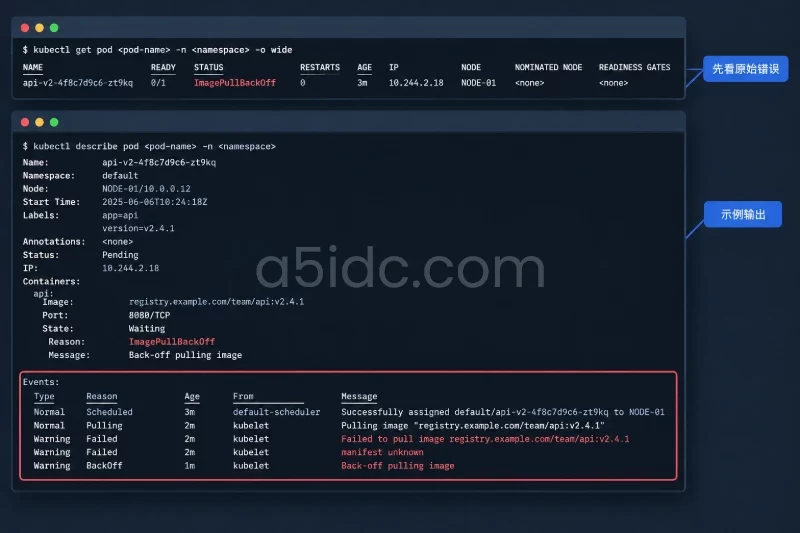
kubectl describe pod <pod-name> -n <namespace>
典型事件可能类似下面这样。以下内容是判断示例,不代表当前环境已经执行过这些检查:
Failed to pull image "registry.example.com/team/api:v2.4.1":
rpc error: code = NotFound desc = failed to resolve reference:
manifest unknown

Back-off pulling image "registry.example.com/team/api:v2.4.1"
ImagePullBackOff 是结果,Failed to pull image 或运行时返回的具体错误才是线索。若事件中同时出现 ErrImagePull,表示拉取失败仍在发生;若只看到 Back-off pulling image,仍应向前查看更早的事件,寻找第一次失败的原因。
也可以单独查看命名空间中的事件:
kubectl get events -n <namespace> --sort-by=.lastTimestamp
注意事件可能被后续事件覆盖或过期。如果问题正在发生,应尽快收集以下信息:
Events 中的原始错误。imagePullSecrets。可以把原因分为以下几层。每一层都应结合观察结果决定下一步,而不是看到状态名称后直接修改配置。
| 排查层级 | 常见原因 | 主要观察依据 | 下一步 |
|---|---|---|---|
| 镜像引用 | 仓库域名、项目路径、标签或摘要错误,镜像尚未推送 | manifest unknown、not found | 核对发布记录和镜像完整引用 |
| 仓库权限 | 未配置凭据、凭据过期、账号无仓库读取权限 | 401、403、unauthorized、denied | 检查命名空间内的 Secret 和 ServiceAccount |
| 节点网络 | DNS 解析失败、出口防火墙、路由、代理或连接超时 | no such host、i/o timeout、context deadline exceeded | 在实际工作节点上验证解析和 HTTPS 连接 |
| TLS 与时间 | 私有 CA 未被运行时信任、证书过期、节点时间偏差 | x509、certificate signed by unknown authority | 检查 CA 配置、证书链和节点时间 |
| 容器运行时与存储 | containerd 或其他运行时异常,磁盘或 inode 耗尽 | no space left on device、runtime error | 检查 kubelet、运行时服务及节点存储 |
| 架构与策略 | 镜像没有匹配节点架构,或被镜像策略拒绝 | no matching manifest、策略拒绝事件 | 检查镜像 manifest、节点架构和准入策略 |
容器镜像引用由仓库地址、项目路径、镜像名称以及标签或摘要组成。例如:
registry.example.com/platform/order-api:v2.4.1
registry.example.com/platform/order-api@sha256:abcdef...
以下任意一处错误都可能导致拉取失败:
先查看工作负载实际下发的镜像,而不是只看本地配置文件:
kubectl get deployment <deployment-name> -n <namespace> \
  -o jsonpath='{range .spec.template.spec.containers[*]}{.name}{"\t"}{.image}{"\n"}{end}'
如果 Pod 包含 Init Container,也要同时查看:
kubectl get pod <pod-name> -n <namespace> \
  -o jsonpath='{range .spec.initContainers[*]}init:{.name}{"\t"}{.image}{"\n"}{end}{range .spec.containers[*]}container:{.name}{"\t"}{.image}{"\n"}{end}'
重点是确认“失败 Pod 使用的镜像”和“你以为已经发布的镜像”是否一致。滚动更新期间,旧 ReplicaSet 和新 ReplicaSet 可能同时存在,不要只根据 Deployment 文件判断。
如果事件是 manifest unknown、repository does not exist 或 not found,通常应回到镜像仓库侧确认:
如果使用 latest 或其他可变标签,还要确认 imagePullPolicy。例如,Always 会在启动时向仓库检查镜像;仓库暂时不可访问时,即使节点本地曾经有镜像,也可能无法完成启动。生产发布更适合使用不可变标签或镜像摘要,并把标签与发布版本建立对应关系。
私有仓库通常依赖 Kubernetes Secret 提供认证信息。凭据是命名空间级资源,某个命名空间中的 Secret 不会自动被其他命名空间使用。
先确认 Pod 使用的 ServiceAccount:
kubectl get pod <pod-name> -n <namespace> \
  -o jsonpath='{.spec.serviceAccountName}{"\n"}'

kubectl get serviceaccount <service-account-name> -n <namespace> \
  -o jsonpath='{range .imagePullSecrets[*]}{.name}{"\n"}'
再确认 Secret 是否存在以及类型是否正确。下面的命令只查看类型,不打印认证内容:
kubectl get secret <registry-secret> -n <namespace> \
  -o jsonpath='{.type}{"\n"}'
私有镜像仓库常见类型是:
kubernetes.io/dockerconfigjson
如果工作负载直接在 Pod 模板中指定了 imagePullSecrets,也要查看这一层:
kubectl get pod <pod-name> -n <namespace> \
  -o jsonpath='{range .spec.imagePullSecrets[*]}{.name}{"\n"}'
常见问题包括:
default ServiceAccount 上。如果 Secret 已经存在,只需要在工作负载模板中引用它,示例配置如下:
apiVersion: apps/v1
kind: Deployment
meta
  name: order-api
  namespace: production
spec:
  template:
    spec:
      serviceAccountName: app-runtime
      imagePullSecrets:
        - name: registry-credential
      containers:
        - name: order-api
          image: registry.example.com/platform/order-api:v2.4.1
修改前应保存当前 Deployment 配置,避免误覆盖其他字段:
kubectl get deployment order-api -n production -o yaml > order-api.before.yaml
不要把真实密码直接写入 Git、工单或公开命令历史。凭据更新应通过密钥管理系统、受控的 CI/CD 变量或集群已有的 Secret 管理流程完成。更新凭据后,要确认新创建的 Pod 确实引用了新的 ServiceAccount 或 Secret;仅修改一个未被工作负载使用的 Secret 不会产生效果。
镜像拉取由节点上的 kubelet 和容器运行时发起,不是由业务容器发起。因此,业务 Pod 内能访问某个地址,并不等于节点上的容器运行时也能访问镜像仓库;反过来也一样。
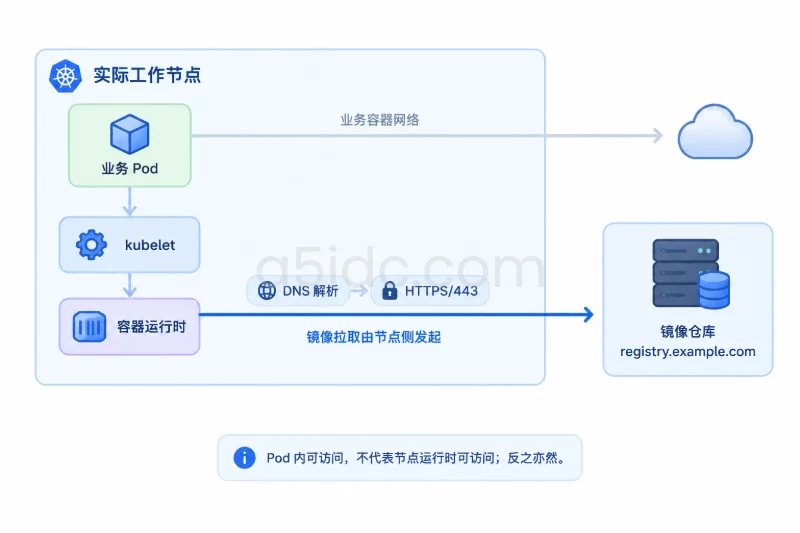
先确定失败 Pod 所在节点:
kubectl get pod <pod-name> -n <namespace> -o wide
在该节点上按顺序检查:
getent hosts registry.example.com
date -u
curl -I https://registry.example.com/v2/
如果仓库要求认证,访问 /v2/ 返回 401 Unauthorized 可能是正常现象,它至少说明 DNS 和 HTTPS 链路已经到达仓库。若出现以下结果,含义通常不同:
Could not resolve host 或 no such host:优先检查节点 DNS、上游 DNS 和仓库域名。Connection timed out:检查出口路由、防火墙、安全组或代理。Connection refused:目标地址可达,但端口没有服务监听或被中间设备拒绝。401 Unauthorized:网络大致可达,继续检查凭据和仓库权限。403 Forbidden:账号、来源地址或仓库策略不允许读取。x509: certificate signed by unknown authority:节点运行时不信任仓库证书链。certificate has expired:检查仓库证书、节点时间和中间 CA。context deadline exceeded:可能是网络延迟、代理配置或仓库响应过慢。使用 curl -k 仅适合临时区分“网络握手失败”和“证书校验失败”,不能作为生产修复方案:
curl -vkI https://registry.example.com/v2/
如果节点访问外部仓库必须经过代理,还要检查代理是否配置在容器运行时服务中。当前终端的 HTTP_PROXY 环境变量,不一定会被 systemd 启动的 containerd 或其他运行时继承。可以查看服务环境,但不要直接把包含认证信息的环境变量粘贴到工单或聊天窗口:
systemctl show containerd --property=Environment
部分环境会使用自建 CA。此时应按当前 Linux 发行版和容器运行时的证书信任机制安装 CA,并重载或重启相应服务。变更前应确认节点是否承载关键业务,必要时先进行摘流或维护窗口安排;不要通过关闭 TLS 校验来绕过证书问题。
还要注意,普通 Kubernetes NetworkPolicy 通常约束 Pod 流量,并不直接等同于节点上容器运行时的出口策略。遇到镜像拉取失败时,应同时检查节点所在子网的出口防火墙、安全组、路由表和企业代理,而不是只修改业务 Pod 的网络策略。
Kubernetes 节点上的镜像拉取依赖服务器硬件与网络资源。A5数据提供香港、美国、日本等地区的物理服务器,配置涵盖 Xeon Gold、AMD EPYC、内存与 NVMe 存储,并有不同线路方案,可为自建容器集群及相关业务提供节点资源基础。
如果多个 Pod 在同一节点上同时出现 ImagePullBackOff,或者事件中出现 no space left on device、failed to unpack image、rpc error,应转向节点系统层。
在节点上检查文件系统空间和 inode:
df -h
df -ih
镜像层可能写入容器运行时目录或 kubelet 目录。具体路径取决于运行时和发行版,不能仅凭经验手工删除目录。空间不足时,重点确认:
同时查看服务状态和近期日志:
systemctl is-active kubelet
systemctl is-active containerd

journalctl -u kubelet --since "30 min ago" --no-pager
journalctl -u containerd --since "30 min ago" --no-pager
如果集群使用的不是 containerd,应以实际运行时为准,不要直接执行不匹配的服务命令。可以先从节点信息确认运行时:
kubectl get node <node-name> \
  -o jsonpath='{.status.nodeInfo.containerRuntimeVersion}{"\n"}'
在具备权限并且运行时工具已经正确配置的环境中,可以使用 crictl info 或运行时自身的诊断命令进一步确认。直接执行拉取测试会真实下载镜像并消耗网络和磁盘,应先确认镜像、权限和维护影响:
crictl pull registry.example.com/platform/order-api:v2.4.1
这条命令只适合节点管理员或平台运维人员使用。清理镜像、重启运行时或重启节点都可能影响同节点上的其他工作负载。清理前应确认节点是否可摘流、是否有足够副本,并使用运行时支持的垃圾回收方式;不要直接删除 /var/lib/containerd、/var/lib/kubelet 等目录。若必须变更,先备份必要配置并准备回滚或节点替换方案。
多架构节点混用时,镜像可能只构建了 amd64,但 Pod 被调度到了 arm64 节点。此时常见错误是:
no matching manifest for linux/arm64 in the manifest list entries
查看节点架构:
kubectl get node <node-name> \
  -o jsonpath='{.metadata.name}{"\t"}{.status.nodeInfo.architecture}{"\n"}'
再检查镜像仓库是否提供与节点架构匹配的 manifest。可以使用企业允许的镜像仓库工具或镜像检查工具查看,不要只凭镜像标签名称推断架构。解决方式通常有两类:
如果事件不是拉取错误,而是类似 admission webhook denied、签名校验失败或镜像策略拒绝,那么根因可能在准入控制或供应链策略。此类问题通常发生在容器创建前,不能简单通过增加 imagePullSecrets 解决。应检查相关策略的审计日志、允许的仓库列表、签名要求和镜像摘要是否符合规则。
可以把 Events 中的关键词和下一步处理对应起来:
| 事件或日志关键词 | 更可能的原因 | 判断动作 |
|---|---|---|
manifest unknown、not found | 标签或仓库路径不存在 | 在仓库中核对镜像和标签 |
unauthorized、401 | 未认证或认证信息未生效 | 检查 Secret、ServiceAccount 和仓库域名 |
denied、403 | 账号无读取权限或来源受限 | 检查仓库项目权限和访问控制 |
no such host | DNS 解析失败 | 在故障节点执行域名解析 |
i/o timeout、deadline exceeded | 节点出口或代理异常 | 检查路由、防火墙、代理和仓库延迟 |
x509 | CA、证书链或节点时间问题 | 检查信任链、证书有效期和时间同步 |
no space left on device | 磁盘或 inode 不足 | 检查 df -h 和 df -ih |
no matching manifest | 镜像没有匹配节点架构 | 检查镜像平台和节点架构 |
如果不同节点返回不同错误,不要把它们合并成一个结论。例如,节点 A 返回 401,节点 B 返回超时,说明可能同时存在凭据和网络问题;应按节点分别收集证据。
修复镜像地址、凭据或节点问题后,先确认工作负载是否已经按照预期创建新 Pod:
kubectl rollout status deployment/<deployment-name> -n <namespace> --timeout=5m
kubectl get pod -n <namespace> -l app=<app-label> -o wide
观察状态变化:
kubectl get pod <pod-name> -n <namespace> -w
验证项目至少包括:
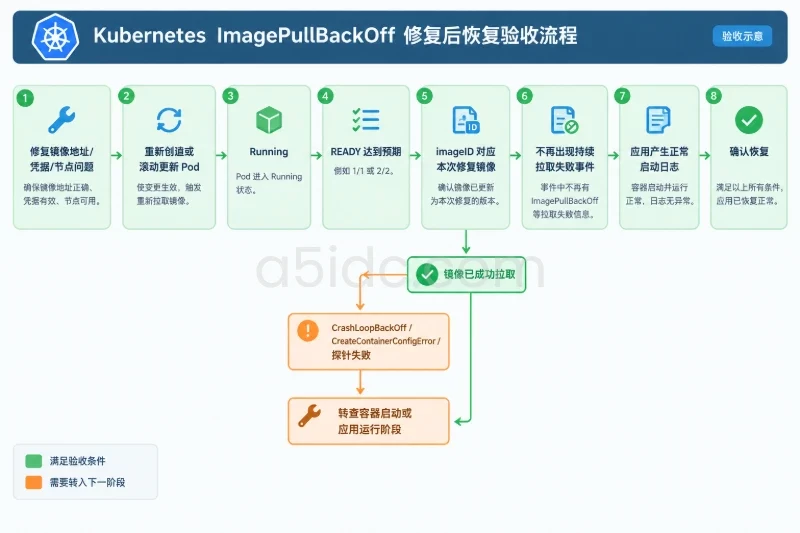
ImagePullBackOff 变为 Running。READY 达到预期,例如 1/1 或 2/2。imageID 已经对应本次修复后的镜像,而不是仍在使用旧缓存。查看实际拉取到的镜像摘要:
kubectl get pod <pod-name> -n <namespace> \
  -o jsonpath='{range .status.containerStatuses[*]}{.name}{"\t"}{.image}{"\t"}{.imageID}{"\n"}{end}'
如果镜像已经成功拉取,但 Pod 随后进入 CrashLoopBackOff、CreateContainerConfigError 或探针失败,就说明问题已经从“镜像拉取阶段”进入“容器启动或应用运行阶段”。这时再检查容器日志、环境变量、挂载、依赖服务、启动命令和健康检查:
kubectl logs <pod-name> -n <namespace> -c <container-name>
kubectl describe pod <pod-name> -n <namespace>
Service、端口和后端 Endpoint 也应在 Pod 已经 Ready 后检查。ImagePullBackOff 阶段容器进程尚未启动,单独修改 Service 端口通常不会解决镜像拉取失败。
如果错误发布已经影响滚动更新,且此前版本仍被确认可用,可以在保存当前配置并确认发布对象的前提下回滚:
kubectl rollout history deployment/<deployment-name> -n <namespace>
kubectl rollout undo deployment/<deployment-name> -n <namespace>
kubectl rollout status deployment/<deployment-name> -n <namespace> --timeout=5m
回滚前应确认历史版本使用的镜像仍存在、凭据仍有效,并评估回滚会替换哪些 Pod。不要把回滚当作修复仓库权限或节点网络的长期方案,否则下一次发布仍可能再次失败。
ImagePullBackOff 往往可以通过监控和发布校验提前暴露。建议持续关注以下指标和事件:
kube_pod_container_status_waiting_reason,分别告警 ImagePullBackOff 和 ErrImagePull。401/403/5xx 响应和超时比例。日常故障记录可以采用“失败 Pod—实际镜像—节点—事件原文—认证结果—网络结果—运行时状态—修复动作—恢复验证”的顺序。这样既能快速定位当前根因,也能判断问题是镜像发布流程、仓库权限、节点基础设施,还是集群架构兼容性导致的复发。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5107.html