香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


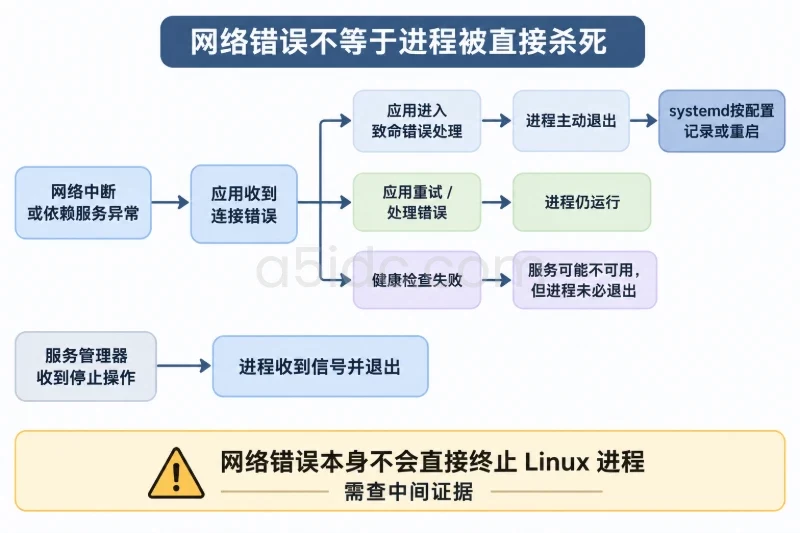
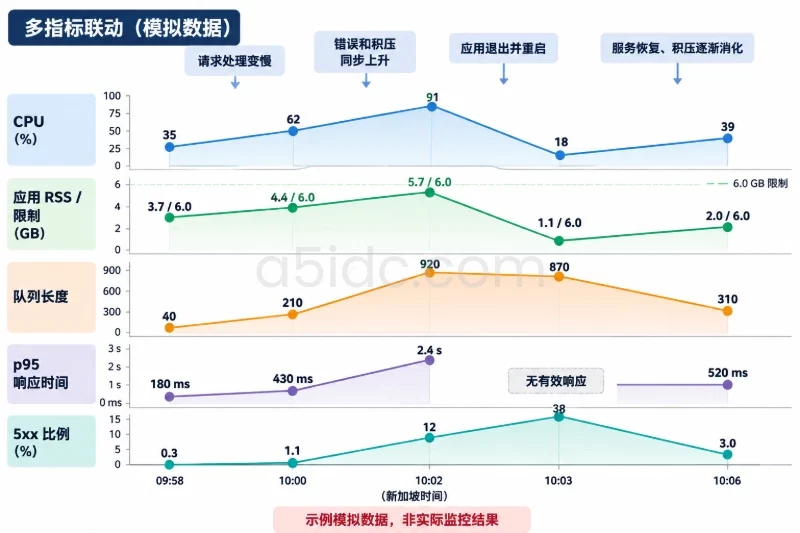
香港服务器上的业务突然返回 502,监控提示服务不可用,登录后却发现进程已经自动重启,这时只看“服务当前正常”并不能解释刚才的中断。定位异常退出,应先保留故障时段的服务状态,再把退出方式、退出码或信号、服务日志、内核日志放到同一条时间线上,判断是应用主动报错、资源不足、崩溃,还是被外部操作终止。
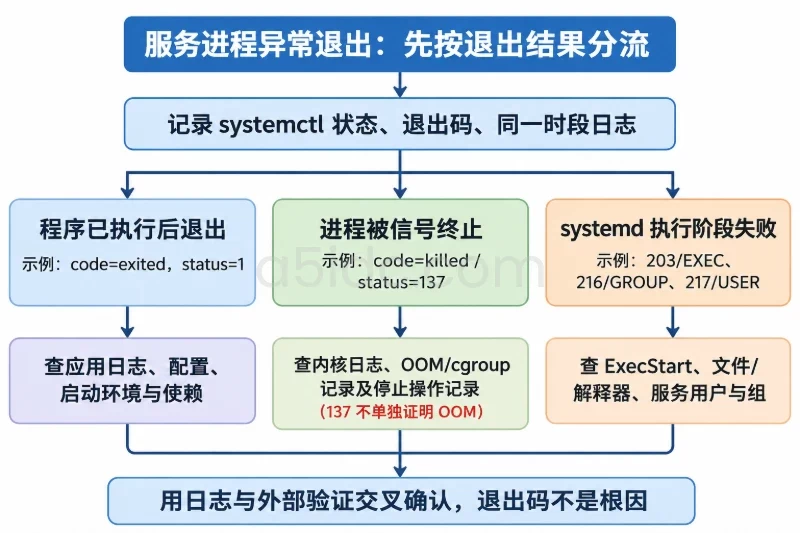
退出码是线索,不是原因本身。例如,status=9/KILL 说明进程被 SIGKILL 终止,但不能单独证明发生了内存不足;还需要内核 OOM、容器状态或管理操作日志佐证。香港机房的位置不会改变 Linux 的退出机制,不过服务器、监控平台和应用可能使用不同的时区,关联日志前必须统一时间口径。
以下操作适用于使用 systemd 管理服务的 Linux,例如常见的 Ubuntu、Debian、Rocky Linux 和 AlmaLinux。需要具备读取系统日志的权限,部分命令使用 sudo。
文中的 myapp.service 为示例服务名,必须替换为实际名称;示例时间和 PID 也应按故障现场调整。同一组命令中的变量需在同一个终端会话中使用。
502、超时和连接拒绝可能来自进程退出,也可能来自监听端口、负载均衡健康检查或依赖故障。先做只读检查:
SERVICE='myapp.service'

sudo systemctl status "$SERVICE" --no-pager -l
sudo systemctl show "$SERVICE" \
  -p ActiveState -p SubState -p Result \
  -p MainPID -p ExecMainCode -p ExecMainStatus \
  -p ExecMainStartTimestamp -p ExecMainExitTimestamp \
  -p NRestarts -p InvocationID
sudo ss -lntp
重点解释如下:
ActiveState=failed:服务已经进入失败状态,应继续查退出记录。active/running,但启动时间晚于故障时间:可能已经自动重启,当前状态不能代表故障时状态。systemctl status 在服务不正常时可能返回非零,这是状态结果,不一定是命令执行失败。NRestarts 主要用于观察 systemd 自动重启,不能当作长期累计故障次数。
还应保存配置和启动上下文:
sudo systemctl cat "$SERVICE"
sudo systemctl show "$SERVICE" \
  -p Type -p ExecStart -p User -p WorkingDirectory \
  -p Restart -p RestartUSec -p ControlGroup
这里要确认 systemd 管理的是实际业务进程,还是启动脚本、包装程序。如果主进程只是脚本,它的退出码未必就是业务子进程的退出码。
先取证,再恢复。不要反复重启、清空日志或直接修改资源限制。若业务必须立即恢复,至少先保存状态、故障窗口日志和当前配置;恢复后再继续分析历史记录。配置与日志可能含有密钥、令牌和用户信息,对外提交前应脱敏。
香港服务器可能使用香港时间,也可能使用 UTC。香港时间比 UTC 快 8 小时,例如香港时间 18:20 对应同日 UTC 10:20,跨日时还要调整日期。
timedatectl
sudo journalctl --list-boots
前者用于确认系统时区和时间同步状态;后者用于确认故障属于哪次系统启动。如果机器在故障后重启,只查当前启动批次就可能漏掉真正原因。
建议先以监控报警时间为中心,向前、向后各取几分钟。下面以 UTC 的示例窗口查询:
START='2026-04-10 10:15:00 UTC'
END='2026-04-10 10:25:00 UTC'

sudo journalctl -u "$SERVICE" \
  --since "$START" --until "$END" \
  --utc -o short-iso-precise --no-pager

sudo journalctl -k \
  --since "$START" --until "$END" \
  --utc -o short-iso-precise --no-pager
时间参数显式写入 UTC,避免把查询边界误按本地时间解释;--utc 用于统一输出时间。
第一条查询服务启停、主进程退出和写入 journal 的应用输出;第二条查询内核记录,重点关注 OOM、段错误和存储错误。如果故障在上一次启动中,可在命令中加入 -b -1,或使用 --list-boots 查到的启动 ID。
查不到日志不等于没有故障。可能原因包括查询了错误启动批次、journal 未持久化、日志已轮转,或者应用只写独立文件。
| 日志或记录 | 应关注的字段 | 主要判断用途 |
|---|---|---|
| systemd 服务日志 | 时间、单元名、PID、退出方式、状态、重启记录 | 确认何时退出、怎样退出 |
| 应用日志 | 时间、进程或线程、异常栈、请求 ID、版本 | 判断配置、依赖或代码错误 |
| 内核日志 | PID、进程名、OOM、segfault、I/O 错误 | 判断内核终止及底层异常 |
| 管理与审计记录 | 操作者、命令、任务 ID、部署时间 | 判断人为或自动化启停 |
| 网关、负载均衡日志 | 上游地址、状态码、连接错误、耗时 | 确认业务中断窗口和范围 |
应用日志路径应从应用配置、启动参数或日志组件配置确认,不要猜测。Ubuntu、Debian 的认证记录可能在 /var/log/auth.log,RHEL 系发行版可能在 /var/log/secure,是否存在取决于日志配置。
普通 journal 不会完整记录每一次 kill 操作。要确认是谁发出了信号,通常还需要预先启用的审计记录、发布平台记录或运维操作记录。
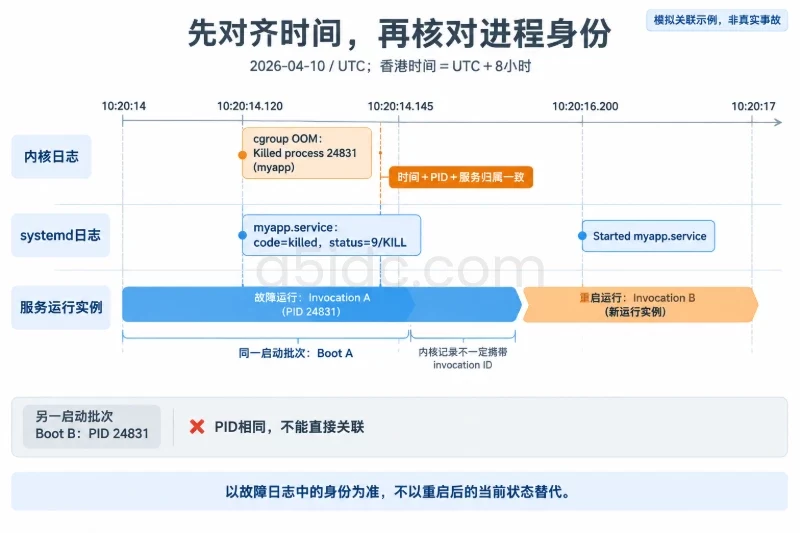
关联日志至少要核对时间、PID、服务单元、系统启动批次。PID 会复用,同一个数字在另一时段可能属于完全不同的进程。
需要核对 journal 结构化字段时,可以查看详细输出:
sudo journalctl -u "$SERVICE" \
  --since "$START" --until "$END" \
  -o verbose --no-pager
重点关注 _BOOT_ID、_PID、_SYSTEMD_UNIT 和 _SYSTEMD_INVOCATION_ID。若故障记录带有 invocation ID,可以进一步限定同一次服务运行:
sudo journalctl _SYSTEMD_INVOCATION_ID=<故障记录中的ID> \
  --utc -o short-iso-precise --no-pager
这条命令中的占位符必须替换。服务重启后,当前 systemctl show 返回的 invocation ID 可能已经改变,应以故障日志中的值为准;并非所有相关记录都携带该字段。
systemd 的 ExecMainCode 表示退出类型,ExecMainStatus 的含义随类型变化。在 Linux 上,常见的类型值为 1(正常退出)、2(被信号终止)、3(终止并产生核心转储状态)。排障时优先结合 systemctl status 和 journal 中的可读描述判断。
| 常见记录 | 可以确认什么 | 还不能直接确认什么 |
|---|---|---|
code=exited, status=1/FAILURE | 程序返回了非零退出码 | 是配置错误、依赖失败还是代码错误 |
code=exited, status=0/SUCCESS | 程序正常返回 | 长驻服务为什么提前结束 |
code=killed, status=9/KILL | 进程被 SIGKILL 终止 | 是否由 OOM、人为操作或超时升级触发 |
code=killed, status=15/TERM | 进程被 SIGTERM 终止 | 是否属于正常发布、停止或异常管理操作 |
code=dumped, status=11/SEGV | 进程因段错误终止 | 具体故障代码和触发输入 |
status=203/EXEC | systemd 执行启动程序失败 | 是路径、权限、解释器还是其他执行问题 |
有三个容易混淆的边界:
1,不同软件含义可能不同,应结合软件说明和错误日志解释。timeout、watchdog、oom-kill、start-limit-hit;字段支持和实际表现随 systemd 版本及运行环境变化。另外,SuccessExitStatus 等配置可能改变服务对退出结果的分类。数字为零不等于业务正常,非零也未必会被该单元配置视为失败。
若日志是 code=exited,先看退出前的应用记录,再核对最近的配置、版本和依赖变化。常见原因包括配置解析失败、端口占用、凭据失效、工作目录不存在或必要依赖连接失败。
对于 203/EXEC,应检查启动文件、解释器、执行权限以及相关挂载选项。如果怀疑安全策略阻止执行,应查相应拒绝日志,而不是直接关闭安全机制。
配置校验命令必须与软件版本相容,并确认它是只读检查。有些程序不提供独立校验模式,不能把未知参数当成无副作用操作。修复前备份配置;失败时恢复原配置和原启动参数,不要同时更换版本、权限及启动方式。
在已经查看完整内核窗口后,可以筛选重点记录:
sudo journalctl -k \
  --since "$START" --until "$END" \
  --utc --no-pager |
  grep -Ei 'out of memory|oom|killed process'
匹配记录中的 PID、进程名和时间,应与服务退出记录对应。不能因为同一分钟出现了另一进程的 OOM,就把它作为当前服务的原因。
以下为模拟时间线:
10:20:14.120 kernel: Memory cgroup out of memory: Killed process 24831 (myapp)
10:20:14.145 systemd[1]: myapp.service: Main process exited, code=killed, status=9/KILL
10:20:16.200 systemd[1]: Started myapp.service.
同一进程先被内核记录终止,随后 systemd 记录 SIGKILL,再自动重启,这构成了较完整的证据链。
如果宿主机仍有空闲内存,也可能是服务或容器触及独立的 cgroup 内存限制:
sudo systemctl show "$SERVICE" -p MemoryCurrent -p MemoryMax -p ControlGroup
findmnt -t cgroup2
在 cgroup v2 环境中,可按 ControlGroup 返回的路径读取对应 memory.events,关注 oom、oom_kill。计数器只能说明该 cgroup 生命周期内发生过事件,不能单独证明此次故障;重启后 cgroup 还可能被重建。
没有内核 OOM 记录时,还应核对 systemd-oomd、容器管理器、停止超时及人工操作。Docker 环境可只读查看容器状态:
docker inspect --format '{{json .State}}' <容器名或ID>
结合 ExitCode、OOMKilled、FinishedAt 判断,同时检查自动重启是否已更新状态。不要通过反复启动容器来尝试复现内存问题。
出现 SEGV、ABRT 或 core-dump 相关结果,应先保留可执行文件版本、依赖库版本和最近发布记录。有 coredumpctl 的环境可查询:
sudo coredumpctl list --since "$START" --until "$END"
sudo coredumpctl info --since "$START" --until "$END" 24831
第二条命令的 PID 需替换为故障进程 PID。输出有助于确认信号、可执行文件及转储是否可用。
没有转储并不能排除崩溃,可能是转储被禁用、容量受限或文件已清理。核心转储可能包含凭据和用户数据,不应直接公开上传。深度调试宜放在隔离环境进行;扩大生产转储范围前,应评估磁盘、性能和数据安全影响,并准备恢复原设置。
Result=timeout 时,沿时间线确认是启动超时还是停止超时。若先收到 TERM,随后出现 KILL,可能是服务没有在停止期限内退出。
sudo systemctl show "$SERVICE" \
  -p TimeoutStartUSec -p TimeoutStopUSec \
  -p WatchdogUSec -p Restart -p RestartUSec \
  -p StartLimitIntervalUSec -p StartLimitBurst
watchdog 应结合应用卡顿和心跳机制分析;start-limit-hit 通常是连续失败后的保护结果,而不是第一次退出的根因。应向前追查首次失败,不能只放宽超时或清除失败状态。
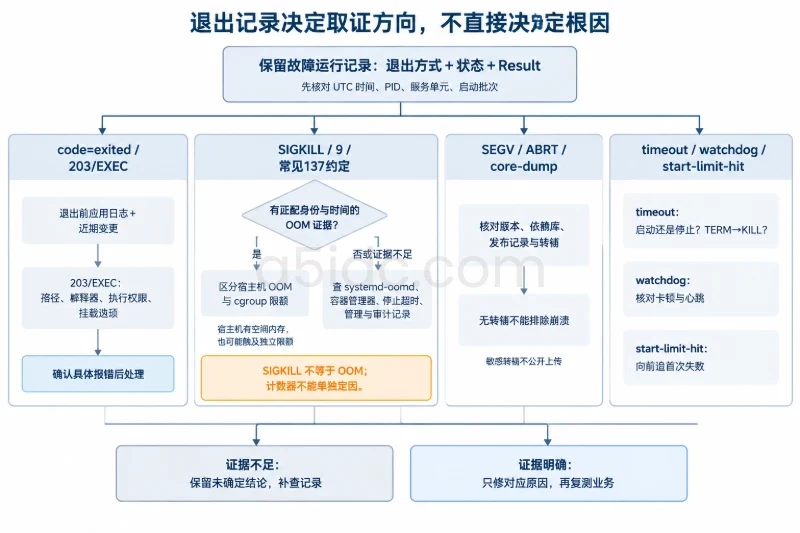
证据明确后,只修复对应原因:配置错误恢复有效配置;内存问题区分泄漏、并发峰值和限额不足;崩溃问题考虑回退近期版本或修复缺陷。
修改前记录配置、版本、资源限制及回滚步骤。重启会中断该实例的连接,应先确认维护窗口;多实例业务可以先摘除待修复实例,再做灰度验证。
完成修复后,如确实需要重启:
sudo systemctl restart "$SERVICE"
sudo systemctl is-active "$SERVICE"
sudo systemctl status "$SERVICE" --no-pager -l
sudo journalctl -u "$SERVICE" --since "5 minutes ago" \
  --utc -o short-iso-precise --no-pager
如果修改了 systemd 单元文件,需先执行 sudo systemctl daemon-reload;普通应用配置是否需要重启,应以应用行为为准。启动失败时,保留新错误记录,恢复备份配置或版本,再按原方式启动,不要连续尝试多个未经验证的改动。
验收不能停留在 active,还应核对:
持续观察至少覆盖触发故障的业务周期,并保留“症状时间—退出记录—系统原因—修复动作—验证结果”的记录。下一次告警时,就能从具体的退出事件继续关联,而不是重新从“服务现在是否正常”开始判断。
A5数据提供香港物理服务器租用,覆盖Xeon Gold、AMD EPYC等平台,配有不同容量的内存及SSD、NVMe存储,为业务后台、数据库和接口服务提供运行资源,也为应用日志留存与故障分析数据存放提供存储基础。香港产品另有大容量存储系列,可承载历史日志归档和备份文件;不同套餐提供CN2或国际带宽,支持面向不同访问人群的业务部署。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/4142.html