香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


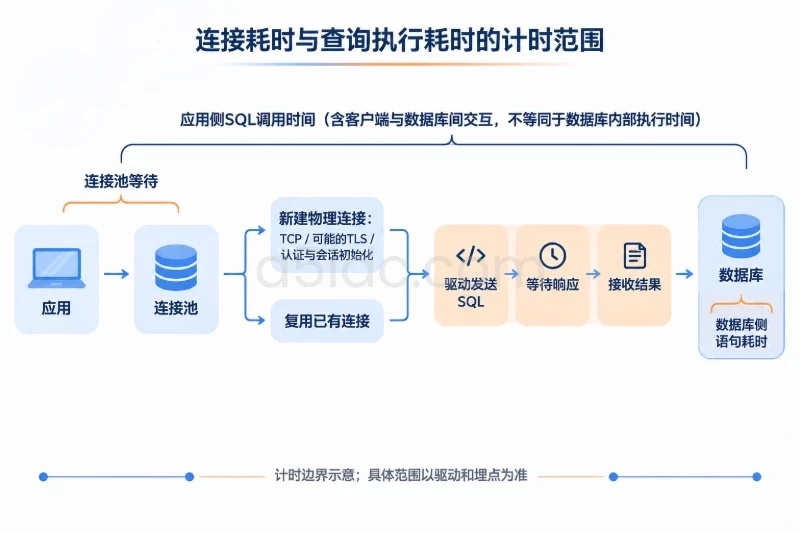
远程连接香港服务器上的数据库时,延迟偏高不一定是数据库本身变慢。一次完整请求通常要经过本地网络、DNS解析、互联网路由、TCP连接、TLS或数据库认证、连接池、数据库排队、SQL执行以及结果传输等环节。只看 ping 或只看某条SQL的执行时间,容易把网络等待、连接建立和应用排队混在一起。
更有效的定位方式是沿着实际请求路径逐段计时:先确认访问入口解析到了哪个地址,再判断本地网络和跨地域路由是否稳定,随后检查香港服务器的CPU、内存、磁盘和连接数,最后把连接池等待、锁等待、SQL执行和结果返回拆开。每一层都需要用对照测试验证,不能因为数据库位于香港,就直接将所有慢请求归因于地域距离。
假设客户端在内地办公网络,数据库部署在香港服务器,客户端通过域名访问数据库。一次请求大致可以表示为:
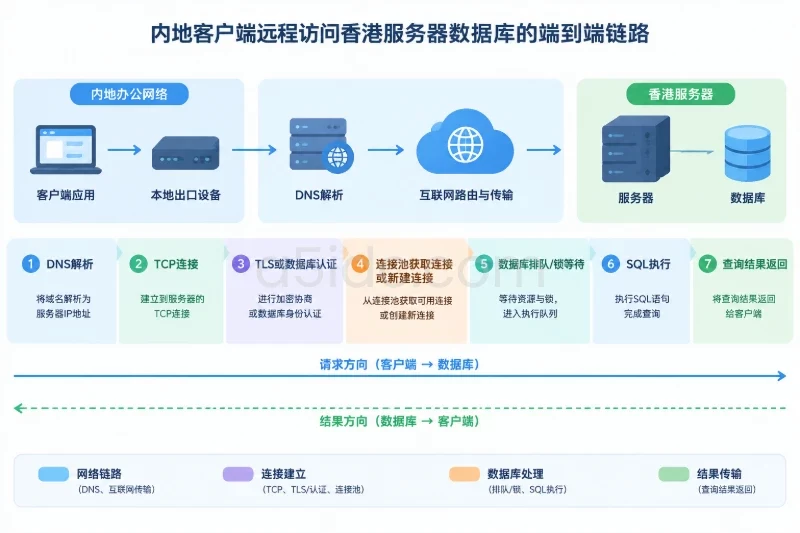
客户端应用
  ├─ 本地网络与出口设备
  ├─ DNS解析数据库域名
  ├─ 到香港服务器的路由与传输
  ├─ TCP连接数据库端口
  ├─ TLS协商、数据库认证
  ├─ 连接池获取连接或新建连接
  ├─ 数据库排队、锁等待、SQL执行
  └─ 查询结果返回客户端
如果中间还经过应用服务器,请求路径会变为:
客户端 → 应用服务器 → 香港数据库服务器
这种架构下,客户端到应用服务器的网络耗时和应用服务器到数据库的内网或专线耗时需要分别统计,不能用客户端到数据库的单次测试代替全部链路。
一次业务请求的总耗时,可以用下面的方式理解:
总耗时
≈ DNS解析
+ TCP连接
+ TLS或认证
+ 连接池等待
+ 数据库排队
+ SQL执行
+ 结果传输
+ 应用程序处理
其中有些阶段只在新建连接时发生。如果应用使用连接池,数据库请求可能不会每次都重新进行DNS、TCP和TLS协商,但连接池耗尽、连接失效或网络抖动时,建立新连接的耗时会突然暴露出来。
排查时建议分别记录以下三类时间:
| 观察对象 | 主要反映的问题 | 不能直接说明的问题 |
|---|---|---|
| ICMP或TCP探测的往返时间 | 网络路径、出口和传输稳定性 | SQL执行是否高效 |
| 建立数据库连接所需时间 | DNS、TCP、TLS、认证和服务器接入能力 | 已建立连接后的查询性能 |
| 业务SQL从发出到收到结果的时间 | 连接池、锁、执行计划、结果集大小和应用处理 | 网络链路中每一跳的具体问题 |
例如,ping 只有约几十毫秒,但业务请求达到数秒,可能是SQL锁等待或连接池排队;反过来,简单查询在服务器本机只需几毫秒,远程客户端却需要数百毫秒,则应优先检查网络、连接建立和多次往返。
首先记录客户端使用的域名、解析结果、数据库端口以及连接方式。MySQL常见端口为3306,PostgreSQL常见端口为5432,但实际环境可能使用自定义端口,不能仅凭数据库类型猜测。
Linux客户端可以执行:
dig +noall +answer db.example.com A
dig +noall +answer db.example.com AAAA
getent ahosts db.example.com
ip route get <解析得到的IP地址>
Windows客户端可以执行:
nslookup db.example.com
Resolve-DnsName db.example.com
Test-NetConnection db.example.com -Port 3306
需要重点确认以下情况:
如果域名返回多个IP,建议分别测试每个地址。一个地址延迟正常、另一个地址丢包或绕行时,应用的连接结果就可能随DNS轮询而波动。
DNS解析通常只发生在连接建立阶段。若DNS查询偶尔耗时几百毫秒甚至数秒,应用在连接池失效、容器重启或短连接模式下会明显变慢;但对于长期保持的数据库连接,DNS通常不是每条SQL的直接耗时来源。
可以分别比较域名和IP的连接时间。直接使用IP仅用于诊断,不建议因此长期绕过域名管理,因为这可能影响地址切换、证书校验和故障迁移。
如果应用访问的是HTTP接口,可以用下面的方式观察各阶段时间:
curl -o /dev/null -sS \
  -w 'dns=%{time_namelookup}s connect=%{time_connect}s tls=%{time_appconnect}s start=%{time_starttransfer}s total=%{time_total}s\n' \
  https://api.example.com/health
这条命令只适用于HTTP或HTTPS入口,不能直接代表数据库协议的耗时。数据库连接应使用对应客户端进行测试。
如果数据库只允许固定来源访问,不应为了排查而临时向公网放开端口。应使用现有的授权来源、运维跳板或应用服务器进行测试,并保留访问控制和审计记录。改变防火墙、监听地址或安全组前,需要先确认影响范围、保存当前配置,并准备按原配置回滚。
远程访问的第一段并不是香港服务器,而是客户端到本地网关、企业出口和运营商接入点。如果办公网络的无线信号、出口带宽或安全设备已经拥塞,后面到香港的路径再稳定,业务也会慢。
可以先检查本地路由和基础丢包:
ip route
ping -c 30 <本地默认网关地址>
ping -c 30 <数据库域名或IP地址>
Windows可使用:
ipconfig
route print
ping -n 30 <本地默认网关地址>
ping -n 30 <数据库域名或IP地址>
如果到本地网关已经出现明显丢包或延迟抖动,应先处理无线接入、交换机端口、企业出口或安全设备问题。此时直接调整数据库参数通常没有效果。
可以在允许的范围内做对照:
对照测试的目标不是寻找“哪个网络最快”,而是确认问题是否只出现在某个客户端、某个出口或某个时间段。
数据库端口可能禁止ICMP,因此ping失败并不代表TCP连接失败;反过来,ping正常也不能说明数据库端口一定可以稳定建立连接。
Linux可以测试TCP端口:
nc -vz -w 5 db.example.com 3306
Windows可以测试:
Test-NetConnection db.example.com -Port 3306 -InformationLevel Detailed
如果TCP端口测试经常超时,而ICMP正常,应关注安全组、主机防火墙、入口设备、连接数限制和路由中的TCP异常。如果TCP连接可以建立,但数据库客户端认证耗时很长,则问题可能位于TLS、认证服务、反向解析或数据库自身的接入处理。
nc只能证明端口是否接受连接,不能证明数据库认证、SQL执行和结果返回正常。端口测试成功后,还需要使用只读账号执行轻量查询。
Linux可以使用TCP方式观察到数据库端口的路径:
traceroute -T -p 3306 -n db.example.com
如果环境安装了MTR,也可以进行一段时间的统计:
mtr -rwzc 100 -T -P 3306 db.example.com
Windows可以使用:
tracert -d db.example.com
pathping db.example.com
路由工具发送的探测包可能被中间设备限速或丢弃。某一跳显示较高丢包,但后续节点和最终目标没有继续丢包时,通常只能说明该设备降低了探测包优先级,不能据此认定业务流量也丢包。
更有价值的判断是:
香港服务器的网络质量不只由地理距离决定,还受到客户端运营商、企业出口、跨地域链路、对等互联和时段拥塞影响。路由发生变化时,服务器没有变,业务延迟也可能明显波动。
平均RTT正常,但偶发延迟很高,通常比平均值偏高更值得关注。数据库连接属于长连接,少量丢包可能造成TCP重传;在交互频繁、结果集较大的请求中,重传会进一步放大等待时间。
可以在客户端观察TCP连接信息:
ss -ti dst <数据库IP地址>
在服务器侧,可以结合网络统计:
sar -n DEV,TCP,ETCP 1 5
nstat -az | egrep 'Retrans|Timeout|Listen|Reset'
不同发行版的统计字段可能略有差异,先确认sysstat和相关工具是否已安装。不要只根据单个计数器下结论,应将重传、RTT、应用超时和业务日志放在同一时间窗口内比较。
如果只有大结果集、文件型字段或批量查询明显变慢,还应检查路径MTU。Linux下可以进行不改变配置的探测:
ping -M do -s 1472 -c 4 <数据库IP地址>
1472是以IPv4、1500字节链路MTU为背景的示例值,不适用于所有网络,也不代表IPv6测试方法。若探测失败,应逐步减小数据包进行对比,但不要仅凭一次探测就修改网卡MTU;修改MTU前必须确认链路设备、容器网络和应用影响,并准备恢复原值。
网络测试显示路径基本稳定后,需要在香港服务器上观察同一时间窗口的资源状态。建议记录问题发生前后至少几分钟的数据,而不是只在故障结束后查看一次当前值。
Linux服务器可以使用以下命令进行只读观察:
uptime
free -h
vmstat 1 5
iostat -xz 1 5
判断重点如下:
vmstat中的运行队列持续较高,可能存在CPU争用;wa持续较高,说明进程可能在等待磁盘I/O;iostat中的设备利用率接近饱和、平均等待时间升高时,应检查数据文件、日志文件和备份任务;如果服务器使用虚拟化或容器,还要查看宿主机争用和容器的CPU、内存限制。容器内看到的资源不一定等于宿主机的实际余量。
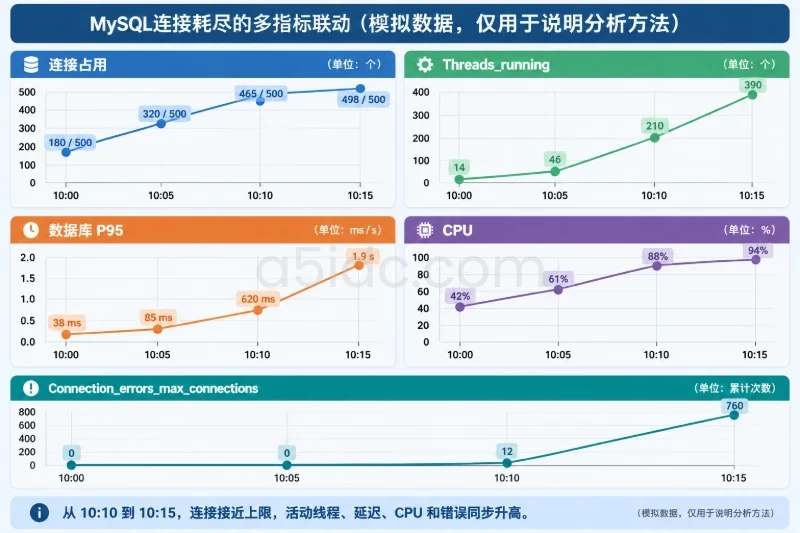
远程访问延迟突然升高,常见原因之一是应用连接池耗尽,或者数据库正在处理大量新建连接。新建连接可能涉及TCP、TLS、认证和权限检查,成本通常高于复用已有连接。
可以先查看TCP连接概况:
ss -s
ss -ant '( sport = :3306 or dport = :3306 )'
数据库层面应使用与数据库类型匹配的只读查询。以MySQL为例:
SHOW GLOBAL STATUS
WHERE Variable_name IN
('Threads_connected', 'Threads_running', 'Max_used_connections',
 'Connections', 'Aborted_connects');

SHOW FULL PROCESSLIST;
以PostgreSQL为例:
SELECT
    state,
    wait_event_type,
    wait_event,
    count(*) AS session_count
FROM pg_stat_activity
GROUP BY state, wait_event_type, wait_event
ORDER BY session_count DESC;
这些查询本身通常不会修改数据,但可能需要管理员权限,也可能暴露SQL文本、账号或业务信息。应使用授权账号,并注意不要把输出中的敏感内容直接发到公共工单或日志系统。
可以重点对照以下现象:
| 现象 | 更值得优先检查的方向 |
|---|---|
Threads_connected接近上限 | 连接池配置、连接泄漏、空闲连接回收 |
Threads_running持续高 | 活跃SQL、锁等待、CPU或磁盘瓶颈 |
| 新建连接数快速增加 | 短连接、应用重启、连接失效、连接池参数 |
| 数据库本机查询也慢 | 数据库资源、锁、执行计划或存储系统 |
| 本机查询快、远程查询慢 | 网络、认证、结果传输或客户端处理 |
不要因为连接数偏高就直接提高数据库最大连接数。提高上限会增加内存、线程调度和锁竞争压力,可能把连接排队变成系统级拥塞。调整前应计算应用实例数量、每实例连接池上限、数据库内存余量和峰值并发,并保留原配置以便回滚。
如果网络和服务器资源没有明显异常,问题往往隐藏在应用层。常见情况包括:
应用日志或链路追踪至少应记录以下时间点:
request_start
dns_start / dns_end
connection_acquire_start / connection_acquire_end
query_send
query_first_response
query_end
response_write_end
示例数据如下,仅用于说明如何判断,不代表某次实际测试:
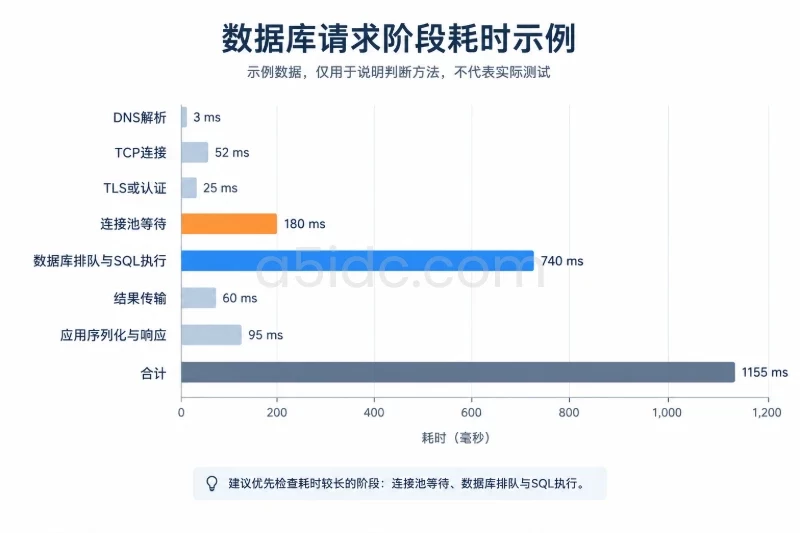
| 阶段 | 示例耗时 |
|---|---|
| DNS解析 | 3 ms |
| TCP连接 | 52 ms |
| TLS或认证 | 25 ms |
| 连接池等待 | 180 ms |
| 数据库排队与SQL执行 | 740 ms |
| 结果传输 | 60 ms |
| 应用序列化与响应 | 95 ms |
| 合计 | 1155 ms |
上述合计为:
3 + 52 + 25 + 180 + 740 + 60 + 95 = 1155 ms
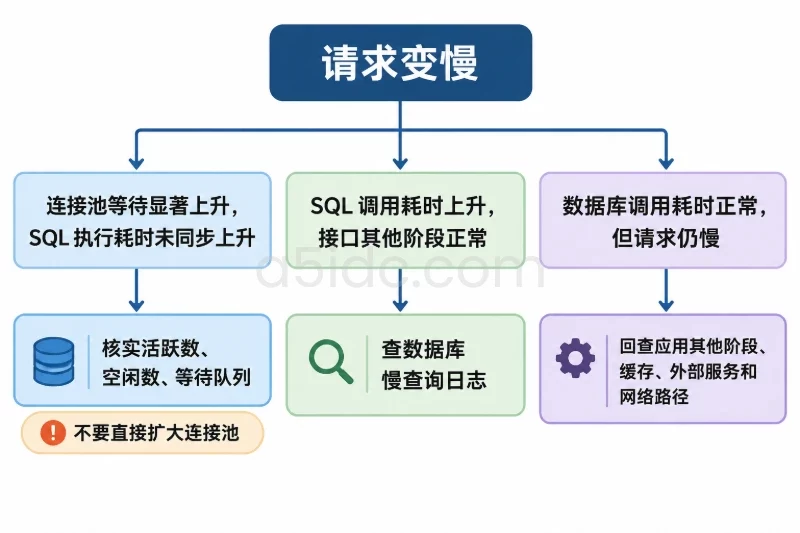
从这个示例看,单纯优化DNS只能减少约3毫秒;真正应先处理连接池等待和数据库执行阶段。如果另一组记录显示网络和SQL都只需几十毫秒,但应用总耗时仍超过1秒,则应查看锁、线程池、序列化、日志输出和重试逻辑。
连接池配置应同时关注:
如果只有高并发时延迟升高,且数据库CPU并不高,连接池等待可能是主要瓶颈。此时不应盲目把池上限调大,应先确认数据库是否还有处理能力,以及应用实例总数是否会将连接数成倍放大。
对单条SQL的诊断至少要区分:
如果数据库日志显示SQL执行只需几十毫秒,但应用从发送到收到完整结果需要数百毫秒,可能是结果集过大、网络重传或客户端逐行处理较慢。可以在不改变业务数据的前提下,使用限制行数的只读测试与完整结果测试进行对比,但不能用小结果集的结论替代生产查询的真实表现。
如果怀疑执行计划问题,应先在测试环境或只读条件下分析。对生产查询直接使用带实际执行的分析选项,可能再次执行复杂SQL或产生额外负载;任何涉及配置、慢查询日志、索引或SQL改写的操作,都应安排变更窗口并准备回滚。
排查时建议保留一份固定记录,避免每次测试的目标、端口、账号、网络出口和查询内容不同。
记录以下信息:
测试过程中不要把密码直接写入命令行、脚本或工单。不要用大查询、全表扫描或高并发脚本验证延迟,避免把诊断行为变成新的负载来源。
如果到默认网关已经延迟抖动或丢包,先处理本地接入、无线网络和企业出口。
记录不同时间和不同解析器返回的地址,分别测试多个地址。若只有某个地址异常,重点检查DNS记录、入口设备或对应服务器。
使用nc或Test-NetConnection记录连接成功率和建立时间。端口超时但ICMP正常时,检查TCP路径和访问控制;端口连接快但认证慢时,继续看TLS、认证和数据库接入日志。
用TCP方式观察到实际数据库端口的路径。只把持续到最终目标的丢包作为重点,不要仅凭中间某一跳的探测结果下结论。
在数据库主机或同一应用服务器上,使用授权只读账号执行SELECT 1等轻量查询。可以分别测试本机地址、内网地址和应用实际使用的地址,但不要因此修改监听配置。
MySQL示例:
   time mysql --protocol=TCP --connect-timeout=5 \
     -h db.example.com -P 3306 -u readonly -p \
     -e "SELECT 1;"
PostgreSQL示例:
   time psql "host=db.example.com port=5432 dbname=appdb user=readonly connect_timeout=5" \
     -c "SELECT 1;"
密码应由客户端安全提示输入或使用已有的安全凭据机制。是否启用TLS、是否指定证书校验,应按照现有安全策略执行,不要为了缩短时间而关闭认证或证书验证。
将测试时间与CPU、磁盘、连接数、锁等待、重传和应用日志对齐。只有同一时间窗口内的指标,才有较强的关联价值。
轻量查询用于判断链路和基础连接,不能代替真实业务。确认基础链路后,再使用受控的业务请求验证连接池、SQL、结果集和应用响应是否恢复。
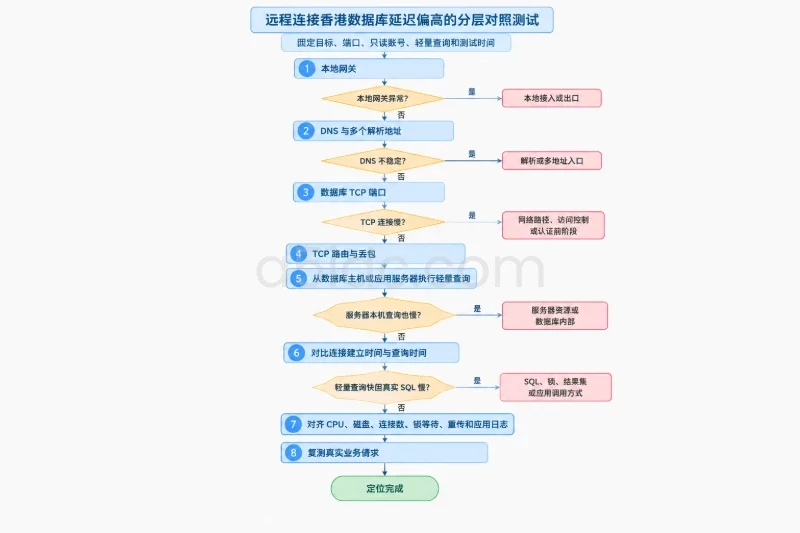
| 对照结果 | 初步定位 | 下一步 |
|---|---|---|
| 本地网关就有抖动 | 客户端接入或本地出口 | 检查无线、交换机、企业出口和安全设备 |
| DNS结果不稳定 | 解析或多地址入口 | 固定记录各IP并分别测试,核对DNS和入口配置 |
| TCP连接时间高,服务器本机查询快 | 网络路径、TCP重传或认证前阶段 | 对比出口、路由、丢包、IPv4/IPv6和TLS认证 |
TCP连接快,服务器本机SELECT 1快,真实SQL慢 | SQL、锁、结果集或应用调用方式 | 查看执行计划、等待事件、结果大小和调用次数 |
| 数据库本机查询也慢 | 服务器资源或数据库内部问题 | 检查CPU、I/O、内存、连接、锁和慢查询 |
| 数据库执行快,客户端收到结果慢 | 结果传输、丢包或客户端处理 | 检查结果集大小、TCP重传、MTU和反序列化 |
| 只有高峰期慢 | 并发、连接池或资源争用 | 对齐峰值监控,分析连接池和数据库并发 |
| 只有某个出口或某类客户端慢 | 特定网络路径 | 比较不同出口的DNS、路由和TCP数据 |
如果问题落在本地网络或特定出口,应先修复接入质量,再重新测试到香港服务器的TCP连接和实际数据库客户端耗时。不要在网络不稳定时通过无限延长数据库超时时间掩盖问题,这会让连接长期占用并扩大故障影响。
如果问题集中在DNS,应核对A、AAAA记录、TTL、多地址入口和解析区域,确认应用是否使用了与人工测试相同的解析结果。修改解析前应记录原记录和生效范围,准备在异常时恢复原配置。
如果是路由抖动或持续丢包,应保存不同时间段的TCP测试、MTR或路由记录,结合客户端出口和服务器侧日志判断责任边界。可从架构层减少跨地域的频繁数据库往返,例如让应用处理节点与数据库保持更近的网络位置,但需要同时评估数据一致性、访问控制和故障切换。
如果是服务器资源或数据库内部等待,应优先处理实际瓶颈:磁盘I/O不足、锁竞争、连接池配置、慢SQL或内存压力分别对应不同方案。不要把增加连接数、提高超时、扩大实例规格当成通用答案;每项调整都应有指标依据、影响范围和回滚方式。
如果是应用层往返过多,重点检查是否存在逐条查询、重复建连、无效重试和过大的结果集。将多次交互合并、复用连接、分页返回或在适当位置缓存,通常比单纯提高数据库配置更有针对性,但缓存和读副本还需要明确一致性要求。
完成调整后,建议按以下顺序复测:
这样才能判断问题究竟是网络路径变差、连接建立变慢、香港服务器资源不足,还是应用把一个跨地域请求拆成了过多数据库往返。定位结果应以分层数据和对照测试为依据,而不是以服务器所在地或单次ping结果作为单一结论。
A5数据提供中国香港物理服务器租用,覆盖入门建站、Xeon Gold及AMD EPYC等配置,配备SSD或NVMe存储,并提供CN2与国际带宽方案,可为数据库、业务后台和接口服务提供相应的计算、存储与网络资源。除香港外,A5数据还布局美国、日本、韩国、中国台湾、新加坡及马来西亚等地区,支持跨地域业务按访问范围与应用负载配置服务器资源。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/3635.html