香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


判断香港服务器上的 Go 应用是否卡在连接池,不能只看 CPU 使用率,也不能仅凭“连接数达到上限”就下结论。真正需要确认的是:请求延迟升高时,是否同时出现连接获取等待;连接池等待发生在数据库、HTTP 客户端、缓存客户端还是应用内部队列;以及下游服务变慢、网络延迟、锁竞争或连接泄漏是否才是更早出现的原因。
一个较可靠的判断链路是:先建立同一时间窗口内的请求、运行时、连接池和系统指标,再观察连接池使用量变化,接着把等待时间与查询执行时间、CPU、I/O、网络和错误率对齐,排除替代解释,最后通过一次受控复测验证。只有当“连接池等待”与“响应时间升高”同步出现,且下游执行时间没有等比例变长,才能较有把握地认为连接池上限是当前并发瓶颈。
针对Go应用并发、数据库连接与网络资源协同运行的场景,A5数据提供中国香港及美国、日本、新加坡等地区的物理服务器租用,覆盖Xeon Gold、AMD EPYC平台,并配备SSD或NVMe存储、不同内存与带宽线路方案,可承载业务后台、数据库、接口服务及多任务运行,为连接池容量、进程资源和跨地区访问提供相应的硬件与网络资源基础。
Go 应用中的“连接池”不是单一对象。运行在香港服务器上的一个服务进程,可能同时维护多类池:
| 连接或资源类型 | 典型对象 | 主要等待位置 | 重点观察指标 |
|---|---|---|---|
| 数据库连接池 | database/sql、数据库驱动 | 获取数据库连接、执行事务 | InUse、Idle、OpenConnections、WaitCount、WaitDuration |
| HTTP 客户端连接池 | http.Transport | 等待可用连接或等待下游响应 | GetConn 到 GotConn 的时间、下游响应时间、连接复用率 |
| 缓存连接池 | Redis、缓存客户端 | 获取缓存连接、等待缓存响应 | 活跃连接、池等待、缓存命令延迟、超时 |
| 应用内部工作池 | channel、信号量、worker pool | 等待消费或等待令牌 | 队列长度、排队时间、worker 数量 |
| 操作系统资源 | 文件描述符、线程、端口 | 创建连接、打开文件、执行阻塞调用 | fd 使用量、线程数、连接状态、系统调用等待 |
因此,“连接池达到上限”只能说明某个资源已经被占满,不能直接说明“连接池配置太小”。例如:
InUse 状态;MaxConnsPerHost 较小,但数据库连接池仍然有大量空闲连接;InUse 持续上升,根因可能是事务、游标或响应体未关闭;在多进程或多副本部署中,连接池上限还要按进程数累加。假设一台香港服务器上运行 4 个 Go 进程,每个进程的数据库 MaxOpenConns 都设置为 32,那么数据库可能面对的最大应用连接数接近 128,而不是 32。容器副本、systemd 多实例和进程管理器拉起的多个服务,都需要纳入计算。
并发问题很容易被单点采样误导。连接数达到上限的一瞬间,可能只是流量突发;CPU 突然升高,也可能只是定时任务;某次请求变慢,还可能是单条慢查询。更适合的做法,是选取一个包含正常阶段和异常阶段的连续窗口,例如 5 至 15 分钟,并让所有指标使用同一时间轴。
观察窗口至少应记录以下背景信息:
把指标按相同时间粒度聚合后,至少形成四组曲线:
database/sql 可以通过 DBStats 读取连接池状态。下面的代码用于说明采集方式,实际接入监控系统时,应将结果转成带有服务名、实例名和数据库标识的指标:
package main

import (
	"database/sql"
	"log"
)

func reportDBPool(db *sql.DB) {
	stats := db.Stats()

	log.Printf(
		"db_pool open=%d in_use=%d idle=%d max_open=%d wait_count=%d wait_duration=%s max_idle_closed=%d max_lifetime_closed=%d",
		stats.OpenConnections,
		stats.InUse,
		stats.Idle,
		stats.MaxOpenConnections,
		stats.WaitCount,
		stats.WaitDuration,
		stats.MaxIdleClosed,
		stats.MaxLifetimeClosed,
	)
}
这里有几个容易误读的地方:
WaitCount 和 WaitDuration 是累计值,需要计算观察窗口内的增量;WaitCount 增加,说明有调用者等待过连接,但不代表当前仍有多少个请求在等待;MaxOpenConnections 为 0 时通常表示不限制最大打开连接数,具体行为还要结合驱动和版本确认;InUse 高不一定异常,关键是它是否伴随等待和响应时间升高;Idle 长期为 0 可能说明连接池长期处于满负载,也可能只是流量高峰;MaxLifetimeClosed 或 MaxIdleTimeClosed 突然增加,可能引发批量重连和连接建立延迟。如果暂时没有完整的指标系统,也可以在低风险时段使用系统工具辅助确认:
pidstat -p 1234 -t 1
vmstat 1
iostat -xz 1
ss -s
这些命令只能帮助观察进程线程、CPU 等待、磁盘和连接概况,不能替代应用侧的连接池等待指标。尤其是数据库连接获取等待,通常只有在应用中主动埋点或读取驱动统计后,才能与接口请求准确对齐。
连接池成为直接瓶颈时,常见时间顺序是:
InUse 接近池上限;如果只有第 2 步发生,而第 3 步没有发生,说明连接池可能只是被充分利用,还不能称为瓶颈。相反,如果池中连接并未达到配置上限,却出现明显等待,需要检查是否存在其他限制,例如每个租户的信号量、数据库驱动内部限制、HTTP 客户端连接限制或应用 worker 数量。
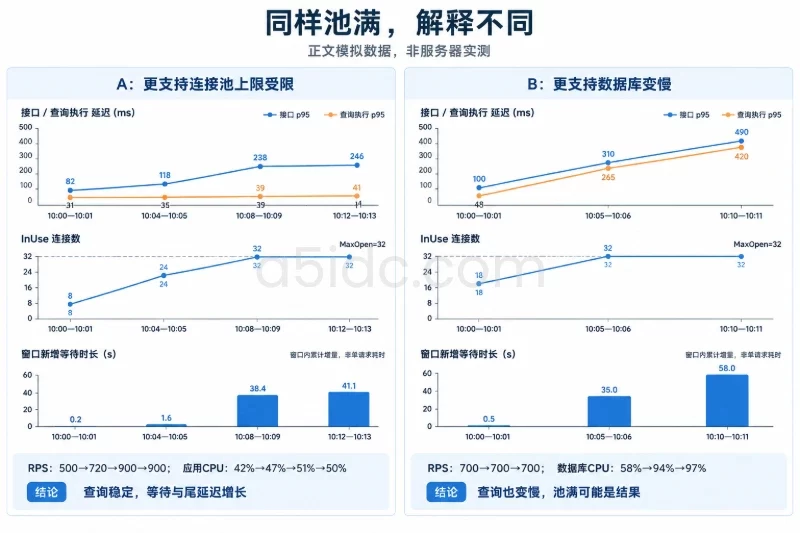
下面是一组用于解释关联关系的模拟数据,不代表某台香港服务器的实际监控结果:
| 时间窗口 | RPS | 接口 p95 | 数据库 InUse/MaxOpen | 新增等待时长 | 查询执行 p95 | 应用 CPU | 错误率 |
|---|---|---|---|---|---|---|---|
| 10:00—10:01 | 500 | 82 ms | 8/32 | 0.2 s | 31 ms | 42% | 0.05% |
| 10:04—10:05 | 720 | 118 ms | 24/32 | 1.6 s | 35 ms | 47% | 0.08% |
| 10:08—10:09 | 900 | 238 ms | 32/32 | 38.4 s | 39 ms | 51% | 0.72% |
| 10:12—10:13 | 900 | 246 ms | 32/32 | 41.1 s | 41 ms | 50% | 0.81% |
在这个模拟场景中,查询本身的 p95 仍然只有约 40 毫秒,但接口 p95 已经接近 250 毫秒,新增等待时长明显增加,CPU 也没有达到饱和。此时更像是请求在获取数据库连接之前排队,连接池上限是当前的直接瓶颈。
但如果数据变成下面这样,判断就不同:
| 时间窗口 | RPS | 接口 p95 | InUse/MaxOpen | 新增等待时长 | 查询执行 p95 | 数据库 CPU |
|---|---|---|---|---|---|---|
| 10:00—10:01 | 700 | 100 ms | 18/32 | 0.5 s | 48 ms | 58% |
| 10:05—10:06 | 700 | 310 ms | 32/32 | 35.0 s | 265 ms | 94% |
| 10:10—10:11 | 700 | 490 ms | 32/32 | 58.0 s | 420 ms | 97% |
这里同样出现了连接池等待,但查询执行时间、数据库 CPU 也同步恶化。连接池是请求排队的位置,却未必是根因。增加连接数可能只会让更多查询同时压向已经繁忙的数据库。
Go 应用通常以一个或多个操作系统进程运行,进程内部由大量 goroutine 承载请求。goroutine 会由 Go runtime 调度到操作系统线程上,并不是一个请求对应一个线程。
因此,以下指标需要分别理解:
GOMAXPROCS 影响能够同时执行 Go 代码的逻辑处理器数量,不直接决定数据库连接数;判断连接池时,应把 CPU 曲线和池等待曲线放在一起:
如果需要查看 Go 运行时的 goroutine、CPU profile 或阻塞 profile,应确保调试接口只绑定到本机或受控管理网络,不能直接暴露到公网:
package main

import (
	"log"
	"net/http"
	_ "net/http/pprof"
)

func startPprof() {
	go func() {
		log.Println(http.ListenAndServe("127.0.0.1:6060", nil))
	}()
}
采集完成后应关闭或移除调试入口。pprof 只用于定位运行时特征,不能直接证明数据库连接池存在问题。
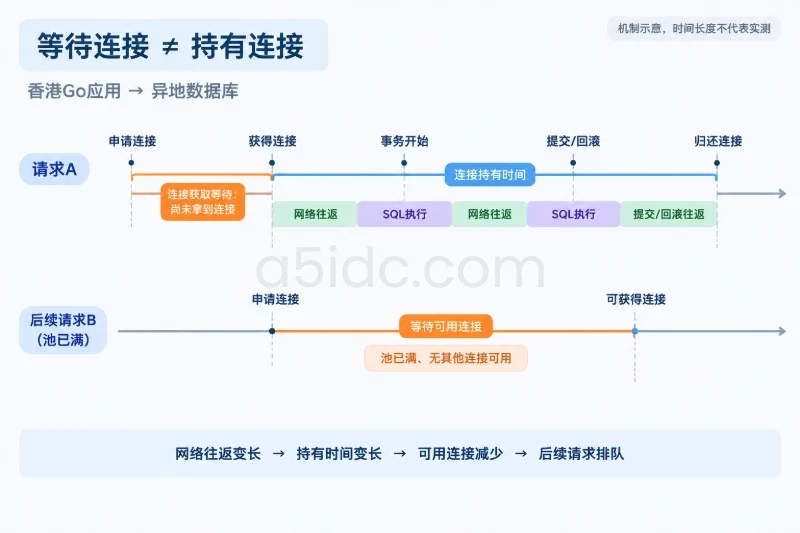
香港服务器与数据库之间的网络位置,会显著影响连接占用时间。这里需要区分两种延迟:
例如,应用在香港,数据库位于其他地域。一次事务包含多次网络往返,即使 SQL 本身执行很快,整个事务仍可能持有连接较长时间。连接池容量不变时,单位时间内可承载的并发请求自然下降。
网络方向至少应同时观察:
如果接口 p95 上升时,数据库连接 InUse 上升、池等待增加,但查询执行时间和网络 RTT也同时变长,优先检查跨地域链路或下游服务,而不是立刻把池上限调大。
对于 HTTP 客户端,还要注意不同参数的含义。MaxConnsPerHost 限制到某个目标主机的总连接数;MaxIdleConnsPerHost 主要影响空闲连接复用,不等价于并发连接上限。HTTP 客户端通常需要通过 httptrace 或自定义 RoundTripper 记录从 GetConn 到 GotConn 的时间,才能识别是否在等待连接,而不是把整个 HTTP 请求时间都归为连接池等待。
连接池只是众多排队点中的一个。一个请求可能依次经过以下路径:
客户端请求
  -> 反向代理或监听队列
  -> Go handler
  -> 应用信号量或 worker queue
  -> 数据库连接池
  -> 数据库锁与执行队列
  -> 数据库连接返回
  -> 序列化、缓存和响应发送
只看数据库连接池,容易漏掉前后其他队列。
如果应用设置了并发信号量,例如同时只允许固定数量的任务运行,那么请求可能在进入数据库连接池之前就已经等待。常见表现是:
InUse 没有接近上限;此时提高数据库连接数不会改善响应时间,甚至可能增加无意义的并发。需要记录队列进入时间、开始处理时间和完成时间,把排队时间从实际执行时间中拆出来。
当事务持有连接期间等待行锁、表锁或其他事务释放资源时,连接会一直处于 InUse。最终结果与连接池太小十分相似:
InUse 达到上限;WaitCount 和 WaitDuration 上升;区别在于,数据库侧的锁等待、事务持续时间和查询执行 p95 会同步变差。此时应优先定位慢 SQL、长事务、索引、锁顺序和事务边界,而不是单纯扩容连接池。数据库诊断需要由具备相应权限和备份、变更流程的人员执行,应用侧可先通过请求 ID、事务 ID 和查询耗时完成关联。
如果连接没有正确归还,常见曲线不是“随着流量来回波动”,而是 InUse 在低流量阶段也逐步上升,Idle 越来越低,最终触发等待或超时。重点检查:
rows.Close() 是否在所有分支执行;Rollback;*sql.Conn 是否调用 Close;长事务则可能在请求结束前合法地占用连接,但占用时间异常长。应将“获取连接时间、事务开始时间、SQL 执行时间、事务提交或回滚时间”分开记录,不能只看一条总耗时。
当应用需要新建连接却无法成功打开 socket 时,错误可能表现为连接池耗尽、请求失败或大量重试。此时观察:
EMFILE、ENFILE 等错误;LimitNOFILE 是否足够;连接池上限、文件描述符上限和数据库服务端连接上限必须相互匹配。只提高应用池上限,而不检查操作系统和数据库限制,可能把原本可控的排队变成连接创建失败。
可以用下面的对照表缩小范围。它不是固定阈值表,而是判断不同指标组合所支持的解释。
| 观察到的组合 | 更可能的解释 | 需要进一步确认 |
|---|---|---|
InUse 接近上限,池等待增加,查询执行时间基本稳定,CPU中等 | 连接池上限偏小或并发配置不匹配 | 每进程池上限、总进程数、数据库可承载连接数 |
InUse 接近上限,池等待增加,查询执行时间和数据库 CPU同步升高 | 下游数据库变慢,连接池是被动饱和 | 慢查询、锁等待、磁盘 I/O、数据库连接上限 |
InUse 长期升高,低流量时也不回落,Idle接近 0 | 连接泄漏、长事务或请求未取消 | rows、事务、连接关闭路径和上下文超时 |
| 数据库池有空闲连接,但接口仍排队 | 瓶颈在应用队列、HTTP池、缓存池或共享锁 | 各队列长度、worker、HTTP GotConn等待 |
| CPU接近饱和,池等待不明显,goroutine runnable上升 | CPU、序列化、加密、压缩或锁竞争 | CPU profile、mutex/block profile、GC |
| 网络 RTT、重传和下游耗时升高,连接持有时间变长 | 网络路径或下游服务变慢 | 应用到下游的分段延迟与连接建立时间 |
| 连接创建量突然增加,池等待和错误率周期性出现 | 空闲连接回收、连接寿命或服务端主动断开 | MaxLifetimeClosed、MaxIdleTimeClosed、连接复用率 |
| 单个进程正常,但数据库总连接数很高 | 多进程或多副本累计连接超出预期 | 实例数量乘以每实例池上限 |
这里最重要的区分是“直接瓶颈”和“根本原因”。
例如,数据库慢导致应用连接长期占用,连接池等待是直接发生的位置;但根因在数据库查询或锁竞争。调大连接池可能暂时降低应用排队,却也可能让更多慢查询同时进入数据库,最终使数据库 CPU、锁等待和错误率进一步升高。
可以用排队系统中的基本关系做初步估算:
并发占用量 ≈ 每秒请求数 × 单次占用资源的秒数
这不是连接池的最终配置公式,但能帮助发现数量级错误。
例如,一个接口每秒处理 800 个请求,其中 40% 会访问数据库;每次事务平均持有数据库连接 70 毫秒:
数据库连接需求 ≈ 800 × 40% × 0.070
                = 22.4 个连接
这表示在该平均负载下,约有 22 至 23 个连接会被持续占用。若将接口峰值、p95 持有时间、事务重试和实例波动纳入,实际需要的池容量可能高于这个平均值。
如果所有请求都访问数据库,且每次连接占用 70 毫秒,则估算变为:
数据库连接需求 ≈ 800 × 0.070
                = 56 个连接
这个数字也不能直接变成 MaxOpenConns=56,因为还要考虑:
如果单个进程设置 32 个连接,运行 4 个进程,按最大值就是 128 个潜在连接。即使每个进程单独看都没有明显等待,也要确认数据库总连接数是否接近服务端限制。
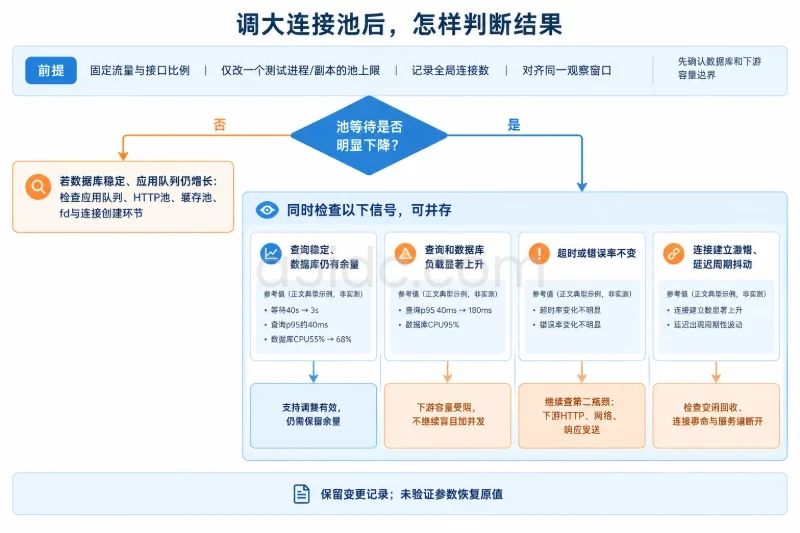
确认连接池可能是直接瓶颈后,不要同时修改数据库连接数、worker 数、超时、重试和 SQL。一次只改变一个主要变量,才能知道结果来自哪里。
可以按以下顺序组织复测:
连接池调整需要设置边界。对于数据库连接,应该先确认数据库端最大连接数和业务侧允许的并发,再逐步增加;不应在不了解数据库负载的情况下大幅修改服务端全局连接配置。对于 HTTP 客户端,增加并发连接前要确认下游服务是否支持对应并发量,并设置合理的上下文超时和重试上限,避免连接池扩大后形成重试风暴。
一个典型的验证结果如下:
下一次遇到类似问题时,建议把以下指标放在同一张按分钟或更细粒度对齐的图上:
Open、InUse、Idle、最大值、等待次数增量和等待时长增量;当“活跃连接达到上限、连接获取等待明显增加、接口尾延迟同步升高、实际查询执行时间保持稳定,并且应用 CPU、内部队列、网络和下游资源没有更早的异常”同时成立时,才可以把连接池上限认定为当前并发瓶颈。若连接池等待和下游执行时间一起升高,应把它视为资源饱和的表现,继续追查数据库、网络、锁和事务,而不是只增加连接数。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/3486.html