香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


页面偶尔返回503,接口在某个时刻突然变慢,随后又恢复;任务管理器里的w3wp.exe进程号也不断变化。遇到这些现象,不要马上重启IIS。要确认应用程序池为什么频繁回收,应先查看Windows“系统”日志中的WAS事件,再关联“应用程序”日志里的崩溃记录、IIS访问日志和HTTPERR日志,重点对齐应用程序池名称、进程ID、触发原因与发生时间。
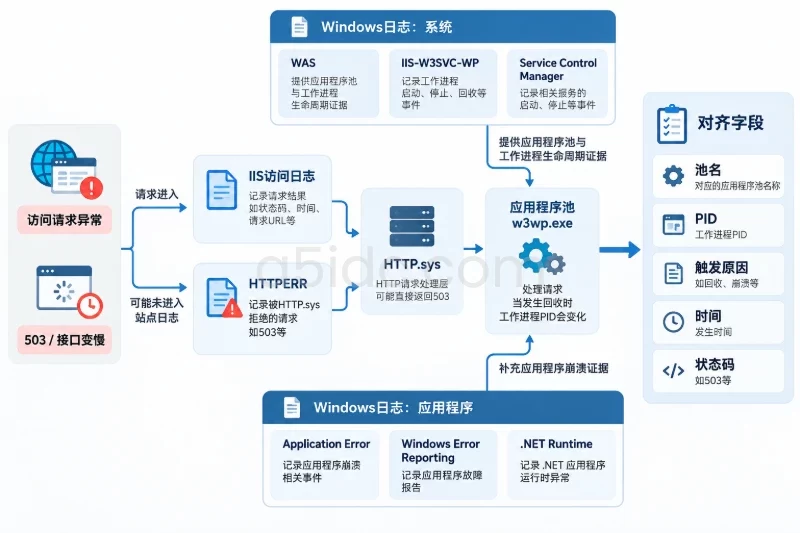
对于香港Gold 6138+64GB内存、运行Windows Server 2025的服务器,排查方法仍以IIS进程生命周期为主线。64GB物理内存不代表单个应用程序池没有内存限制,处理器型号也不能直接解释回收原因;香港部署环境更需要注意服务器、监控平台与访问日志之间的时区差异。下面按低风险到高风险的顺序,逐层确认问题来源。
应用程序池回收,是IIS按条件替换工作进程的机制。启用重叠回收时,新旧工作进程可能短暂共存:新进程承接请求,旧进程处理剩余请求后退出。
但以下情况也会造成w3wp.exe消失或PID变化:
PID变化只能证明进程发生了更替,不能单独证明回收原因。 应用程序池显示“Started”也不代表工作进程始终存在。
先记录一次故障的基本信息:访问哪个站点、哪个接口、出现什么状态码、用户观察到的时间、持续多久。尽量精确到秒,并保留负载均衡或CDN侧的请求标识,便于后续关联。
以下命令在服务器本机、以管理员身份打开的Windows PowerShell 5.1中执行,前提是已经安装IIS。示例应用程序池名为ShopPool,执行前替换为实际名称。
$pool = 'ShopPool'
$appcmd = "$env:windir\System32\inetsrv\appcmd.exe"

Get-Date -Format o
Get-TimeZone

& $appcmd list apppool "$pool" /text:*
& $appcmd list app "/apppool.name:$pool"
& $appcmd list wp /text:*
这组操作不修改配置,也不回收进程,结果分别用于确认:
如果找不到appcmd.exe,先核实IIS是否安装在该服务器上,以及当前是否登录到了实际承载站点的节点。如果应用程序池已启动但没有工作进程,可能是按需启动或空闲终止,不要立即认定为故障。
还应检查processModel.maxProcesses。如果配置允许多个工作进程,不能把每个PID都视为独立的一次回收。
IIS访问日志回答的是:“哪些请求受到影响,影响从什么时候开始?”
默认日志目录通常为:
C:\inetpub\logs\LogFiles\W3SVC<站点ID>\
实际目录、日志格式和启用字段以IIS管理器中该站点的“日志”配置为准。可以先查询站点ID:
& $appcmd list site /text:*
使用W3C格式时,应先看文件中的#Fields行,再按实际字段顺序解析,不能套用其他服务器的列位置。
| 字段 | 关注内容 | 判断意义 |
|---|---|---|
date、time | 故障开始与结束时间 | 确定请求层面的异常窗口 |
cs-uri-stem | 集中出错的接口或页面 | 区分局部应用问题与整站问题 |
sc-status | 503、500、502等状态 | 判断错误类型 |
sc-substatus | IIS子状态码 | 进一步区分IIS侧处理结果 |
sc-win32-status | Windows错误码 | 辅助识别连接中断、超时等情况 |
time-taken | 耗时变化,单位为毫秒 | 判断回收前是否已出现持续变慢 |
time-taken不应直接等同于应用内部函数执行时间,它可能受到请求处理和网络发送等因素影响。看到耗时上升,还需要结合应用日志分析。
另外,IIS常用的W3C日志时间是UTC,而事件查看器通常按查看端的本地时区显示。若服务器配置为UTC+8,W3C日志中的02:10:00对应本地10:10:00。不要因为服务器位于香港,就默认所有日志都使用香港时间。
如果同一时刻只有一个接口报错,优先检查该接口和依赖服务;如果同池多个应用同时异常,则更接近工作进程或共享资源层面的故障。
部分503请求可能在HTTP.sys层就被拒绝,未进入IIS站点访问日志。此时查看:
C:\Windows\System32\LogFiles\HTTPERR\
这是常见默认路径,实际位置和是否启用需要结合服务器配置核实。HTTPERR日志通常也是UTC时间。
重点关注时间、状态、原因字段,以及日志中可用的队列信息。例如:
QueueFull:应检查对应请求队列和处理能力,不等于已经证明发生回收。AppOffline:可能与应用程序池不可用或应用离线状态有关。HTTPERR里的原因字符串应结合完整记录解释。它适合补齐“访问日志为什么缺了一段”,但不能代替WAS提供的进程生命周期证据。
打开事件查看器,进入:
Windows 日志 → 系统
优先筛选以下事件源:
Microsoft-Windows-WASMicrosoft-Windows-IIS-W3SVC-WPService Control ManagerWAS负责应用程序池和工作进程生命周期管理,是定位回收原因的核心入口。打开事件时,既看“常规”消息,也看“详细信息”中的XML字段。
需要记录的内容包括:
| 证据字段 | 用途 |
|---|---|
| 时间戳 | 与请求异常、部署动作和监控曲线对齐 |
| 应用程序池名称 | 避免把其他站点的事件误归到目标池 |
| 工作进程PID | 关联旧进程、新进程与崩溃记录 |
| 回收或退出原因 | 区分时间、内存、配置变更、按需操作等触发条件 |
| 错误码、退出码 | 判断正常退出还是异常终止 |
| 事件源与事件ID | 辅助分类,并保留可复核的信息 |
常见WAS事件中,5009可用于关注工作进程异常终止,5011可用于关注工作进程与WAS之间的通信异常,5002可用于关注应用程序池因连续失败而被停用。具体判断必须以事件正文、池名和PID为准,不能只看到某个事件ID就认定根因。
如果故障时间附近没有回收原因记录,也不意味着没有发生回收:该触发原因可能没有启用事件记录,相关事件可能已被覆盖,或本次实际上是空闲终止、崩溃、停用等其他生命周期事件。
再查看:
Windows 日志 → 应用程序
重点检查:
Application Error:例如事件1000,关注故障应用、故障模块、异常代码和PID。Windows Error Reporting:例如事件1001,关注报告标识及相关信息。.NET Runtime:例如事件1026,关注未处理异常与异常堆栈。对于ASP.NET Core,还要区分托管模式。进程内托管时,应用运行在w3wp.exe中;进程外托管时,还可能有dotnet.exe或应用自身的可执行进程。后者退出,不一定对应一次IIS应用程序池回收。
Application Error中的“故障模块”也不一定就是根因。内存破坏可能在运行库里最终暴露,需要结合异常堆栈或转储分析。
下面示例导出服务器本地时间10:00至10:30的相关事件。日期、池名和时间需要按实际故障修改:
$from = Get-Date '2025-08-12 10:00:00'
$to   = Get-Date '2025-08-12 10:30:00'
$dir  = 'C:\IIS-Diag'

New-Item -ItemType Directory -Path $dir -Force | Out-Null

$systemEvents = Get-WinEvent -FilterHashtable @{
    LogName   = 'System'
    StartTime = $from
    EndTime   = $to
} | Where-Object {
    $_.ProviderName -in @(
        'Microsoft-Windows-WAS',
        'Microsoft-Windows-IIS-W3SVC-WP',
        'Service Control Manager'
    )
}

$appEvents = Get-WinEvent -FilterHashtable @{
    LogName   = 'Application'
    StartTime = $from
    EndTime   = $to
} | Where-Object {
    $_.ProviderName -in @(
        'Application Error',
        'Windows Error Reporting',
        '.NET Runtime'
    )
}

$events = @($systemEvents) + @($appEvents)

$events |
    Sort-Object TimeCreated |
    Select-Object @{
        Name = 'LocalTime'
        Expression = { $_.TimeCreated.ToString('o') }
    }, LogName, ProviderName, Id, RecordId, Message |
    Export-Csv "$dir\events.csv" -NoTypeInformation -Encoding UTF8
预期结果是一份按时间排序、保留完整消息的CSV。它用于初筛,不代替原始事件:找到关键记录后,应在事件查看器中另存相关事件为.evtx,保留XML数据。
如果提示没有匹配事件,先核对时间范围、时区和日志保留情况;如果提示权限不足,则检查是否以管理员运行。不要把读取失败当作“没有故障”。导出文件还可能包含内部路径和应用信息,不应放入网站公开目录。
在IIS管理器的应用程序池“高级设置”及“回收”设置中,核对:
前面的appcmd list apppool ... /text:*可以辅助读取这些配置。
有些新建池沿用约29小时的定时回收间隔。这种回收时刻可能逐日移动,不一定每天发生在同一个钟点。但实际服务器可能已被部署脚本或管理员修改,必须以当前配置和历史事件为准。
内存设置尤其容易误读:应用程序池的内存阈值使用KB口径,按每KB为1024字节换算。例如8GiB对应:
8 × 1024 × 1024 = 8,388,608 KB
如果专用内存限制设置为这个值,即使服务器还有大量空闲内存,工作进程达到阈值仍可能触发回收。阈值为0通常表示不按该项限制触发回收,但不代表进程没有其他内存边界。
若已确认回收发生,但日志没有说明触发条件,可在维护窗口补充回收事件记录。该操作会修改IIS配置,可能触发配置变更相关的行为,应先记录原值并备份。
# 先读取并保存原值
& $appcmd list apppool "$pool" /text:recycling.logEventOnRecycle

# 备份IIS配置
$backup = 'BeforeRecycleLog-' + (Get-Date -Format 'yyyyMMdd-HHmmss')
& $appcmd add backup "$backup"

# 为目标应用程序池补充回收原因记录
& $appcmd set apppool "$pool" `
    "/recycling.logEventOnRecycle:Time,Requests,Schedule,Memory,IsapiUnhealthy,OnDemand,ConfigChange,PrivateMemory"
预期结果是之后发生的相应回收能够留下原因事件,而不是找回过去未记录的信息。执行后重新读取该项,确认设置已生效。
回滚时应只把目标池的logEventOnRecycle恢复为之前保存的值。不要随意恢复整份IIS备份,因为整站配置恢复可能覆盖其他应用在此期间的合法变更。也不要为了“验证日志”直接手动回收生产池。
下面是一组示例时间线,不代表读者服务器已发生这些情况:
| 统一后的本地时间 | 证据 | 解释 |
|---|---|---|
| 10:12:20 | 旧PID专用内存接近配置阈值 | 存在内存触发条件 |
| 10:12:24 | WAS记录目标池因专用内存条件回收 | 确认本次回收原因 |
| 10:12:25 | 新工作进程出现,旧进程仍存在 | 可能处于重叠回收阶段 |
| 10:12:28 | 接口耗时明显增加 | 可能与新进程初始化有关 |
| 10:12:40 | 旧进程退出,接口耗时恢复 | 与进程交接窗口相吻合 |
这里可以得出“本次回收由专用内存条件触发”,但还不能得出“应用存在内存泄漏”。泄漏需要进一步证明:在相近负载下,内存持续增长,经过合理回收或业务空闲仍不能回落。
关联时不要要求不同日志完全同秒。日志写入、报告生成和请求完成之间存在延迟,应比较事件顺序与合理时间邻近性。
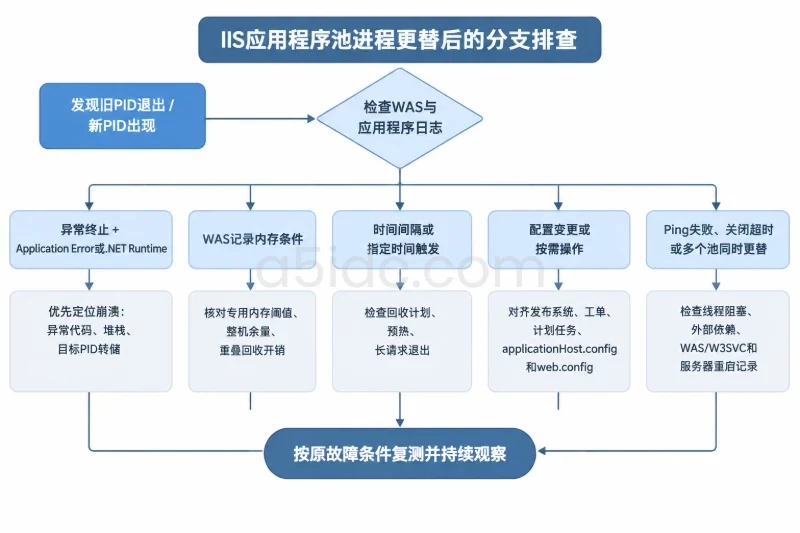
如果日志明确记录时间间隔或指定时间触发,且没有崩溃事件,优先检查回收安排与应用启动过程。
修复方向通常是把计划回收调整到低峰期,核查重叠回收设置,并改善应用预热、缓存重建及首次数据库连接。对长请求,还要检查旧进程退出期限是否足够。
调整前保存原回收计划,每次只改变一个条件。验证时同时观察新旧PID、接口耗时和错误率;若影响变大,恢复原计划。不要用频繁定时回收来长期掩盖资源泄漏。
在Gold 6138+64GB环境中,应分开看“服务器容量”和“单进程限制”。
64GB配置不等于全部内存都能分配给一个池。系统、数据库、缓存、其他应用,以及重叠回收期间的新旧进程都需要余量。如果服务器运行在虚拟化环境中,还应核实Windows实际可见的CPU与内存:
Get-CimInstance Win32_ComputerSystem |
    Select-Object NumberOfProcessors,
                  NumberOfLogicalProcessors,
                  TotalPhysicalMemory
TotalPhysicalMemory以字节表示;CPU数量也应以系统读取结果为准,不能仅凭Gold 6138型号推定这台服务器的插槽数量或虚拟机配额。
可用下面的只读命令观察当前IIS进程:
Get-Process w3wp -ErrorAction SilentlyContinue |
    Select-Object Id, StartTime,
        @{Name='PrivateMiB'; Expression={
            [math]::Round($_.PrivateMemorySize64 / 1MB, 1)
        }},
        @{Name='WorkingSetMiB'; Expression={
            [math]::Round($_.WorkingSet64 / 1MB, 1)
        }},
        Handles,
        @{Name='Threads'; Expression={$_.Threads.Count}}
这里的MiB按1024²字节计算。专用内存与工作集不是同一个指标,不能只看任务管理器中某一列。每次采样都应同步保留appcmd list wp结果,防止回收后把不同PID的数据拼成一条曲线。
如果内存随并发增长后趋于稳定,更可能是容量或缓存策略问题;如果相近负载下持续增长,则应检查对象保留、缓存上限、连接释放和本机组件。
提高阈值前,应确认整机剩余内存、其他服务峰值及重叠回收开销。关闭内存限制可能只是把单池回收变成整机内存压力,不能直接作为修复结论。
如果事件链表现为异常终止、Application Error或.NET Runtime异常,再出现新PID,应优先处理崩溃。
快速故障防护是保护机制。连续崩溃后应用程序池停用并出现503,并不表示“关闭保护”就能解决问题。应根据异常代码和堆栈定位运行时、应用代码、本机模块或依赖组件。
必要时,在审批和维护安排下针对目标PID采集进程转储。完整转储可能占用大量磁盘、增加I/O,并包含口令、令牌及业务数据。采集前要确认可用空间、访问权限和保留期限,工具版本须核验对Windows Server 2025的适用性。
退出采集工具、恢复临时诊断配置,才是采集操作的回退;转储本身不能代替应用修复。不要使用按进程名的粗放方式同时抓取所有w3wp.exe。
如果日志指向配置变更或按需回收,将时间线与发布系统、运维工单、计划任务和配置管理记录对齐。
重点检查应用程序池设置、applicationHost.config、web.config及发布脚本。配置文件变化也可能只引起应用重新加载,而非整个池回收,仍需用PID和WAS事件区分。
文件最后修改时间只能提供线索,不能证明修改人和修改内容。没有提前启用相应审计时,也不能从缺失的审计日志推断“无人操作”。
如果事件显示工作进程未及时响应Ping,应检查线程阻塞、CPU占用、垃圾回收暂停及外部依赖等待。Gold 6138的并行处理能力不能消除死锁、锁竞争或同步等待。
如果旧进程迟迟无法退出,应检查长请求、后台任务和停止逻辑。盲目延长超时可能让问题进程占用资源更久。
若多个池在同一时刻一起发生进程更替,则转向检查WAS、W3SVC服务和服务器重启记录,不要分别给每个池做“内存优化”。
一次回收后暂时没有503,只能说明当前请求恢复,不能证明原因已消除。修复后应在与原故障相近的访问条件下复测,并覆盖原来的触发周期。
建议保留以下验收项:
若原问题一天发生多次,可先连续观察24至48小时;若与约29小时的周期有关,至少跨越两个实际触发周期。若只在批处理、峰值访问或发布期间出现,则必须覆盖对应场景,而不是只观察空闲时段。
对于A5IDC香港服务器上的这一类问题,最终需要留下的不是“已经重启恢复”,而是一条可复核的记录:请求何时异常、哪个池和PID受到影响、什么事件触发进程更替、采取了什么修复,以及复测后是否再次出现。 将这条记录与持续监控一起保存,下次发生类似现象时,就能直接沿证据排查,而不必重新猜测。
围绕IIS网站、业务后台与接口服务的运行需求,A5数据提供香港物理服务器资源,涵盖Gold 6138搭配64GB内存、960GB NVMe及更高内存容量的Xeon Gold、AMD EPYC方案,为多应用运行、数据库缓存和日志留存提供计算与存储基础。香港产品另有CN2与国际带宽选择,可承接面向不同访问人群的业务部署需求,让应用服务与日常运维拥有相应的基础设施支撑。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/3149.html