香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


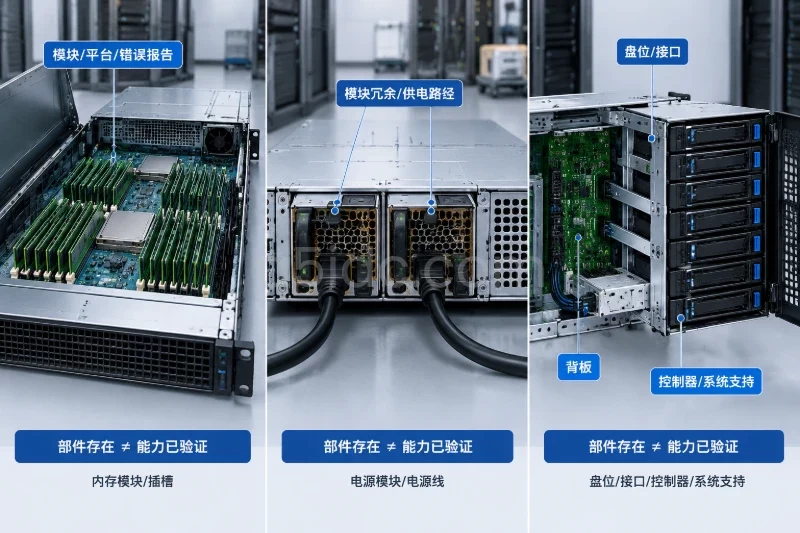
配上ECC内存、双路电源和热插拔背板,物理机的可靠性确实比单电源、普通内存和固定硬盘架更高,但这三个配置并不等于“整机没有单点故障”。它们分别覆盖了部分内存错误、电源模块故障和硬盘更换场景;一旦故障落在内存插槽、供电上游、背板、RAID控制器、风扇墙、主板、网卡或启动介质上,服务仍可能中断。
真正需要审查的不是“有没有冗余部件”,而是冗余是否跨越了完整故障路径,并且在故障发生后能否被发现、隔离和更换。双路电源共用一个PDU时,仍然可能被同一个断路器击穿;硬盘支持热插拔时,背板本身损坏仍可能让整组硬盘同时消失;ECC能够处理一部分内存位错误,却不能替代内存通道、主板和操作系统层面的容错。
物理机选型中经常把以下三个目标混在一起:
| 目标 | 实际要解决的问题 | 典型配置 |
|---|---|---|
| 运行连续性 | 某个部件失效后,业务是否还能继续运行 | 双电源、RAID、链路冗余、备用节点 |
| 维护连续性 | 更换故障部件时,是否可以不关机 | 热插拔电源、热插拔硬盘、可替换风扇 |
| 故障可见性 | 故障是否及时被发现并通知运维人员 | BMC、SEL日志、ECC告警、磁盘健康监控 |
三者并不相互等价。热插拔电源主要解决维护连续性,不能保证上游市电、PDU或主板供电模块不出问题;ECC主要增加内存错误的检测和纠正能力,并不意味着发生严重内存故障后系统一定继续运行;BMC能报告硬件告警,也不代表BMC自身故障时业务仍能维持。
因此,评价一台物理机是否存在单点故障,至少需要回答四个问题:
如果只看参数表上的“ECC、双电源、热插拔”,通常只能回答第一个问题的一部分。
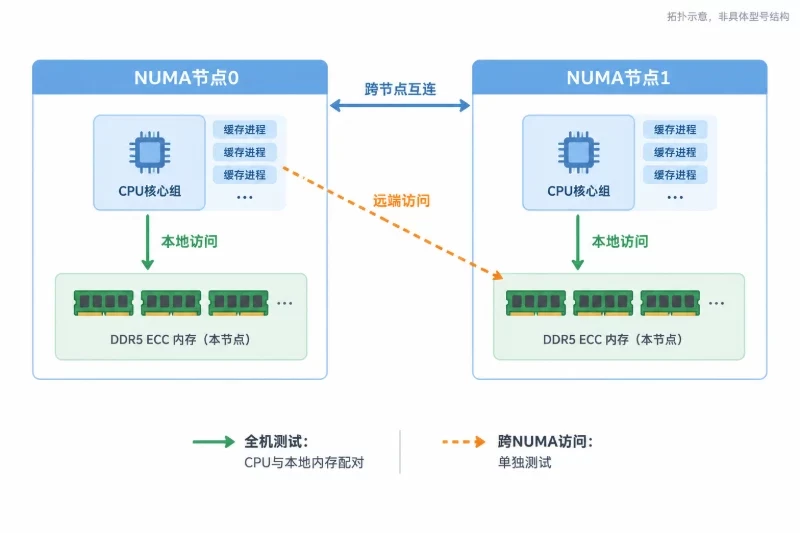
多数服务器ECC内存实现,主要针对单比特错误进行纠正,并对部分多比特错误进行检测。内存控制器、BIOS和操作系统还可以配合执行巡检、错误计数、页面隔离或故障DIMM下线。
这类机制在以下条件下更容易达到预期:
ECC的价值在于把部分随机位翻转从“静默数据损坏”变成“可纠正并可记录的事件”。但它的保护范围不是所有内存相关故障。
一台服务器安装了8根32 GB ECC DIMM,总容量256 GB。运行过程中,其中一根DIMM出现持续性错误。ECC可能先纠正一部分错误,BMC也可能记录Correctable Error,但如果该DIMM继续恶化,平台可能将其标记为不可用、触发系统异常,或者直接导致宕机。
如果业务平时已经使用了220 GB内存,即使平台能够将故障DIMM隔离,剩余容量也可能不足以维持业务。这里存在两个不同问题:
ECC解决的是第一个问题,不自动解决第二个问题。只有支持相应内存镜像、内存备用或操作系统级故障转移,并且容量预留充分时,才可能把部分DIMM故障转化为不中断事件。
如果故障来自主板DIMM插槽、内存供电、地址线、数据线或CPU内存控制器,替换内存条未必有效。双路服务器还可能出现某个CPU对应的内存通道失效,导致与该CPU相连的多根DIMM同时异常。
这类故障的表现可能包括:
此时,“内存是ECC的”并不能推出“内存子系统没有单点”。真正的单点可能是主板、CPU插槽或内存供电区域。
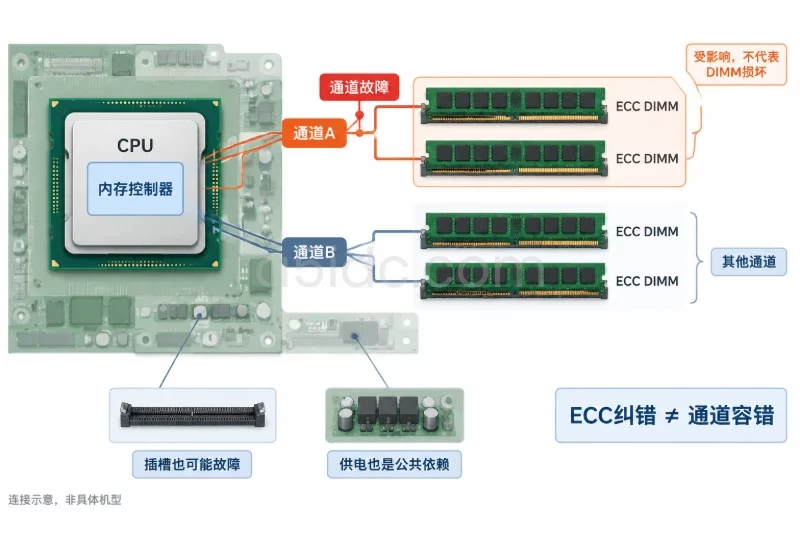
ECC纠正错误后,业务可能暂时没有中断。若监控没有采集BMC事件、内核EDAC计数或硬件管理平台告警,运维人员可能只看到“服务器仍在线”,却没有更换正在恶化的DIMM。
一段时间后,Correctable Error持续增长,最终出现不可纠正错误。此时ECC并没有失效,而是监控和备件流程没有把“可继续运行”转化为“可提前维护”。
选购或验收时,至少核对以下内容:
| 核对项 | 需要确认的内容 | 不应只看什么 |
|---|---|---|
| 内存类型 | ECC UDIMM、RDIMM、LRDIMM是否为平台支持类型 | 只看“ECC”三个字 |
| 插槽拓扑 | 推荐插法、通道对应关系、单双路CPU下的变化 | 只看总容量 |
| 降级行为 | 一根DIMM或一个通道异常后,平台如何处理 | 只看能否正常开机 |
| 错误上报 | BMC、BIOS、操作系统是否能看到可纠正和不可纠正错误 | 只看前端监控是否在线 |
| 备用机制 | 是否支持内存镜像、备用Rank或其他平台级功能 | 把ECC当成内存热备 |
| 维护条件 | 是否有同型号、同规格备件,是否需要停机更换 | 只看硬件保修年限 |
Linux系统可以使用只读方式查看硬件识别和内核记录,具体工具取决于发行版和平台:
sudo dmidecode -t memory
sudo journalctl -k | grep -Ei 'edac|ecc|mce|machine check|hardware error'
如果服务器使用BMC,也可以在维护窗口前后检查系统事件日志:
ipmitool sel list
ipmitool sdr
这些命令只能帮助确认“是否被识别和记录”,不能证明内存未来不会发生故障。更严格的验证应在业务停机窗口内运行厂商诊断或内存测试,并记录测试前后的BMC事件、操作系统日志和DIMM序列号。不要在生产负载下随意拔插非热插拔DIMM,也不要为了制造故障直接关闭正在使用的内存通道。
ECC内存适合降低随机位错误带来的静默损坏风险,尤其适合数据库、虚拟化、文件服务和长时间运行的应用。但如果业务无法接受单根DIMM、单个内存通道或主板故障造成的停机,就需要内存镜像、备用节点或应用层高可用,而不能只提高内存条规格。
服务器中的“双路电源”通常可能指:
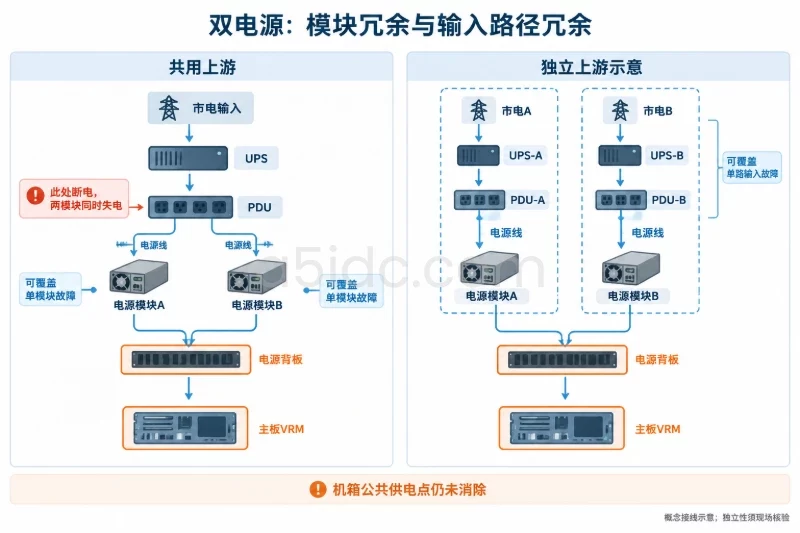
这些含义的可靠性等级并不相同。两个电源模块插在同一个PDU上,能应对单个电源模块损坏,却不能应对这个PDU断电。两个PDU接入同一台UPS,也不能覆盖UPS自身故障。两个独立输入最终经过同一块电源背板或主板供电区域时,背板仍是共同故障点。
一台服务器有两个800 W电源模块,分别接入同一个机柜PDU的两个插座。某次PDU输入侧断路器动作,两个电源模块同时失电,服务器仍然关机。
这并不说明双电源参数虚假,而是说明冗余只覆盖了“电源模块”这一层,没有覆盖“输入路径”。如果希望应对单路市电、单台UPS或单个PDU故障,两个电源模块需要接入相互独立的供电链路,并且两条链路的容量、插头、线缆、维护策略都要匹配。
仍以两个800 W电源模块为例。服务器平时直流负载约700 W,两个模块各承担约350 W。一个模块故障后,剩余模块需要承受约700 W负载。
如果额定800 W是在特定输入电压和环境温度下给出的峰值或标称值,实际可用输出可能还要考虑:
剩余模块只有100 W标称余量时,不能简单认为“800 W大于700 W,所以一定安全”。双路电源的验收重点是单模块失效后的持续运行能力,而不是双模块同时正常时的总额定功率。
热插拔电源通常通过电源背板、汇流排或中间连接器向主板、硬盘背板和风扇供电。如果故障发生在这些共同部件上,两个电源模块可能都处于正常状态,但整机依然无法上电或反复掉电。
还可能出现以下情况:
因此,电源冗余的故障边界应至少画到“市电输入、UPS、PDU、电源线、电源模块、电源背板、主板VRM”这一整条链路,而不是停在电源模块标签上。
可在维护窗口中分别设计以下测试,具体动作必须遵循服务器厂商的热插拔说明:
不要在没有备份、没有维护窗口或不清楚供电拓扑时直接拔插市电线。拔出服务器电源模块与断开上游PDU供电,验证的是两个不同故障点;两者都需要覆盖,不能用其中一个代替另一个。
一份电源验收记录可以包含以下字段:
| 项目 | 示例记录 |
|---|---|
| 正常负载 | 直流约420 W,双模块在线 |
| 单模块失效 | 剩余模块接管,业务连接保持 |
| 上游路径测试 | PDU-A断开后,PDU-B继续供电 |
| 告警状态 | BMC产生单电源故障告警,恢复后告警消除 |
| 余量检查 | 单模块接管后仍低于其在当前温度下的持续能力 |
| 未覆盖点 | 两路电源仍共用同一机柜配电柜 |
双路电源适合降低单个电源模块和部分维护操作带来的停机概率。若机房只提供一条供电链路,双电源仍有价值,但它的保护范围应明确写成“模块级冗余”,不能宣传成“机房供电冗余”。
热插拔背板可能承担:
不同机型的背板可能是被动连接板,也可能包含扩展芯片、管理芯片、信号重定时器或固件。产品资料中写“支持硬盘热插拔”,通常只说明硬盘可以在规定条件下更换,不说明背板可以在线更换,也不说明背板发生故障后硬盘仍有备用路径。
一台服务器有8块硬盘,组成RAID阵列,所有硬盘都插在同一块背板上。某个背板电源区域或信号芯片故障后,操作系统同时丢失多个磁盘。
从RAID角度看,这可能相当于一次多盘故障;从热插拔角度看,逐块更换硬盘也没有意义,因为故障不在硬盘本身。即便阵列有足够的盘级冗余,也不一定能承受整块背板或其公共连接故障。
部分SAS硬盘和背板支持双路径连接,可以把磁盘连接到两个控制器或两个HBA。但如果两条路径共享:
那么双路径可能只覆盖了控制器或线缆故障,没有覆盖背板公共部分。NVMe设备还可能依赖特定的PCIe通道划分、线缆、重定时器和固件支持,不能因为插槽外形相同就认为具备真正的双路径。
RAID可以提高单块硬盘损坏时的数据可用性,但RAID控制器、缓存模块、超级电容或电池、控制器到背板的线缆仍可能是单点。
典型场景是:四块硬盘组成具有冗余能力的阵列,但RAID卡主控故障后,所有硬盘同时无法被系统访问。若阵列元数据、缓存保护或控制器型号存在兼容限制,替换控制器也可能需要额外恢复步骤。
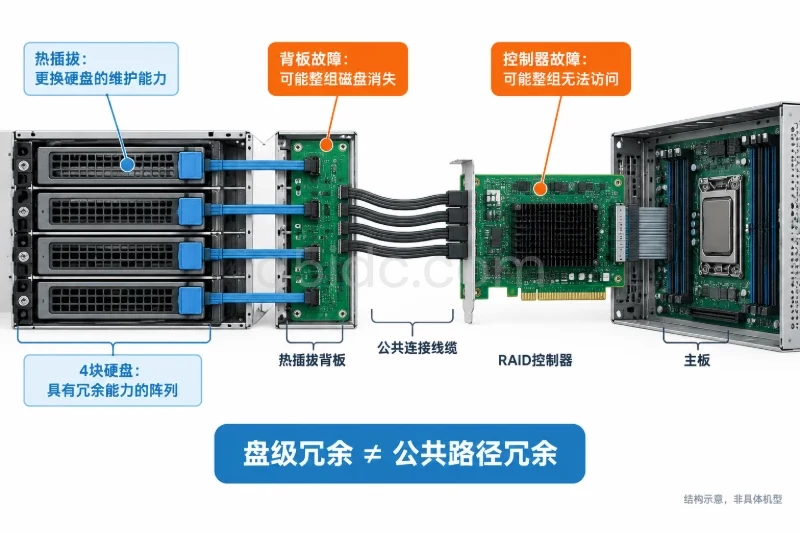
因此,判断存储可靠性时,至少要分别审查:
验收时不要只执行“拔出一块硬盘、阵列仍在线”这一项,还应核对以下内容:
| 验证对象 | 建议关注点 |
|---|---|
| 单盘热插拔 | 拔出指定盘后,阵列状态、业务I/O和告警是否符合预期 |
| 硬盘定位 | 盘位编号与系统设备名是否能准确对应,避免误拔 |
| 背板路径 | 背板是被动型、带扩展芯片,还是支持双路径 |
| 控制器 | RAID卡或HBA是否有备用方案,缓存是否有电容或电池保护 |
| 启动盘 | 系统是否依赖单块M.2、单块SATADOM或单块SSD |
| 恢复能力 | 更换背板、控制器或主板后,阵列和启动配置如何恢复 |
| 固件关系 | 背板、硬盘、控制器和主板固件是否有版本要求 |
可以先识别磁盘拓扑和控制器信息,再决定是否进行故障测试:
lsblk -o NAME,SIZE,MODEL,SERIAL,TYPE,MOUNTPOINTS
lspci -nn | grep -Ei 'raid|sas|sata|nvme|storage'
检查磁盘健康信息时,应先确认设备名称,避免把阵列虚拟盘误当成物理盘:
sudo smartctl -x /dev/sdX
/dev/sdX只是示例占位符,不能直接照抄到生产环境。对于由RAID卡接管的物理盘,系统可能无法直接通过该路径读取完整SMART信息,应使用相应控制器工具。热插拔和重建测试可能增加磁盘I/O和阵列压力,必须先确认备份可恢复,并安排可承受性能下降的窗口。
热插拔背板适合缩短硬盘更换的维护时间,不能单独承担“存储高可用”。如果背板、控制器或启动介质仍是单点,关键业务还需要备用节点、异机复制或其他独立恢复路径。
ECC、双电源和热插拔背板覆盖的是局部故障。以下部件常常不在“可靠性参数”第一眼的位置,却可能决定整机是否继续运行。
大多数单机服务器只有一块主板。即使配置双路CPU,也不等于两颗CPU可以像两个独立节点一样互相接管。主板芯片组、时钟、固件、PCIe根复合体、内存供电和CPU插槽发生故障时,整机可能停止服务。
双路CPU的主要价值通常是计算资源和内存通道扩展,而不是透明故障转移。采购时要区分:
服务器可能配备多个风扇,但要确认是N+1容错还是仅仅提高风量。单个风扇故障后,系统可能继续运行;如果风扇控制板、公共供电或风道中的关键风扇故障,剩余风扇未必能维持温度。
散热问题还可能在电源模块故障后被放大。一个电源模块失效,剩余模块负载增加;风扇高速运行,功耗和噪声上升;机房进风温度偏高时,系统可能降频或触发保护关机。因而电源冗余测试不能只观察“机器有没有立刻关机”,还要观察温度、频率、风扇转速和告警。
双网口不必然等于双网络路径。两个网口可能:
如果要覆盖网卡芯片故障,通常需要独立的网卡或独立PCIe路径;如果要覆盖交换机故障,还需要连接不同交换设备。链路聚合能够改善链路可用性,但不能自动消除服务器端控制器、驱动、交换机或上游路由的共同故障。
数据盘做了RAID,系统却安装在单块M.2或单块SSD上,是很常见的隐性单点。启动盘损坏后,数据阵列可能仍然完整,但服务器无法正常启动。
还要注意以下配置是否只保存在本机:
硬件冗余只能保护部分物理部件,不能替代系统配置备份和可重复部署能力。
BMC故障通常不一定立即影响业务进程,但会影响远程开关机、串口控制台、硬件告警和故障定位。对托管在异地机房的服务器而言,BMC不可用可能意味着必须安排现场操作,延长维修时间。
因此,BMC更适合被视为“可观测性和可维护性单点”。需要确认:
可以把一台物理机拆成几层故障域:
| 层级 | 典型部件 | 需要验证的边界 |
|---|---|---|
| 机房输入 | 市电、UPS、PDU、电源线 | 两路是否真正独立 |
| 机箱供电 | 电源模块、电源背板、主板VRM | 单模块失效后是否有容量余量 |
| 计算与内存 | CPU、DIMM、插槽、主板 | 单条、单通道、单CPU故障如何处理 |
| 存储路径 | 硬盘、背板、RAID卡、线缆 | 单盘故障与公共路径故障是否区分 |
| 网络路径 | 网卡、PCIe、网线、交换机 | 双口是否跨控制器和交换设备 |
| 管理路径 | BMC、管理交换机、远程控制 | BMC失效后是否仍可维护 |
| 软件与配置 | BIOS、驱动、阵列配置、启动盘 | 更换主板或控制器后能否恢复 |
这里的“独立”不能只看物理位置。两个电源模块并排安装,位置不同但可能共享同一背板;两根网线分别插在两个端口,端口却可能属于同一颗网卡;两块SSD分别属于不同盘位,背后却连接到同一块背板。
一个实用的判断方式是:对每个部件提出“如果它整体消失,业务是否还能继续”的问题。如果答案是否定的,再追问“是否有独立备用路径”。如果仍然没有,就应将该部件列入单点清单,而不是被其他冗余参数抵消。
物理机到货验收通常会检查型号、序列号、内存容量和硬盘数量,但可靠性还需要进行故障边界验证。以下是一份可按业务重要性裁剪的示例清单:
| 验收项 | 操作方向 | 观察结果 |
|---|---|---|
| 配置一致性 | 核对CPU、DIMM、盘位、控制器、电源模块和固件版本 | 与订单和确认BOM一致 |
| 内存识别 | 查看BIOS、BMC和操作系统识别结果 | 容量、通道、频率和纠错能力符合预期 |
| 电源切换 | 在维护窗口模拟单模块或单路输入失效 | 业务保持,BMC产生明确告警 |
| 盘级容错 | 按厂商流程移除一块硬盘 | 阵列进入降级,业务仍可访问 |
| 路径确认 | 核对硬盘、控制器、背板和线缆连接 | 不存在未登记的公共连接点 |
| 网络冗余 | 断开单条网线或单个网络端口 | 连接切换,丢包和恢复时间可接受 |
| 告警闭环 | 触发并恢复一项可控硬件告警 | 监控平台收到、确认并关闭事件 |
| 配置恢复 | 备份BMC、RAID、BIOS和系统配置 | 更换关键部件后有恢复依据 |
| 备件和服务 | 确认DIMM、硬盘、电源、风扇和控制器的替换周期 | 故障后不会只剩返厂等待 |
验收标准应与业务目标绑定。例如,单电源故障后的业务恢复时间、磁盘降级期间允许的性能下降、BMC失联后的现场响应时间,都应该提前写清楚。否则即使服务器顺利通过“拔一块硬盘”的测试,也很难判断它是否满足实际SLA。
对于不能在线制造的故障,不要为了追求“全链路演练”而直接破坏生产环境。内存条、主板、背板、CPU和非热插拔网卡通常应采用离线备件、厂商诊断或实验机验证。生产环境更适合验证可控的电源切换、单盘热插拔、单链路断开和告警闭环。
如果业务只是普通网站、开发环境、临时计算节点或可以接受计划停机的内部系统,ECC、双电源和热插拔背板通常已经能够显著降低常见硬件故障带来的维护成本。此时重点是配置正确、告警有效、备件可获得,并且备份能够恢复。
如果业务要求单台服务器主板、背板或整机故障时仍然提供服务,那么单机堆叠更多冗余配件通常会遇到成本和复杂度上升的问题。更合适的方向可能是:
这并不是说物理机上的冗余配置没有意义,而是要让每项配置对应明确的故障范围。ECC主要降低部分内存错误风险,双路电源主要降低电源模块和部分维护操作风险,热插拔背板主要缩短硬盘维护时间。它们共同提高的是局部可靠性和可维护性,并不能自动覆盖主板、背板、控制器、启动盘、网络上联和机房供电等共同故障点。
选型时,只有在确认故障域彼此独立、单点故障后的剩余容量足够、告警能够闭环、备件和恢复流程可执行的前提下,ECC内存、双路电源与热插拔背板才会从“参数配置”真正转化为可验证的可靠性能力。