香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


DDR5-5600 ECC服务器上的“缓存吞吐上限”通常由三部分共同决定:LLC缓存容量与带宽、内存子系统持续带宽,以及Redis、Memcached等缓存服务的单线程处理能力。5600 MT/s只代表内存接口速率,不能直接换算成每秒可处理多少缓存请求;高并发下,连接数、流水线、数据集大小、NUMA分布甚至客户端能力,都可能让请求数先于内存达到上限。
一次可用于选型或验收的测试,应在目标美国区域、目标云主机或裸金属实例上完成,并同时记录硬件拓扑、并发阶梯、延迟分位数、缓存命中、CPU、内存带宽和I/O状态。下面把测试拆成可复现的方法,并给出结果解释与复测条件。文中带宽计算、阈值和模拟表均为方法示例,不代表某一服务器实例的实测结论。
“缓存吞吐”容易混合四个不同问题:
| 测试目标 | 主要回答的问题 | 典型指标 |
|---|---|---|
| LLC驻留能力 | 热数据能否留在CPU缓存中 | 随机读取吞吐、平均延迟、p99、容量拐点 |
| 内存持续带宽 | 缓存未命中后,内存能提供多少数据吞吐 | 单核及全通道读、写、Triad带宽 |
| 缓存服务处理能力 | Redis或Memcached每秒能处理多少请求 | ops/s、连接数、CPU利用率、延迟 |
| 分布式缓存网络能力 | 多节点、跨可用区时是否受网络限制 | 跨节点吞吐、往返时延、PPS、丢包 |
如果业务使用Redis、Memcached或其他常驻内存缓存,“缓存命中率”必须与请求吞吐一起看。命中率很高但工作集已经超过LLC,仍然可能从内存读取;反过来,低命中率也不必然很慢,独立随机请求可以依靠内存级并行隐藏部分访问延迟。
测试前应固定以下前置条件:
DDR5-5600中的5600表示每秒5600百万次内存传输。若一个64位内存通道在理想状态下每次传输64 bit,其理论带宽为:
5600 × 64 ÷ 8 = 44,800 MB/s = 44.8 GB/s
这是十进制换算。8通道理论值为358.4 GB/s,12通道为537.6 GB/s。它只是控制器峰值,不能作为可交付给业务的吞吐承诺。ECC启用后的实际表现还受CPU内存控制器、DIMM组织、训练、读写混合和平台降频机制影响;同一标称频率下,8条单rank DIMM与满插多rank DIMM也可能得到不同结果。
缓存服务的核心指标通常是ops/s,但只看平均数会掩盖排队。以下数据应同时保留:
若并发从32增加到64,吞吐只增加5%,但p99增加40%,64已经不是有效扩容点。判断并发拐点时,可以计算相邻阶梯的边际增益:
边际吞吐增益 =(新并发吞吐-原并发吞吐)÷ 原并发吞吐
将“增益已接近零但延迟明显恶化”的第一个并发点作为候选上限,再结合业务SLO确认。没有明确延迟SLO时,不应仅按最大ops/s配置生产容量。
不同CPU代际的L1、L2和LLC结构差别很大,同一CPU在不同配置下可用缓存也可能变化。测试应逐步扩大每条NUMA节点共享的数据集,而不是直接套用规格表中的缓存大小。
如果工作集从16 MiB增加到32 MiB时吞吐保持稳定,继续扩大后仍无明显变化,LLC可能不是限制;一旦工作集超过某个区间后吞吐下降、延迟上升,才出现容量拐点。拐点附近还应检查:
通用缓存事件在虚拟化平台或不同微架构上可能含义不同。应先执行以下命令确认事件可用:
perf list
只有确认目标CPU支持时,再采集:
perf stat -e cycles,instructions,cache-references,cache-misses,context-switches,cpu-migrations sleep 60
若事件不受支持,可以使用perf c2c、厂商性能监控工具或应用自身遥测替代,不能把缺失事件填成0。
持续顺序访问通常能较充分地使用内存通道;随机读、随机写和读写混合的利用率不同。推荐至少测试三类负载:
| 负载 | 作用 | 解释重点 |
|---|---|---|
| 顺序Triad | 估算整体内存通道能力 | 与理论带宽比较,但不直接等于缓存ops/s |
| 独立4 KiB随机读 | 模拟缓存未命中后的取数路径 | 吞吐、尾延迟、NUMA和队列深度 |
| 混合读写 | 模拟真实缓存更新 | 写放大、内存控制器压力、持久化影响 |
对顺序带宽,可用峰值带宽作粗略核对。内存通道效率达到理论值80%~90%通常属于值得继续检查的量级,但这是宽泛参考,不是合格线。低于该范围应先排除频率降档、NUMA错误绑定、编译器优化、线程不足和不完整通道配置;高于该范围则要检查单位、编译参数以及是否只使用了部分内存。
Redis经典单线程模型中,一个核心接近100%并不罕见。此时即使DRAM带宽只用了30%,缓存服务也可能已经达到单核执行上限,继续增加连接只会增加排队。
磁盘I/O不属于热缓存请求的主路径,但以下状态仍会干扰压测:
因此需要同时采集iowait、缺页、上下文切换、迁移次数和持久化事件。不能因为iowait很低就断言“与I/O无关”,还要确认缓存数据已经驻留内存,且测试文件或键空间没有产生意外读盘。
在Ubuntu或Debian系统中,可先收集以下信息:
uname -a
cat /etc/os-release
lscpu
lscpu -e=CPU,CORE,SOCKET,NODE,ONLINE
numactl --hardware
free -h
使用具备权限的账号查看DIMM与ECC信息:
sudo dmidecode -t memory
sudo lshw -class memory
建议建立如下环境表:
| 类别 | 必须记录的项目 |
|---|---|
| 实例 | 云厂商、区域、可用区、实例规格、是否独享CPU |
| CPU | 型号、插槽数、物理核数、线程数、NUMA节点数 |
| 固件 | BIOS版本、微码版本、内存频率策略 |
| 内存 | 总容量、条数、DIMM类型、rank、通道分布、每通道速率 |
| 操作系统 | 发行版、内核、容器或cgroup限制 |
| 缓存软件 | 名称、版本、线程数、淘汰策略、持久化配置 |
| 客户端 | 位置、CPU、连接数、pipeline、客户端版本 |
“支持DDR5-5600”不代表当前实例一定以5600 MT/s运行。应同时记录标称速度和Configured Memory Speed;如果平台因DIMM组织、温度或功耗策略自动降频,测试结论必须按实际频率解释。
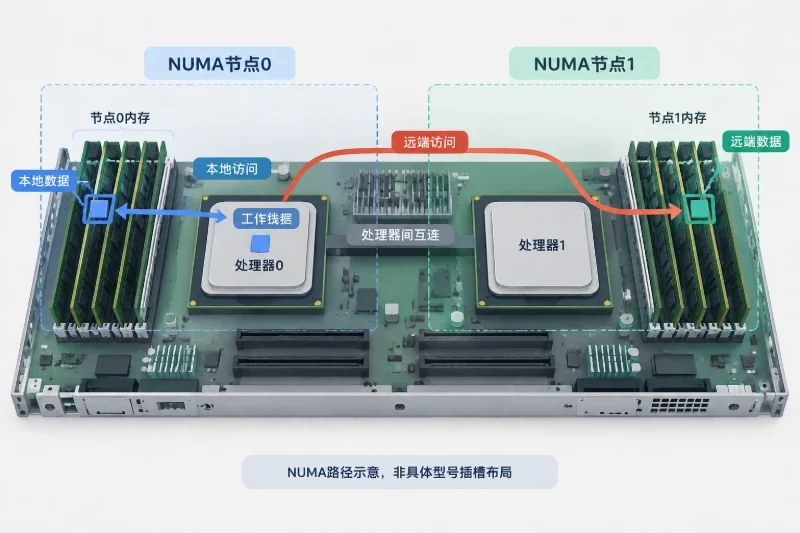
单路和双路服务器应分别测试。以下示例将进程固定到NUMA节点0:
numactl --cpunodebind=0 --membind=0 your-benchmark-command
多路或双路全机测试应让CPU与本地内存成对使用。业务如果跨节点均匀分散,也应另设“跨NUMA访问”场景,不能把远端访问损失归咎于DDR5频率。
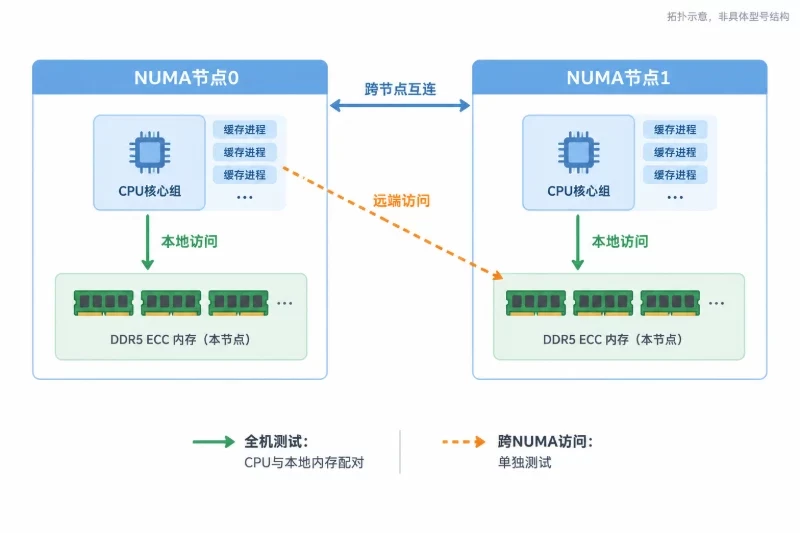
CPU线程数也要分两组:
不能把SMT线程当作完整物理核心做容量规划。
建议将压测环境与生产环境分成两轮:
受控结果只能说明理论处理能力。若正式业务要求持久化或故障转移,就必须使用第二轮结果决策。不能在生产实例上临时关闭持久化、内存限制或安全机制后,将结果直接当作生产承诺。
随机指针访问比顺序复制更容易暴露LLC容量和跨核访问成本。Debian或Ubuntu可安装sysbench:
sudo apt update
sudo apt install sysbench
先确认版本和参数:
sysbench --version
sysbench memory --help
下面把总工作集按线程数分摊。示例测试集为32、64、128、256 MiB,并发从1逐步增加到32。--table-size单位为MiB,每个线程各有一张表,因此总工作集近似为“单线程大小乘线程数”:
CPUSET="0-15"
WORKING_SET_MIB="32 64 128 256"
THREADS="1 2 4 8 16 32"

for total in $WORKING_SET_MIB; do
    for threads in $THREADS; do
        per_thread=$((total / threads))
        if [ "$per_thread" -lt 1 ]; then
            continue
        fi

        taskset -c "$CPUSET" sysbench \
            --threads="$threads" \
            --time=60 \
            --events=0 \
            --percentile=99 \
            memory \
            --table-size="$per_thread" \
            --memory-oper=read \
            run
    done
done
解释结果时必须区分两种矩阵:
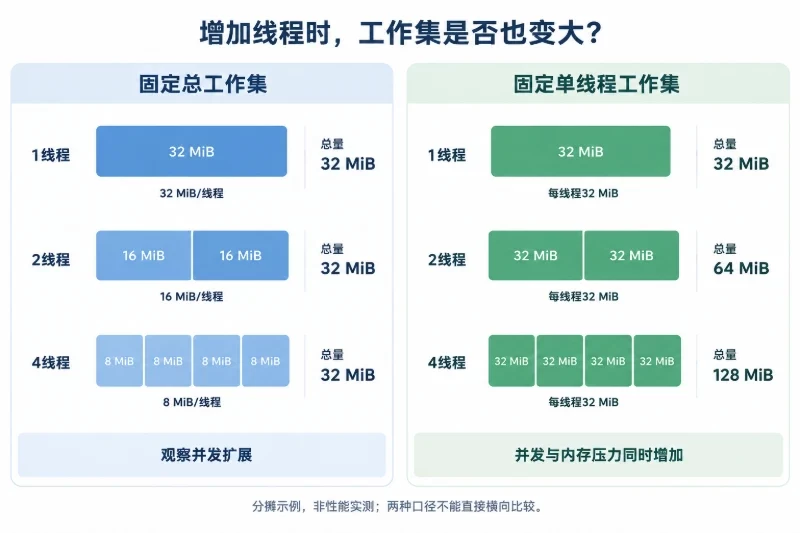
如果32 MiB总工作集时8线程吞吐很高,而64 MiB后明显下降,应先检查LLC容量和TLB,而不是立即认定内存带宽不足。
可使用硬件厂商或STREAM项目提供的版本,并记录编译器、NUMA线程数和编译参数。典型运行方式如下,路径和二进制名需替换为实际文件:
export OMP_NUM_THREADS=16
cd /opt/stream
./stream_c.exe
建议分别执行:
若只测一个线程,不能代表全通道上限;若线程跨NUMA节点分配,也可能把远端访问限制误判为内存不足。每次结果都应保留原始数值、单位和二进制版本。
测试期间可在另一终端每秒采样:
mpstat -P ALL 1
pidstat -u -r -d 1
vmstat 1
多路服务器还应按进程查看NUMA分布:
numastat -p PID
若安装并支持sysstat,可记录更长时间的CPU和网络趋势:
sar -u 1 60
sar -r 1 60
sar -n DEV 1 60
采集结束后保存原始文件,不要只抄录峰值。峰值瞬时值容易与短暂任务、采样抖动或其他实例活动混在一起。
先检查客户端参数,不同Redis发行版的输出可能略有差异:
redis-benchmark --help
测试应使用独立实例或已确认不会影响业务数据的测试环境。以本机GET、SET为例,常见测试方式如下:
for connections in 1 8 16 32 64 128; do
    redis-benchmark \
        -h 127.0.0.1 \
        -p 6380 \
        --threads 1 \
        -t set,get \
        -n 100000 \
        -c "$connections" \
        -d 1024 \
        -P 1 \
        --csv
done
这里的-P 1表示不使用流水线,便于建立基准。找到并发拐点后,再分别测试-P 8和-P 32。高pipeline能够提高网络利用率,但会改变服务端命令可见的请求节奏,不能把pipeline下的ops/s与单命令p99直接比较。
建议按以下阶段执行:
服务端状态可使用:
redis-cli -h 127.0.0.1 -p 6380 INFO
redis-cli -h 127.0.0.1 -p 6380 INFO memory
redis-cli -h 127.0.0.1 -p 6380 INFO commandstats
不要在生产数据库上执行FLUSHDB、FLUSHALL或其他清理命令来准备压测数据集。应通过独立实例、隔离端口和明确的测试配置完成准备。
Redis单线程服务即使主线程未满,也可能被慢命令、网络系统调用、持久化或碎片整理影响。判断单核限制前,应同时检查:
used_cpu_sys和used_cpu_user;先确认服务端口、线程数和工作集:
printf 'stats settings\n' | nc 127.0.0.1 11211
printf 'stats slabs\n' | nc 127.0.0.1 11211
若安装了libmemcached-tools,可使用:
memcstat --servers=127.0.0.1
命中率应按测试窗口内的增量计算:
GET命中率 = get_hits增量 ÷(get_hits增量 + get_misses增量)
不要直接使用服务启动以来的累计命中率。吞吐也应使用cmd_get、cmd_set等计数器的增量除以实际秒数。
若实例启用了多线程,还应确认负载是否真正分配到全部worker。可逐个提高连接数,观察总吞吐和各线程CPU。如果线程数已配置但吞吐不随线程增加,通常需要检查连接分布、锁竞争、CPU频率和客户端限制。
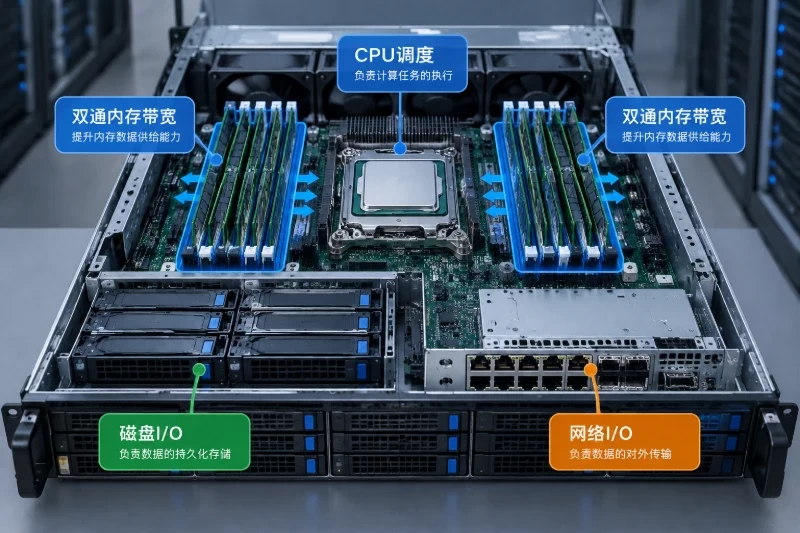
内存带宽首先受实际启用的通道数影响。理论上,8通道DDR5-5600的峰值是358.4 GB/s;如果只启用4通道,理论值只有179.2 GB/s。满插DIMM也不等于多通道,两个DIMM可能分布在同一通道的两个内存位置,并不一定带来线性增益。
还应检查:
小工作集可能由L2甚至L1吸收,此时增加DDR5通道数不会明显提升请求吞吐。工作集超过LLC后,内存带宽才开始主导。顺序访问、随机访问和依赖型指针跳转也可能得到不同结果。
真实缓存数据还包含键、对象元数据、指针、分配器碎片和过期项。不能只按“键数量乘平均值”估算内存,更可靠的方法是用业务镜像数据集测出稳定期的used_memory或进程RSS。
更多连接只有在服务端、网络和客户端都有剩余处理能力时才会增加吞吐。出现以下情况时,应把问题归到对应层:
SMT可能提高独立请求的吞吐,却可能增加共享缓存和执行资源的竞争。测试时CPU频率如果在1.7~3.x GHz之间明显变化,平均ops/s就不能与另一轮直接比较。
可在支持的Intel平台上观察频率和功耗:
sudo turbostat --interval 1
cpupower frequency-info可用于确认频率策略,但修改governor前要记录原值。受控测试可以统一频率策略,生产验收则应保留服务器实际调度策略。测试后应恢复原配置,并让服务器冷却到相近起始温度再进行下一轮。
云主机上的“16 vCPU”可能与16个独立物理核不是同一回事。虚拟机还可能受到以下因素影响:
若同一规格的多台实例结果差异明显,应优先比较宿主机与邻居干扰,而不是只增加客户端并发。
下面是一组用于说明读法的假设数据,并非任何A5IDC服务器或客户环境的实测结果。示例假设为双路、每路8通道DDR5-5600,理论总带宽为716.8 GB/s。
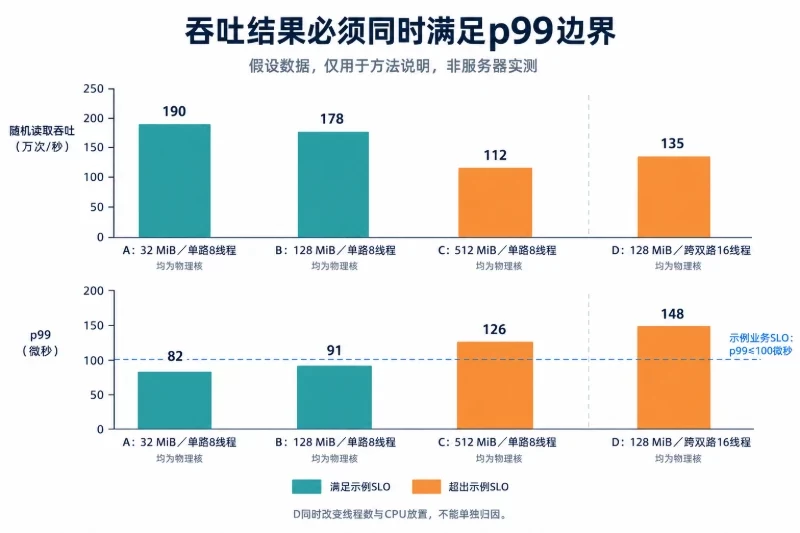
| 数据集 | CPU放置 | 线程数 | 随机读取吞吐 | p99延迟 | 假设解释 |
|---|---|---|---|---|---|
| 32 MiB | 单路物理核 | 8 | 190万次/秒 | 82微秒 | 大部分访问可能被较深层缓存吸收 |
| 128 MiB | 单路物理核 | 8 | 178万次/秒 | 91微秒 | 缓存压力增加,但仍有较高内存并行度 |
| 512 MiB | 单路物理核 | 8 | 112万次/秒 | 126微秒 | 工作集扩大后,内存与TLB影响增强 |
| 128 MiB | 跨双路物理核 | 16 | 135万次/秒 | 148微秒 | 可能出现远端NUMA访问或跨套接字一致性成本 |
如果业务要求p99不高于100微秒,那么第三、第四种状态即使平均吞吐更高,也不满足容量要求。应减少单实例工作集、增加实例分片,或选择缓存层级和NUMA放置更合适的配置,而不是继续提高连接数。
| 观察结果 | 更可能的边界 | 处理方向 |
|---|---|---|
| 吞吐随并发快速增加,CPU和内存均有余量 | 尚未达到上限 | 继续逐级增加并发 |
| 吞吐接近平台后,延迟快速上升 | 服务端处理或排队已饱和 | 确认单核、锁、客户端瓶颈 |
| 一个核心满载,其他核心和内存较空 | 单线程执行上限 | 评估分片或并发缓存架构 |
| LLC未命中增多,但DRAM远未用满 | TLB、依赖访问或软件路径限制 | 检查工作集、页大小和访问模式 |
| DRAM接近持续带宽,缓存ops/s同步趋平 | 内存带宽限制 | 减少数据搬移或扩展节点 |
| CPU和内存都较低,NIC吞吐或重传升高 | 网络限制 | 优化连接分布、实例位置或分片 |
| 命中率稳定下降,evicted_keys持续增长 | 容量不足 | 扩容或缩短数据生命周期 |
| 双路跨节点测试明显慢于单路本地测试 | NUMA或跨套接字访问 | 固定CPU与内存配对、重新分片 |
| 吞吐正常但p99间歇升高 | 持久化、GC、日志或宿主机抖动 | 按时间线关联服务端与宿主机指标 |
“内存使用率低”不能单独证明容量足够。进程可能因为缓存未命中、随机指针访问、锁等待或网络等待而无法继续提高吞吐。反过来,内存使用率高也不必然错误;缓存服务本就需要用驻留内存换取低延迟,关键是命中率、延迟和错误率是否仍在目标范围内。
ECC计数应作为独立质量指标采集。Linux下可先检查内核日志:
journalctl -k -b | grep -Ei 'edac|cec|mce|ecc'
系统安装并配置了rasdaemon时,可使用:
sudo ras-mc-ctl --errors
处理原则如下:
如果服务器因内存纠错、训练重试或降频出现周期性性能波动,应把降频时间线与吞吐、p99和温度对齐。随机抽取一个平均吞吐值会完全掩盖这种问题。
满足以下任一条件时,仅增加连接数通常不能解决问题:
成本评估也应按瓶颈选择变量:
推荐把业务数据集压到候选配置预估工作集的60%~70%以内作为评估起点,而不是把它当成固定合格线。生产阶段还要为连接、临时对象、持久化、复制和故障切换保留余量。若启用了写时复制式快照或进程复制,应单独评估瞬时内存峰值;峰值可能明显高于稳定期的used_memory。
首次测试完成后,至少每30~60分钟在相近温度下重复5次,保留全部原始结果和异常值。正式复测应触发以下任一变化:
报告时至少给出“中位数、最好值、最差值、p95、p99和持续时间”,不能只公布单轮最高ops/s。可用以下容量判断顺序:
真正可用于部署决策的“缓存吞吐上限”,应是在目标工作集、真实请求分布和业务延迟边界下能够持续运行的结果,而不是一次瞬时最高值。