香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


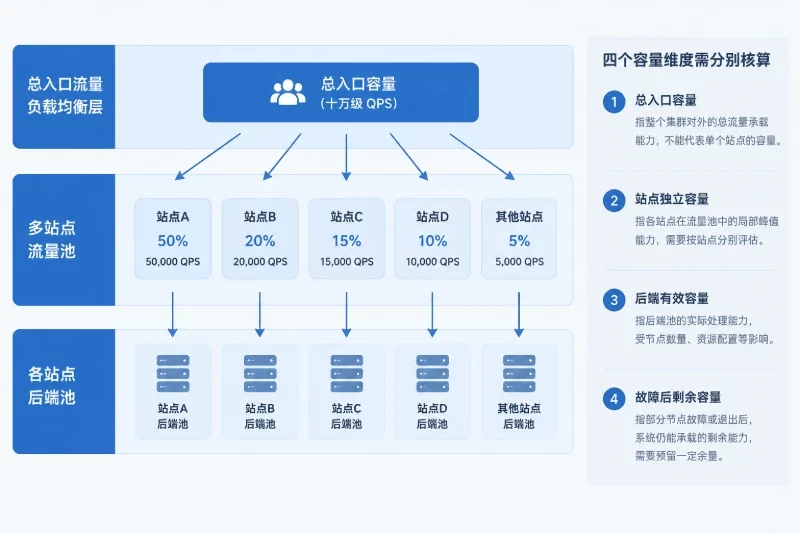
十万级 QPS 下,单独增加几台香港服务器并不能自动消除单点故障。真正有效的多站点集群香港服务器负载均衡方案,应当同时消除入口负载均衡器、健康检查、应用节点、会话存储、数据库主节点、配置中心和故障切换流程中的单点,并确保任一故障域退出后,剩余容量仍能承接峰值流量。
排查时应由外到内进行:先确认域名解析和公网入口,再检查负载均衡是否正确摘除故障节点,随后判断应用节点是否过载,最后检查缓存、数据库、消息队列和复制状态。不要一开始就提升数据库规格或手工切换主库,否则可能掩盖真正的入口故障,甚至在复制未完成时造成双主和数据分叉。
多站点集群通常包含多个业务域名或站点,每个站点又可能拥有独立的应用池。设计之前需要把“单点故障”具体化,而不是笼统地写成“服务器故障”。
至少需要明确以下故障边界:
可以把资产、故障影响和恢复目标记录成一张表,避免只关注服务器数量。
| 资产层级 | 常见单点 | 需要达到的目标 |
|---|---|---|
| DNS与公网入口 | 单一解析地址、单一健康检查服务 | 一个解析或入口路径失效时,仍能引流到可用路径 |
| 负载均衡 | 单台L4/L7节点、单一VIP、配置不一致 | 单节点故障时自动摘除,连接逐步排空 |
| 应用层 | 单站点只有一个实例、进程内保存会话 | 任一实例退出后,站点仍能提供核心功能 |
| 缓存与会话 | 单实例缓存、会话只保存在本机内存 | 缓存失效不造成全站中断,会话可恢复或重新建立 |
| 数据库 | 单主库、无可验证复制、无防脑裂机制 | 主节点故障时按一致性策略切换,避免双写 |
| 配置与证书 | 只保存在某台服务器或人工操作 | 新节点可以从受控版本恢复,配置变更可审计 |
| 监控与切换 | 监控和故障入口共用同一依赖 | 监控失效不能阻止人工或自动恢复 |
对于十万级 QPS,不能只按正常状态下的平均负载规划。更有意义的目标是:
任一故障域退出后,剩余集群的稳定处理能力仍应不低于峰值 QPS 加安全余量。
如果业务峰值按 100,000 QPS 估算,安全余量取 20%,则故障后的目标处理能力至少为:
100,000 × 1.20 = 120,000 QPS
如果使用两个相互独立的故障域,并且要求其中一个完全退出,那么每个故障域在稳定状态下都应具备约 120,000 QPS 的安全处理能力。两边同时在线时,正常流量可以各承担约 50,000 QPS,单侧利用率不会接近极限。
这里的“稳定处理能力”不能直接采用压测中的最高瞬时 QPS,应同时考虑:
例如,100,000 QPS 下,如果平均响应体为 20 KB,仅计算业务响应流量,吞吐量约为:
20 KB × 100,000 次/秒 = 2,000,000 KB/秒
2,000,000 KB/秒 ÷ 1,000,000 KB/GB × 8 = 16 Gbps
这还没有包含请求体、TCP/IP、TLS和重传开销。因此,QPS容量和网络吞吐量必须分别测量,不能用其中一个指标代替另一个。
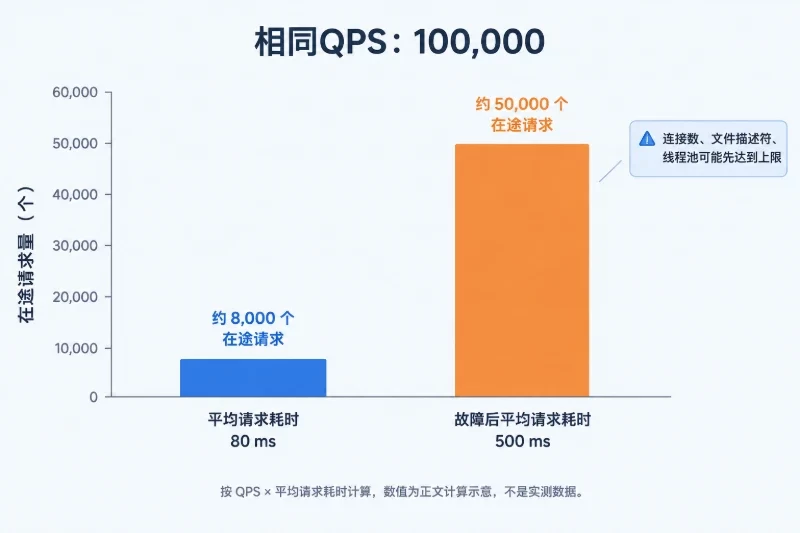
并发连接也需要估算。若平均请求耗时为 80 ms,则平均在途请求量约为:
100,000 × 0.08 = 8,000 个请求
如果故障导致延迟升高到 500 ms,在相同 QPS 下在途请求量可能增加到约 50,000 个。负载均衡器和应用节点即使 CPU 尚未打满,也可能先因为连接数、文件描述符或线程池耗尽而拒绝新请求。
恢复目标需要分层定义,而不是只写一个“高可用”。
可以使用以下数值作为初始规划参考,最终以实际压测和演练结果为准:
| 故障类型 | 参考RTO目标 | RPO重点 |
|---|---|---|
| 单台负载均衡节点故障 | 30秒以内 | 通常不涉及业务数据 |
| 单个应用节点故障 | 30秒以内 | 无状态服务通常为0 |
| 一个故障域退出 | 1至5分钟 | 取决于数据库复制方式 |
| 数据库主节点故障 | 1至数分钟 | 强一致业务应尽量接近0,异步复制需接受复制延迟 |
| 缓存集群失效 | 1至数分钟内降级 | 缓存通常可重建,会话需单独定义 |
| 配置或证书发布错误 | 10至30分钟内回滚 | 以最后一个可验证版本为准 |
一个可执行的架构可以分为两套入口平面,每套平面至少包含两台负载均衡节点:
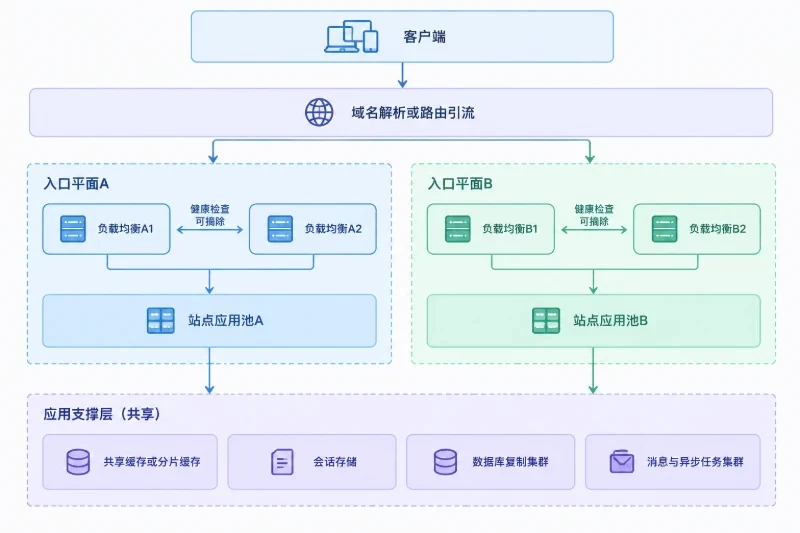
客户端
   │
   ├── 域名解析或路由引流
   │
   ├── 入口平面A
   │      ├── 负载均衡A1
   │      └── 负载均衡A2
   │              └── 站点应用池A
   │
   └── 入口平面B
          ├── 负载均衡B1
          └── 负载均衡B2
                  └── 站点应用池B

        应用层
           ├── 共享缓存或分片缓存
           ├── 会话存储
           ├── 数据库复制集群
           └── 消息与异步任务集群
入口层有三种常见组织方式:
适合解决单台负载均衡器故障,但浮动VIP通常只能覆盖同一网络故障域,无法解决整个机房或上游网络不可用。
实现简单,适合多个站点分别配置。缺点是递归DNS缓存和TTL会影响切换速度,健康状态变化不一定立即传递到所有客户端。
可以缩短部分切换时间,但路由控制、健康探测和上游网络本身也需要冗余,不能把它当作天然可靠的单一解决方案。
无论采用哪一种方式,都不要让健康检查服务和负载均衡器共用同一故障点。入口健康检查至少应从独立监控路径发起,并分别检查:
负载均衡节点应尽量保持无状态,避免依赖本机保存的会话或临时配置。重点包括:
存活检查只回答“进程是否存在”,就绪检查则回答“该节点是否可以接收业务流量”。如果所有健康检查都只返回固定的 HTTP 200,进程虽然还活着,但数据库连接池已经耗尽时,负载均衡仍会持续向它发送请求。
健康检查也不能过度依赖数据库。一个深度检查同时访问多个依赖,可能在数据库短暂抖动时让所有应用节点一起被摘除,形成级联故障。更稳妥的做法是分层判断:
/live:进程和基础线程仍可运行;/ready:应用可以接受指定类型的请求;多站点集群不能让一个大流量站点拖垮全部站点。每个站点建议拥有独立的:
会话不能只保存在单台应用服务器的内存中。可选方式包括:
请求重试尤其需要谨慎。GET等幂等请求可以在部分网络错误下重试,但支付、库存扣减、订单创建等写操作不能仅因为连接超时就直接转发到另一节点,否则可能形成重复提交。即使客户端没有收到响应,也不能简单推断服务端没有执行。
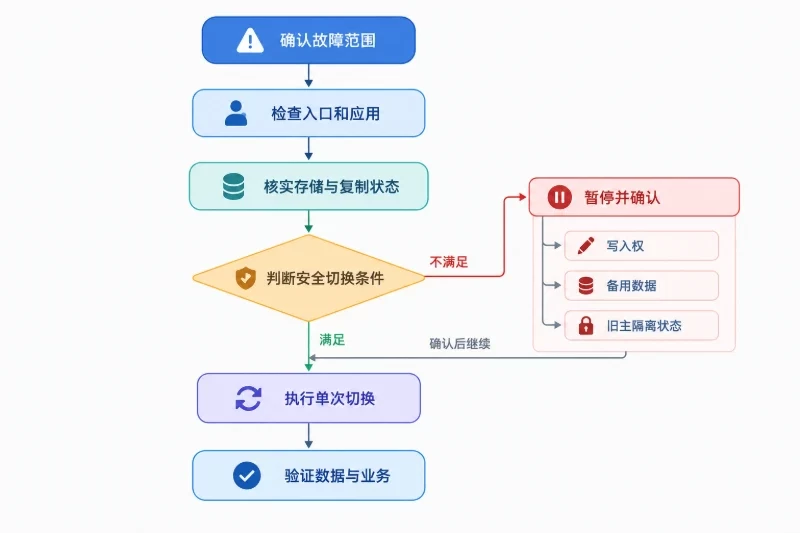
数据库高可用的核心不只是“有一个副本”,而是明确副本什么时候能被提升为新的写入节点。
| 数据类型 | 典型一致性要求 | 适合的处理方式 |
|---|---|---|
| 站点配置、静态元数据 | 较强一致 | 版本化发布,确认复制完成后启用 |
| 订单、库存、账务 | 强一致或严格顺序 | 单写者、仲裁或同步确认,切换前进行防脑裂 |
| 登录会话 | 可恢复即可 | 复制会话存储,或使用无状态会话 |
| 页面缓存、推荐结果 | 可最终一致 | 缓存失效后重建,避免把缓存当作唯一数据源 |
| 日志、统计、异步任务 | 可接受一定延迟 | 异步复制、事件ID、重复消费检测 |
同步复制可以降低已确认数据丢失的可能,但会把跨故障域网络延迟和网络分区风险带入写入路径。异步复制通常有更低的写入延迟,却必须接受复制延迟带来的RPO。
在执行数据库切换前,至少要确认:
在无法确认旧主节点已经隔离时,不应直接提升新主节点。强行提升可能导致两个节点同时接受写入,后续即使重新同步,也无法自动判断哪一条记录是正确的。
| 失效场景 | 触发条件 | 常见表现 | 预防措施 |
|---|---|---|---|
| 单台负载均衡器故障 | 进程退出、网卡异常、配置加载失败 | 部分连接超时,另一节点流量突然升高 | 双节点入口、主动健康检查、连接排空 |
| 配置不一致 | 人工修改单节点配置、证书未同步 | 相同域名在不同入口返回不同结果 | 配置版本化、发布前差异检查、自动回滚 |
| 一个故障域退出 | 上游网络或整组节点不可用 | 一批IP或节点同时超时 | 另一故障域保留峰值容量和独立入口 |
| 站点流量突增 | 突发热点、爬虫、客户端重试 | 单站点占满连接池,其他站点变慢 | 按站点限流、连接池隔离、降级静态功能 |
| 数据库复制延迟 | 网络抖动、写入突增、长事务 | 读到旧数据,切换后出现数据缺口 | 复制延迟告警、切换门槛、写入幂等 |
| 缓存整体失效 | 集群重启、热Key集中失效 | 数据库QPS瞬间上涨,应用延迟升高 | 缓存预热、回源限速、热点拆分 |
| 重试风暴 | 超时后客户端和网关同时重试 | QPS异常放大,5xx继续增加 | 限制重试次数、指数退避、只重试幂等请求 |
| DNS切换不及时 | TTL缓存、健康检查延迟 | 部分客户端仍访问旧入口 | 降低合理TTL、保留旧入口短时服务、不要只依赖DNS |
先判断故障是所有站点都受影响,还是只有某个域名、某个路径或某类请求异常。检查时不要先重启服务,也不要立刻清理日志。
在Linux管理终端中,可以先执行以下低风险检查:
dig +time=2 +tries=1 A site-a.example.com
dig +time=2 +tries=1 AAAA site-a.example.com
curl -sk -o /dev/null -w 'code=%{http_code} connect=%{time_connect}s ttfb=%{time_starttransfer}s total=%{time_total}s\n' https://site-a.example.com/health
结果判断:
connect时间很长,优先检查网络入口、连接队列和防火墙;修复后,不要只从一台运维机访问一次。应从多个监控位置分别访问每个站点,并记录连续多个监测周期的状态码、连接时间、首字节时间和总耗时。DNS切换场景还要确认新旧入口都能处理残留缓存流量。
如果域名解析正常,但用户仍然无法访问,需要直接验证每个负载均衡入口。curl --resolve可以在不修改本机DNS的情况下,把指定域名临时解析到目标IP:
curl -sk --resolve site-a.example.com:443:203.0.113.10 \
  -o /dev/null \
  -w 'entry-a code=%{http_code} connect=%{time_connect}s ttfb=%{time_starttransfer}s total=%{time_total}s\n' \
  https://site-a.example.com/health

curl -sk --resolve site-a.example.com:443:203.0.113.11 \
  -o /dev/null \
  -w 'entry-b code=%{http_code} connect=%{time_connect}s ttfb=%{time_starttransfer}s total=%{time_total}s\n' \
  https://site-a.example.com/health
这一步的含义如下:
如果使用Nginx作为反向代理,可先验证配置,再进行无中断重载。重载前应保留当前配置版本,并确认已有回滚文件;不要在生产环境直接覆盖唯一配置。
sudo nginx -t
sudo nginx -s reload
nginx -t通过只代表语法和部分引用关系正确,不代表后端服务可用。重载后还要检查错误日志、上游5xx、连接数和延迟。如果新配置导致错误率上升,应立即恢复上一版经过验证的配置,再进行原因分析。
入口可达后,检查每个站点的请求分布。重点观察:
Linux节点可以使用以下命令进行初步确认:
ss -s
ss -lnt
uptime
ulimit -n
结果含义:
如果需要临时摘除节点,应使用负载均衡器的维护或排空机制,避免直接断电。排空时间应根据长连接、请求超时和WebSocket等业务特征设置。没有确认请求已结束前,不要强制终止进程。
如果多个应用节点同时出现延迟升高,问题可能不在应用服务器,而在共享依赖。应按以下顺序检查:
常见误判是“缓存集群仍能返回PING,所以缓存正常”。真正需要观察的是命中率、响应延迟和回源压力。缓存命中率从95%下降到70%,即使缓存进程仍在线,也可能让数据库承受数倍读取压力。
修复后,应先恢复一小部分流量,验证:
如果只能通过关闭部分非核心功能恢复,应明确记录降级状态和恢复条件,避免故障结束后遗留隐性功能缺失。
当故障涉及数据库主节点、读副本或会话存储时,先确认复制状态,再决定是否切换。至少需要记录:
如果复制延迟超过预设RPO,不应把“强制切换”当作默认修复方案。可以根据业务等级选择:
修复后不能只检查数据库进程是否启动,还要进行读写一致性验证。可以使用带请求ID的测试记录或业务测试数据,验证写入、读取、复制、切换和再次读取的完整链路。对订单、库存等关键数据,还应比对事件ID、版本号或事务位点,而不是只比较记录条数。
节点修复后不要立即恢复全部流量。推荐采用以下顺序:
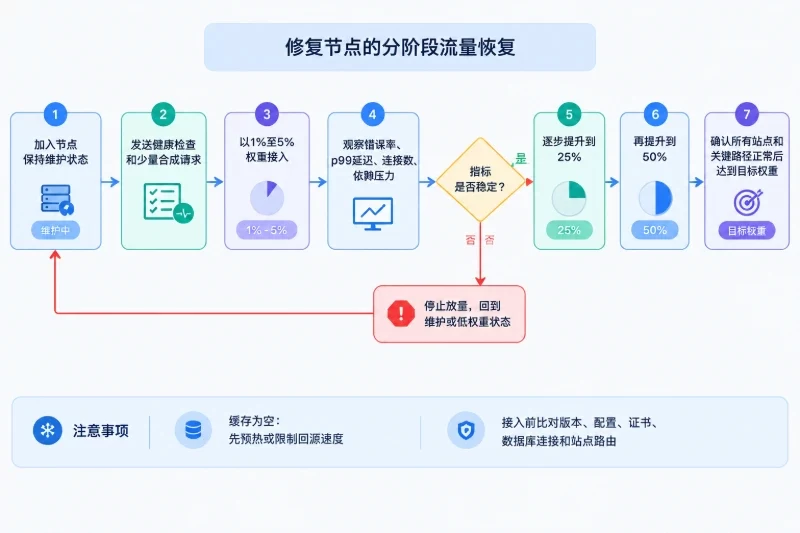
如果恢复节点的缓存为空,应先进行预热或限制回源速度。若节点版本与现网不一致,即使健康检查通过,也不应直接接入全部流量。先完成版本、配置、证书、数据库连接和站点路由的比对。
以下是按站点拆分上游池的Nginx关键片段示例,适用于Linux环境下的Nginx反向代理场景。地址、端口、超时时间和健康检查路径需要根据实际业务调整,不能直接把示例地址当作生产配置。
upstream site_a_backend {
    least_conn;

    server 10.10.1.11:8080 max_fails=3 fail_timeout=5s;
    server 10.10.1.12:8080 max_fails=3 fail_timeout=5s;
    server 10.10.2.11:8080 max_fails=3 fail_timeout=5s;
    server 10.10.2.12:8080 max_fails=3 fail_timeout=5s;

    keepalive 256;
}

server {
    listen 443 ssl;
    server_name site-a.example.com;

    location = /health/live {
        proxy_pass http://site_a_backend;
        proxy_connect_timeout 1s;
        proxy_read_timeout 2s;
    }

    location / {
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_set_header Host $host;
        proxy_set_header X-Request-ID $request_id;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;

        proxy_connect_timeout 1s;
        proxy_send_timeout 3s;
        proxy_read_timeout 3s;

        proxy_next_upstream error timeout http_502 http_503 http_504;
        proxy_pass http://site_a_backend;
    }
}
这段配置有几个边界需要特别注意:
max_fails属于被动失败判断,不能替代独立主动健康检查;proxy_next_upstream不应无条件用于订单、库存和支付等非幂等写请求;keepalive只代表单台Nginx与上游之间的连接复用,不代表跨负载均衡节点共享连接;nginx -t,并保留上一版本配置用于回滚。如果业务使用长连接,故障切换通常只能保证新连接转移,已经建立的连接可能需要客户端重新连接。因此客户端必须具备有限次数、带退避的重连机制,服务端也要设置连接上限,避免切换期间产生连接风暴。
高可用不能只依赖架构图。至少需要按以下顺序进行可控演练:
在低风险窗口内,将一台入口节点设置为维护状态,不直接关闭电源。验证:
恢复时以低权重重新加入,确认配置版本和证书版本一致。
摘除一个应用节点,执行核心读请求和幂等写请求。验证:
在明确回滚方式后,停止一个故障域的入口流量,模拟整组节点不可用。验证重点不是“服务是否还能打开”,而是:
先确认备份、复制状态、回滚方式和业务负责人已经就位。不要在没有备份和隔离确认的情况下直接执行强制提升。演练需要验证:
发生故障时,恢复顺序应优先保证入口可用,再恢复核心业务,最后恢复非关键功能:
每次演练或真实故障后,至少检查以下项目:
当这些检查能够在单节点、单站点和单故障域三个层级重复通过时,多站点集群才算真正具备承受十万级请求冲击的冗余能力。核心不是堆叠更多香港服务器,而是让入口、流量、应用、复制、切换和恢复验证形成一条没有隐藏单点的闭环。