香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


在相同盘数、RAID级别、接口类型和业务负载下,硬件RAID与软RAID没有普遍适用的高下之分。硬件RAID把阵列管理、校验计算以及部分写缓存交给独立RAID卡,换来操作系统隔离和较统一的管理方式;软RAID则由操作系统或存储软件完成,减少专用卡依赖,数据结构通常更透明,也更容易在兼容服务器之间迁移。
如果业务更看重受保护写缓存、现有厂商支持体系和服务器平台的标准化管理,可以优先考虑硬件RAID;如果更在意控制器故障后的迁移能力、硬件成本、磁盘可见性,或者使用高性能NVMe、ZFS等软件存储栈,软RAID通常更合适。需要注意的是,硬件RAID并不等于数据备份,软RAID也不是“没有故障点”:前者依赖控制器、缓存模块和兼容固件,后者依赖操作系统、阵列元数据、磁盘连接链路和正确的恢复流程。
本文比较的是两种具有直接替代关系的架构:
mdadm、Windows存储空间等软件管理阵列。主板上的“板载RAID”或“固件RAID”需要单独识别。它往往由主板固件保存阵列定义,再依赖操作系统驱动完成部分工作,通常不能直接获得独立硬件RAID卡的处理器和受保护写缓存优势。购买服务器时,如果厂商只写“支持RAID”,还需要确认是独立RAID卡、固件RAID,还是纯软件方案。
硬件RAID和软RAID都可能支持RAID1、RAID10、RAID5、RAID6等级别。RAID级别决定可容忍的磁盘故障数量、可用容量和重建压力,不能因为使用了RAID卡就忽略这一层选择。
例如,使用8块单盘容量为3.84 TB的十进制硬盘时:
| 阵列级别 | 理论可用容量 | 单盘故障容忍能力 | 典型取舍 |
|---|---|---|---|
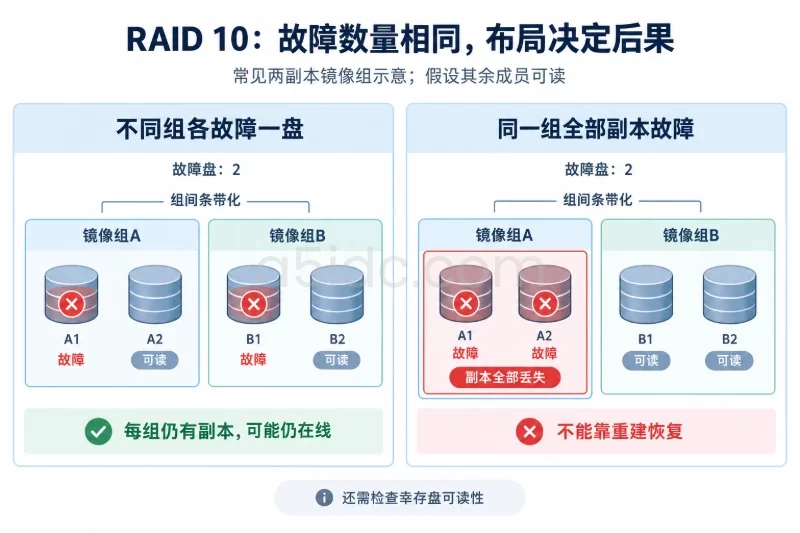
| RAID10 | 约15.36 TB | 通常可容忍多块磁盘,但取决于故障是否集中在同一镜像组 | 写入延迟和重建压力相对可控,容量利用率较低 |
| RAID5 | 约26.88 TB | 1块磁盘 | 容量利用率较高,但大容量磁盘重建期间风险和写入开销更值得关注 |
| RAID6 | 约23.04 TB | 2块磁盘 | 容错能力更强,校验计算和写入开销也更高 |
上述容量未扣除热备盘、分区、文件系统和预留空间,采用十进制TB计算。实际可用空间还会受到厂商容量显示方式的影响。
因此,合理的比较顺序应当是:先根据业务写入模式、容量增长和故障容忍要求确定RAID级别,再比较硬件RAID与软RAID的实现方式,而不是先买RAID卡再决定阵列结构。
RAID主要解决单机磁盘故障导致的可用性问题,不能覆盖以下场景:
生产环境至少应保留独立于阵列的备份,并定期验证备份是否能够真正恢复。RAID卡上的镜像盘、同一阵列中的副本,都不能算作独立备份。
硬件RAID的典型路径是:
应用程序 → 操作系统文件系统 → 虚拟磁盘 → RAID卡 → 物理磁盘
软RAID的典型路径是:
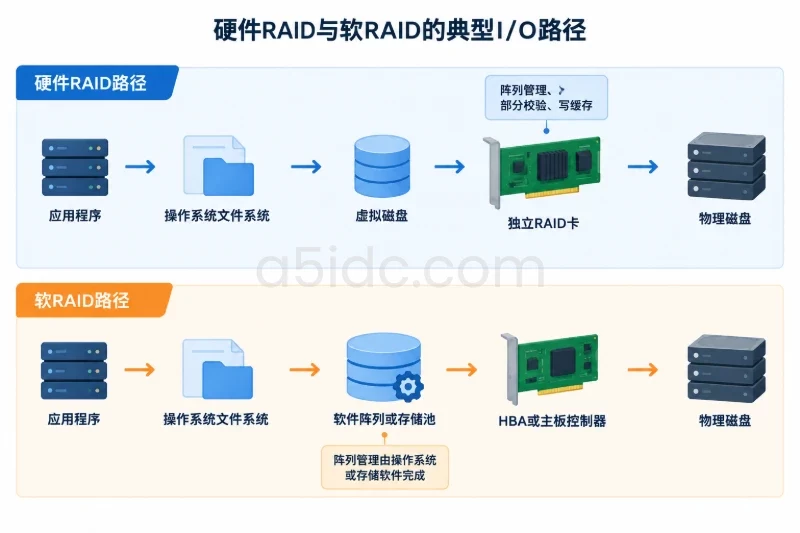
应用程序 → 操作系统文件系统 → 软件阵列或存储池 → HBA或主板控制器 → 物理磁盘
硬件RAID卡通常带有控制器处理器和缓存。部分企业级控制器配备电池保护缓存或闪存保护缓存,允许在磁盘尚未完成写入时暂存数据。服务器突然断电时,受保护缓存可以在供电恢复后继续提交尚未落盘的数据。
但“有缓存”不等于“可以永久开启写回策略”。如果电池失效、超级电容异常或闪存保护模块状态不正常,控制器通常会从写回模式降级到直写模式,业务写入延迟可能增加。为了追求性能而强制启用不受保护的写回,会扩大断电时的数据损坏范围。
软RAID可以利用操作系统页缓存、文件系统缓存、ZFS ARC或应用程序缓存,但这些机制不等同于RAID卡的受保护写回缓存。服务器断电后,内存中的脏数据可能无法恢复。因此,数据库等对同步写入和持久化顺序要求较高的业务,需要同时核对磁盘缓存策略、文件系统行为、UPS和应用程序的持久化配置。
早期处理器性能有限时,RAID5、RAID6的校验计算可能明显占用CPU,独立控制器能减轻主机负担。现代服务器CPU通常具备更强的并行计算能力,软RAID在顺序读写、普通文件服务和部分虚拟化场景中未必会成为主要瓶颈。
相反,硬件RAID卡可能成为新的限制点:
因此,不能仅凭“硬件有专用芯片”判断一定更快。应把存储介质、PCIe通道、控制器队列、CPU余量、文件系统和业务访问模式放在同一条I/O链路中评估。
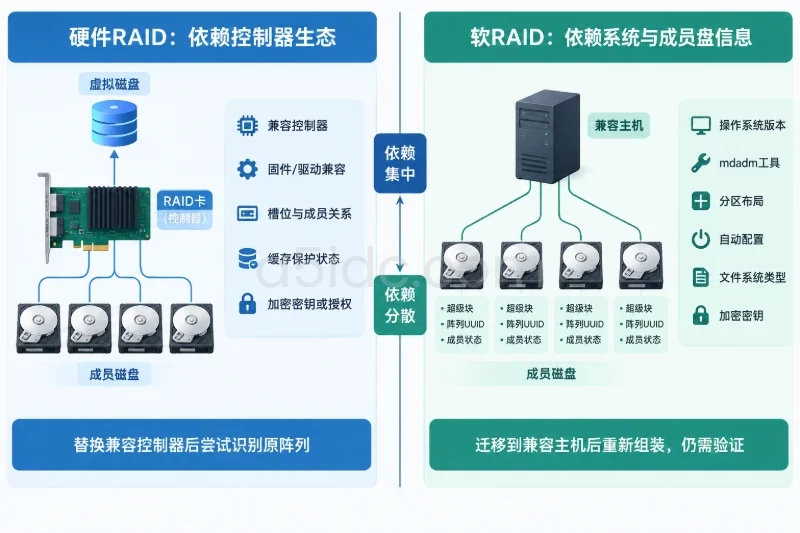
硬件RAID通常把多块物理盘包装成一个虚拟磁盘,操作系统无法直接看到每块成员盘上的文件系统结构。这样做有利于统一管理,却也增加了恢复时的控制器依赖。
硬件RAID卡故障后,阵列数据一般不会因为控制器本身损坏就立即消失。多数控制器会把阵列元数据保存在成员盘上,替换兼容控制器后可以尝试识别原阵列。但是恢复条件通常包括:
软RAID把更多元数据放在成员盘或操作系统可读取的位置。以Linux mdadm为例,阵列成员盘上保存有超级块,系统可以通过识别超级块、阵列UUID和成员状态来重新组装阵列。这会减少对某一块RAID卡的依赖,但并不代表任意系统都能自动识别。操作系统版本、mdadm工具、分区布局、启动盘配置和文件系统类型都可能影响恢复。
硬件RAID的优势在于,服务器操作系统只面对一个逻辑磁盘。安装系统、部署虚拟化平台或交付给不熟悉底层存储的运维团队时,管理界面相对集中。厂商通常也能提供控制器日志、磁盘定位、热备和重建状态等功能。
软RAID的优势在于,磁盘本身的状态更容易被操作系统和工具观察。将磁盘迁移到另一台兼容服务器时,不需要寻找同型号RAID卡,尤其适合有标准HBA、统一Linux发行版和自动化运维体系的环境。
不过,软RAID也存在迁移条件。比如:
两者不是“硬件封闭、软件完全自由”的简单关系。硬件RAID的依赖集中在控制器和厂商生态,软RAID的依赖分散在操作系统、工具、连接方式和运维能力中。
| 比较维度 | 独立硬件RAID | 软RAID或软件存储栈 | 对业务的实际意义 |
|---|---|---|---|
| 阵列管理位置 | RAID卡和其固件 | 操作系统或存储软件 | 决定故障时需要保留哪类配置 |
| 操作系统可见性 | 通常只看到虚拟磁盘 | 通常能看到成员盘和阵列状态 | 影响监控、迁移和取证 |
| 写缓存 | 可能有受保护缓存 | 依赖系统内存和软件策略 | 同步写入延迟可能不同 |
| 控制器故障 | 依赖兼容RAID卡恢复 | 通常可转移到兼容主机 | 影响备件策略和恢复时间 |
| CPU占用 | 控制器承担部分工作 | 主机承担校验和调度 | 需要结合服务器余量判断 |
| NVMe适配 | 取决于控制器和背板支持 | 通常更容易直接利用PCIe通道 | 高性能存储不应默认使用传统RAID卡 |
| 运维门槛 | 界面集中,但厂商知识重要 | 透明度高,但系统知识要求更高 | 影响团队培训和自动化能力 |
| 厂商锁定 | 型号、固件和管理工具影响较大 | 主要受操作系统和软件栈影响 | 影响长期扩容和备件采购 |
数据库日志、虚拟机存储等业务通常更关注低延迟同步写入和稳定的写入顺序。具备健康电池或闪存保护的硬件RAID写缓存,可能降低短时突发写入的延迟,并把阵列管理统一到控制器层。
但这项优势成立需要几个条件:
如果服务器CPU和内存资源充足,使用高性能SSD或NVMe,软RAID、ZFS或存储虚拟化平台也可能提供更好的可观测性和扩展性。此时应进行针对业务I/O模型的测试,而不是仅比较顺序读写带宽。
文件服务和备份仓库通常更重视容量、磁盘更换便利性和长期运行成本。若业务以大文件顺序读写为主,软件RAID配合HBA可以减少专用控制器成本,也便于在服务器升级时迁移磁盘。
对于大容量磁盘阵列,RAID5重建期间的风险和性能影响应认真评估。容量型存储常会在RAID6、RAID10、分布式纠删码或多副本之间做选择,不能只按单盘故障数量决定。若重建时间较长、阵列中还有持续写入,双盘容错或更小的故障域通常更容易控制风险。
小型业务往往希望“出现一块坏盘时有人能看懂并快速更换”。如果运维团队更熟悉厂商管理界面,服务器已经配置了兼容RAID卡,并且能够准备备件,硬件RAID可以简化日常操作。
如果服务器数量较多、硬件型号不统一,或者需要把磁盘迁移到不同主机,软RAID的统一命令、监控和自动化能力可能更有价值。此时必须把阵列降级告警、磁盘序列号识别、重建进度和备份验证纳入运维平台,不能只依赖人工登录服务器查看状态。
面对多块NVMe盘,传统SAS/SATA RAID卡可能不适合作为统一入口。原因不只是接口转换,还包括PCIe通道分配、队列深度、NUMA拓扑、散热和故障隔离。
这类环境应优先确认:
在高性能场景中,“不用RAID卡”不等于“不做冗余”,而是把冗余、校验和重建放到更适合的存储软件或分布式架构中。
硬件RAID的直接成本包括控制器、缓存保护模块、专用线缆、兼容背板和备用控制器。长期成本还包括:
如果服务器只有一台,而关键RAID卡没有备件,硬件方案的单点依赖会非常明显。即使阵列成员盘状态良好,等待兼容控制器或确认固件版本,也可能延长恢复时间。
软RAID可以省去专用RAID卡,但并不是零成本。服务器需要足够的CPU、内存、磁盘通道和可靠的HBA或背板,运维团队还需要掌握:
如果团队只熟悉RAID卡界面,却没有软件阵列经验,软RAID的学习和误操作成本可能超过节省的硬件费用。
RAID级别确定后,还要确认磁盘是否来自同一批次、是否安装在同一背板、是否共享电源和散热路径。硬件RAID和软RAID都无法消除同批次磁盘集中失效的风险。
重建期间通常会出现以下影响:
因此,不能把“支持热插拔”直接等同于“更安全”。热插拔只是更换方式,不能替代合理的RAID级别、备份和故障监控。
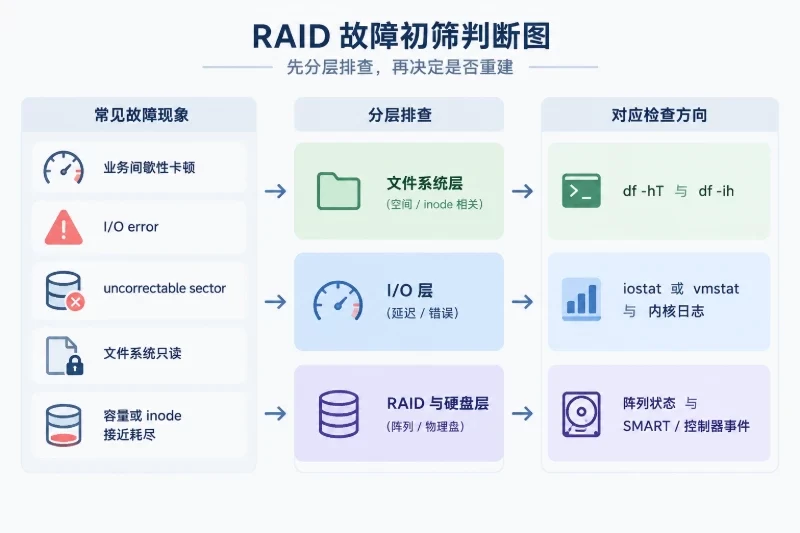
故障恢复的关键不是立即执行某个命令,而是先判断故障发生在哪一层。RAID卡、磁盘、操作系统、文件系统和应用数据的处理方式不同,错误操作可能把可恢复故障变成不可逆损坏。
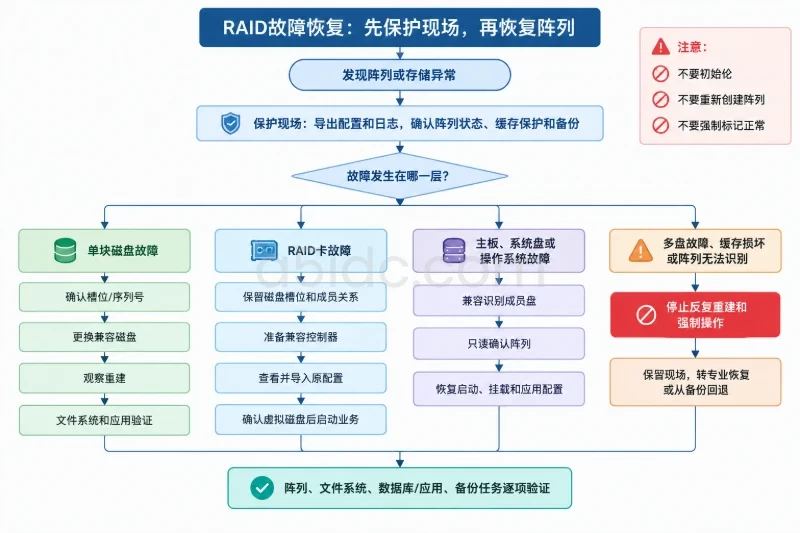
在更换磁盘或重建阵列前,应先确认以下信息:
硬件RAID环境应导出控制器配置和事件日志;软RAID环境应保存阵列状态、系统日志和磁盘健康信息。不要仅凭操作系统中的/dev/sda、/dev/sdb判断物理磁盘,因为设备名可能在重启或重新连接后变化。
Linux软RAID可以先使用只读查询命令检查状态:
lsblk -o NAME,SIZE,MODEL,SERIAL,TYPE,FSTYPE,MOUNTPOINT
cat /proc/mdstat
sudo mdadm --detail --scan
sudo mdadm --detail /dev/md0
sudo mdadm --examine --scan
上述命令只用于查看,/dev/md0需要替换为实际阵列设备。硬件RAID成员盘如果被控制器隐藏,操作系统可能无法显示完整状态,应以RAID卡管理工具、BMC或厂商诊断日志为准。
单盘故障是最常见、也是最适合现场恢复的情况。
硬件RAID处理重点:
软RAID处理重点:
更换操作属于会改变阵列状态的操作,应先完成备份或至少保留当前阵列信息。不要因为重建速度较慢就频繁暂停、重启或拔插其他成员盘,也不要把一块状态正常的磁盘当作故障盘移除。
RAID卡故障时,第一目标是保留阵列成员关系和缓存数据。
处理顺序通常是:
如果原RAID卡存在未落盘的脏缓存,是否能够恢复取决于电池、超级电容、闪存模块和兼容控制器的支持情况。没有受保护缓存时,即使磁盘阵列能够重新上线,最近一段时间已经被应用确认但尚未写入磁盘的数据也可能丢失,数据库需要依赖自身日志和备份进行一致性检查。
如果没有兼容控制器,不应直接把硬件RAID成员盘接入普通系统后尝试挂载。部分阵列布局、条带顺序和校验信息需要由控制器解析,盲目写入可能破坏后续恢复条件。此时应优先联系原厂支持或专业数据恢复人员,并保留原控制器、缓存模块和磁盘现场。
服务器主板或系统盘故障,并不一定表示数据阵列损坏。
硬件RAID环境中,如果控制器和成员盘正常,通常可以在更换主板或重装系统后重新加载控制器驱动,再通过虚拟磁盘访问数据。需要注意系统安装程序不能误把数据虚拟磁盘当作安装目标。
软RAID环境中,恢复重点是:
如果只是系统盘损坏,不能为了“重新识别阵列”而在原数据盘上重新创建同名阵列。重新创建可能覆盖超级块或改变元数据,使原本可组装的阵列变得难以恢复。
当故障盘数量超过RAID级别的容错能力时,应立即停止反复尝试重建。典型情况包括:
这类场景不适合通过“强制上线”“强制标记为正常”或重新初始化来碰运气。错误的强制操作可能改变条带顺序、覆盖校验信息或让后续专业恢复失去依据。
如果问题是文件系统损坏、数据库页损坏或误删除,而不是物理磁盘故障,继续重建RAID通常不会解决问题。应先冻结写入,保留磁盘和阵列状态,从备份、快照、数据库日志或专业恢复流程中选择回退路径。
阵列显示“Optimal”或“正常”不代表业务数据已经完全恢复。重建完成后,至少应完成以下检查:
文件系统修复属于可能修改数据结构的操作,必须先确认备份、卸载条件和影响范围。不能在业务仍然写入时直接执行可能改变元数据的修复命令。
可以按照以下规则缩小选择范围:
优先考虑带电池或闪存保护缓存的硬件RAID,并把控制器、电池、固件和导入配置流程纳入监控。
优先考虑软RAID或软件存储栈,但必须统一操作系统版本、阵列工具、HBA模式和恢复文档。
不要默认把磁盘接到传统硬件RAID卡上。先确认PCIe拓扑、软件存储栈和故障隔离能力,再决定是否使用支持NVMe的专用方案。
硬件RAID可能更容易交付,不过要为RAID卡故障准备同型号或兼容控制器,并定期演练导入原阵列。
软RAID或ZFS更容易纳入统一监控和迁移流程,但需要将阵列组装、系统重装、启动恢复和密钥管理写成文档。
不应只在硬件RAID和软RAID之间二选一。应同时增加独立备份、备用服务器、备用控制器或可迁移的恢复环境,降低单机故障的恢复时间。
可以用下面的条件表作为采购和架构评审的收口依据:
| 业务条件 | 更倾向的方案 | 选择时必须补齐的条件 |
|---|---|---|
| 标准化单机、厂商维护、已有RAID卡生态 | 硬件RAID | 备用卡、缓存保护、固件兼容和导入演练 |
| 多型号服务器、需要磁盘迁移 | 软RAID或软件存储栈 | 统一系统版本、HBA模式和阵列恢复脚本 |
| 数据库或虚拟化同步写入较多 | 受保护缓存的硬件RAID,或经验证的软件存储栈 | 持久化语义、UPS、缓存健康和应用一致性测试 |
| 大容量文件和归档 | RAID6、RAID10或软件存储方案 | 重建窗口、备份策略、磁盘批次和容量增长 |
| 高性能NVMe | 支持NVMe的软件或专用存储方案 | PCIe通道、散热、队列、监控和故障隔离 |
| 团队不具备现场恢复能力 | 有厂商支持的硬件方案或托管存储方案 | 服务响应、备件时效和实际恢复演练 |
最终判断不应停留在“RAID卡还是软件”这一层。对于硬件RAID,要问清楚控制器坏了之后由谁恢复、多久能拿到兼容备件、缓存保护是否真实有效;对于软RAID,要问清楚系统盘坏了之后谁能重新组装阵列、磁盘迁移到哪台服务器、阵列和文件系统状态如何验证。
能准备兼容RAID卡、重视统一管理并需要受保护写缓存的用户,硬件RAID更容易形成清晰的交付边界。重视迁移自由度、使用NVMe或具备成熟Linux存储运维能力的用户,软RAID或软件存储栈通常更灵活。无论选择哪一种,都应把磁盘故障、RAID卡故障、系统故障和逻辑数据损坏分别写进恢复手册,并通过备份恢复演练验证这套方案确实可用。