

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


业务出现间歇性卡顿、磁盘指示灯长时间闪烁,或者系统日志出现 I/O error、uncorrectable sector、文件系统只读等信息时,不要第一时间拔盘、强制下线成员盘或启动重建。所谓“硬盘坏道”可能是盘面介质错误,也可能是阵列控制器无法读取某个扇区、文件系统损坏、inode 耗尽或日志把文件系统写满。
RAID 5/6/10 遇到异常时,正确顺序是:先保留现场并确认容量、inode、I/O 延迟、内核日志和文件系统状态,再判断阵列是否真的降级以及剩余冗余是否足够。RAID 5 只允许一块成员盘失效,RAID 6 通常允许两块成员盘失效,RAID 10 则取决于故障是否落在同一镜像组;在没有完成这些检查前直接重建,可能把原本可读的数据暴露在持续高负载下,进一步扩大损失。
“磁盘报错”不等于“必须马上重建”。先把问题分成三层:
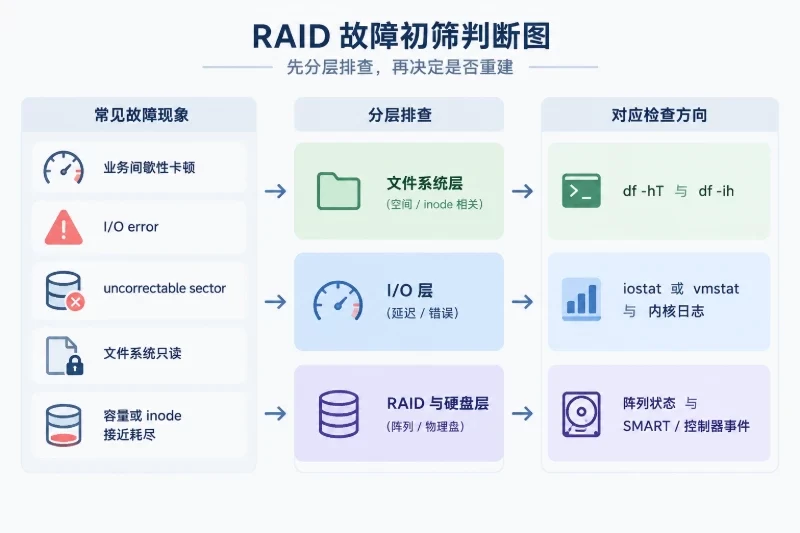
Degraded、成员盘被标记为 Failed,或者硬盘出现待处理扇区、不可校正错误和自检失败。这三类故障可能同时出现。例如,一块硬盘反复读错会导致阵列校验和重试,I/O 延迟上升;应用因写入变慢而产生更多日志,最终又把文件系统写满。此时只处理“空间不足”或只更换硬盘,都可能遗漏真正的根因。
在现场信息尚未保存前,先避免以下操作:
mdadm --create、初始化虚拟磁盘、清除阵列元数据等操作。fsck -y、xfs_repair -L 等会修改文件系统的命令。如果业务仍在运行,先按照业务优先级减少非必要写入。正在写入的数据库、日志服务和缓存服务不要突然断电或强制停止,必要时通过正常的服务流程暂停低优先级任务。
以下命令适用于常见 Linux 主机,都是读取状态,不会启动重建或修改阵列:
date -Is
uname -a
lsblk -e7 -o NAME,MODEL,SERIAL,SIZE,TYPE,FSTYPE,MOUNTPOINTS
findmnt -rn -o TARGET,SOURCE,FSTYPE,OPTIONS
重点记录:
ro。如果 lsblk 中看到的是 /dev/md0、/dev/mapper/... 或控制器提供的虚拟磁盘,不要把它误认为某一块物理盘。后续检查必须建立“阵列成员—虚拟磁盘—文件系统”的对应关系,否则可能把错误的设备送入更换流程。
df -hT
df -ih
df -hT 主要看数据块使用率,df -ih 主要看 inode 使用率。两者的判断方式不同:
| 观察结果 | 常见含义 | 后续动作 |
|---|---|---|
| 数据块接近 100%,inode 仍有余量 | 大文件、日志、备份或临时文件占满空间 | 找出增长目录,先确认业务影响,再通过正常保留策略处理 |
| inode 接近 100%,数据块还有余量 | 大量小文件、缓存文件、邮件队列或临时目录堆积 | 检查文件数量和生命周期,不能只删除一个大文件 |
| 数据块和 inode 都正常,但 I/O 延迟很高 | 可能是硬盘、阵列、队列或业务负载异常 | 继续看 iostat、内核日志和阵列状态 |
| 使用率突然下降,但服务仍报空间不足 | 可能存在已删除但仍被进程打开的文件 | 检查打开文件,按服务流程释放文件句柄 |
文件系统被挂成 ro | 内核检测到文件系统或块设备错误,已限制写入 | 先保留现场和备份,不能直接在线修复 |
80% 左右可以作为容量预警,90% 以上通常应进入处理窗口,但这不是所有环境都适用的硬阈值。数据库、日志系统和需要临时空间的任务,应设置更低的业务阈值。inode 使用率在 ext4 中通常很有参考价值;某些动态分配 inode 的文件系统还需要结合实际文件数量和目录结构判断。
先检查系统日志和日志目录的占用:
sudo journalctl --disk-usage
sudo du -xhd1 /var/log 2>/dev/null | sort -h
sudo find /var/log -xdev -type f -size +1G -ls 2>/dev/null
然后查看是否有已删除但仍被进程占用的文件:
sudo lsof +L1 2>/dev/null
如果发现日志文件已经删除,但进程仍然持有文件句柄,df 可能仍显示空间没有释放。这种情况不应直接删除其他文件,也不应随意重启所有服务;需要确认对应进程,再按照服务的优雅重载或重启流程释放句柄。
重点搜索以下信息:
No space left on deviceI/O errorBuffer I/O errorblk_update_requestread-onlyEXT4-fs errorXFSuncorrectablereset、timeout日志增长本身不一定说明硬盘坏了。如果系统正在反复记录同一块盘的读错误,日志会快速膨胀;如果只是应用配置错误导致大量业务日志,也可能把阵列空间写满。要结合时间顺序判断:先出现硬盘错误,还是先出现应用日志暴增。
安装并启用 sysstat 的 Linux 环境可以运行:
iostat -xz 1 5
如果系统没有 iostat,可以先使用:
vmstat 1 5
iostat 中常见字段的含义如下:
r/s、w/s:每秒读写请求数量;rkB/s、wkB/s:每秒读写数据量;await:请求从发出到完成的平均等待时间,包含排队时间;aqu-sz:平均队列长度;%util:设备忙碌时间比例。不要只看到 %util 接近 100% 就断定硬盘损坏。高并发顺序读写、重建、校验和备份都可能让设备长时间繁忙。更有价值的是对比:
await 是否持续升高;例如,某个低延迟存储环境平时 await 只有几毫秒,异常时连续五个采样都达到几十甚至上百毫秒,就值得重点调查;但机械盘、SSD、控制器缓存和业务负载不同,不能用一个固定数字替代基线。一次短暂尖峰不等于坏道,持续升高并伴随错误日志才更具指向性。
重建期间还要注意:阵列重建会增加读写请求,await 上升并不必然表示新故障。可以把重建开始时间、业务负载和 I/O 采样一起保存,避免把正常的重建压力误判为第二块硬盘立即失效。
如果使用 Linux mdadm,先查看全局状态:
cat /proc/mdstat
再对已经确认的阵列设备执行只读查询。下面的 /dev/md0 只是示例,必须替换为实际设备:
sudo mdadm --detail /dev/md0
重点查看:
State 是否包含 clean、active、degraded、recovering 或 resyncing;Active Devices、Working Devices、Failed Devices 数量;removed、faulty 或 failed;如果 /proc/mdstat 显示正在恢复,先记录恢复速度、已完成比例和新增错误,再决定是否需要调整业务负载。不要在不清楚成员盘身份时直接执行移除或重新添加命令。
硬件 RAID 通常只向操作系统呈现一个虚拟磁盘,操作系统里的 /dev/sdX 可能不是物理硬盘本身。此时需要通过该控制器对应的管理界面或命令行查看:
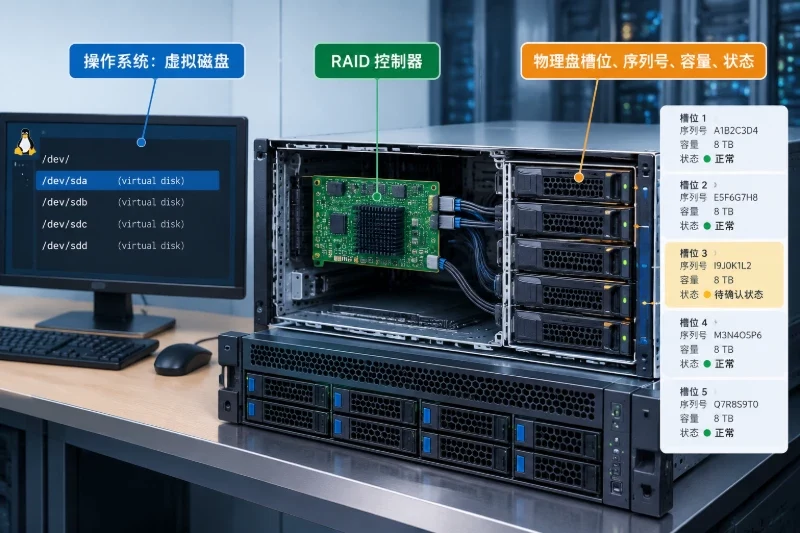
Online、Failed、Predictive Failure、Rebuild 等状态;不同控制器的命令参数不能混用。不要看到网上某个型号的命令就直接在当前主机执行,尤其不要执行带有 initialize、clear、force、replace、rebuild 含义的参数。先确认控制器型号和管理工具版本,再使用匹配文档中的只读查询命令。
直连硬盘可以使用:
sudo smartctl -x /dev/sdX
sudo smartctl -l selftest /dev/sdX
/dev/sdX 需要替换为已经确认的物理设备。重点关注:
重映射扇区不一定表示设备马上失效,但如果待处理扇区、不可校正错误或错误日志持续增加,风险明显升高。SMART 显示 PASSED 也不能证明阵列绝对正常,因为控制器可能隐藏了物理盘,间歇性超时也不一定会反映为 SMART 失败。
如果阵列当前健康、业务负载较低,可以考虑启动短自检:
sudo smartctl -t short /dev/sdX
启动前要确认设备确实是目标物理盘,并查看命令输出中的预计完成时间。阵列已经降级、I/O 延迟明显升高或硬盘正在重建时,不建议随意启动长时间自检。不要使用带写入性质的坏道测试,尤其不要在唯一数据副本或降级阵列上运行 badblocks -w。
findmnt -no TARGET,SOURCE,FSTYPE,OPTIONS --target /data
把 /data 替换为实际挂载点。如果输出选项中出现 ro,说明文件系统可能已经因为错误被切换为只读。此时应先减少写入、保护数据并检查阵列状态,不要直接在挂载状态下执行修复。
文件系统修复必须满足两个前提:
如果是根文件系统,通常需要维护窗口或救援系统。强行在线运行修复命令,可能产生新的不一致。
在确认文件系统已卸载、并且已经完成重要数据备份后,可以先进行不修改数据的检查:
sudo e2fsck -fn /dev/mapper/vg0-lv_data
这里的设备名只是示例,必须替换为实际文件系统设备。-n 表示不执行修复,但检查结果仍要结合是否卸载、是否存在底层读错误来判断。只有在备份、设备状态和维护窗口都满足条件时,才考虑执行实际修复。
不要直接复制网上的 fsck -y。自动确认所有修复选项可能改变目录项、链接关系和文件元数据,发生误判时没有简单回滚方式。
XFS 可以在卸载后先使用检查模式:
sudo xfs_repair -n /dev/mapper/vg0-lv_data
不要把 xfs_repair -L 当作常规修复手段。它会丢弃日志内容,可能造成最近提交的元数据或文件变化丢失,只有在明确评估风险并且没有更安全恢复路径时才考虑。文件系统检查报告若同时出现底层读错误,应先处理阵列和硬盘问题,否则文件系统修复可能只是把硬件故障暴露成更多逻辑损坏。
检查完成后,可以按下面的分支判断是否进入重建流程:
| 检查结果 | 更可能的问题 | 是否立即重建 |
|---|---|---|
| RAID 仍为健康状态,容量或 inode 已满,日志快速增长 | 文件系统或应用层资源耗尽 | 不重建;先处理空间、文件数量和日志策略 |
| RAID 健康,但单盘 SMART 告警逐步增加 | 预测性硬盘故障 | 先备份和记录槽位、序列号,再安排受控更换 |
| RAID 已降级,但没有第二块盘错误,关键数据尚可读取 | 成员盘失效或被控制器下线 | 先确认替换盘身份和容量,再在维护窗口重建 |
| RAID 已降级,同时其他盘出现不可校正读错或超时 | 重建期间可能遇到潜在坏扇区 | 不要强制加速或反复重建,优先备份可读数据并保留日志 |
| RAID 5 已有一块成员盘失效,又出现另一块无法读取 | 可能无法恢复受影响条带 | 停止非必要写入,避免盲目操作,优先进行专业级数据保护 |
| RAID 6 已有一到两块盘异常,其他盘也有读错 | 冗余余量正在快速消耗 | 不要把“还能工作”当作安全,先保存数据和完整状态 |
| RAID 10 有一块盘异常 | 需要确认该盘所在镜像组 | 检查同组另一块盘是否健康,再决定更换和重建 |
| 文件系统变为只读,内核持续报文件系统错误 | 上层文件系统可能已损坏 | 不在线修复;先保护数据,待阵列稳定后离线检查 |
RAID 5 使用单重校验,通常只能容忍一块成员盘失效。阵列降级后,读取缺失数据需要通过剩余数据和校验计算;重建时还要读取其他成员盘的大量数据。
如果重建期间另一块盘出现不可读扇区,受影响条带可能无法完整计算。即使第二块盘没有被控制器标记为 Failed,一个潜在的不可读扇区也可能让重建中断或产生无法恢复的数据块。因此,RAID 5 降级后的首要任务是确认剩余磁盘是否有读错记录,而不是单纯追求更快的重建速度。
RAID 6 通常具备双重校验,可以容忍两块成员盘失效,但它仍然依赖剩余磁盘上的数据和校验信息。以下情况仍然危险:
因此,RAID 6 可以延缓故障升级,不等于可以跳过备份和现场留证。
RAID 10 的容错能力不是“任意两块盘都能坏”。如果两块故障盘属于不同镜像组,阵列可能仍能工作;如果两块盘属于同一镜像组,另一份数据也可能同时丢失。
更换 RAID 10 成员盘前,必须确认:
满足以下条件后,才适合进入受控更换和重建:
替换动作应使用服务器或控制器支持的热插拔、成员替换流程。不要在系统没有明确识别故障盘的情况下凭槽位猜测,也不要为了“让阵列恢复 Optimal”而强制添加一块未经确认的盘。
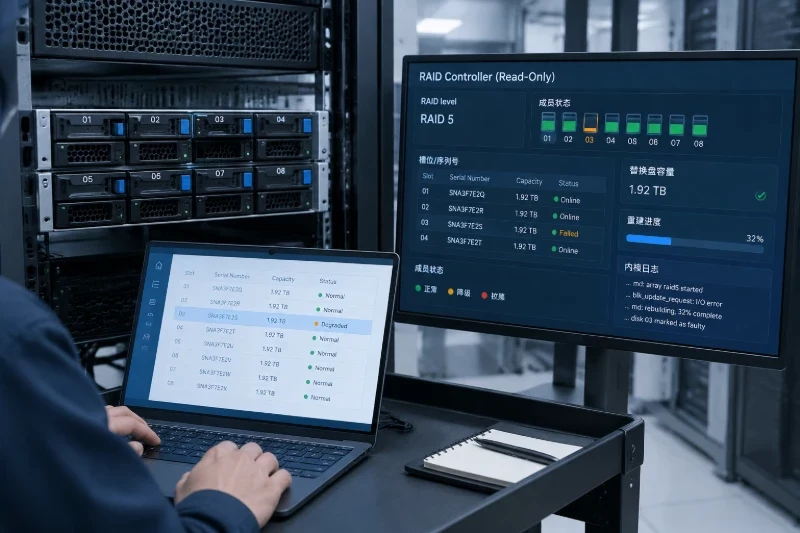
重建过程中需要持续关注:
await 和队列是否持续恶化;rw;Linux 软件 RAID 可重复查看:
watch -n 2 cat /proc/mdstat
硬件 RAID 则使用对应管理界面的只读状态页。不要为了提高重建速度,盲目把后台重建优先级调到最高;重建过度占用 I/O 后,可能影响业务读写,也会增加其他成员盘的读取压力。
重建完成后不能只看一行 Optimal 或 clean。建议按以下项目逐项验收:
| 验收项目 | 正常表现 | 异常表现 | 建议留证 |
|---|---|---|---|
| RAID 状态 | 成员数量完整,无 Failed、Degraded、Rebuild | 仍有缺失成员、重建未结束或校验错误 | 阵列详情、重建起止时间、成员序列号 |
| 物理盘状态 | 无新增不可校正错误,短自检或控制器检查通过 | 待处理扇区、读错、超时持续增加 | 完整 SMART 或控制器事件日志 |
| 容量 | 数据块未接近业务设定上限 | 接近 90% 以上或已满 | df -hT 前后输出 |
| inode | 仍有充足 inode 余量 | 接近耗尽或已耗尽 | df -ih 前后输出 |
| I/O 延迟 | 回到正常基线,队列不持续堆积 | await 持续高于历史基线,队列不断增长 | iostat -xz 1 5 多次采样 |
| 文件系统 | 挂载状态为 rw,无新增文件系统错误 | 自动变为 ro、出现元数据错误 | findmnt、内核日志、离线检查结果 |
| 日志增长 | 错误日志停止重复增长,日志轮转正常 | 同一 I/O 错误持续刷屏或日志再次写满 | journalctl、日志目录大小和增长时间线 |
| 业务读写 | 关键服务读写、查询和任务正常 | 持续超时、文件打不开或数据校验失败 | 应用健康检查、业务错误日志 |
“正常”最好与故障前的基线比较,而不是只套用一个固定阈值。例如,原本 await 稳定在 5 毫秒左右,修复后长期保持 6~10 毫秒通常比故障期的 100 毫秒更合理;如果原本就是高延迟机械存储,则应使用该环境自己的历史范围。
证据应包含时间、设备身份和原始输出,不能只保存一张状态截图。可以在独立管理终端或不属于故障阵列的存储位置保存:
lsblk、findmnt、df -hT、df -ih 输出;/proc/mdstat 和 mdadm --detail 输出,或硬件控制器阵列详情;iostat;如果需要在 Linux 终端保留交互过程,可以使用:
sudo script -a /root/raid-evidence-$(date +%F-%H%M).log
进入记录环境后执行检查命令,完成后输入:
exit
如果根文件系统或日志分区已经接近写满,不要把证据继续保存到同一阵列。优先写入独立磁盘、远程管理终端或已经确认可用的外部位置。证据文件本身不应覆盖原始日志,也不要为了腾空间而删除尚未分析的错误记录。
阵列恢复正常后,先确认重建或校验任务已经真正结束,再进行文件系统和业务复测。至少应重新检查:
df -hT
df -ih
findmnt -rn -o TARGET,SOURCE,FSTYPE,OPTIONS
iostat -xz 1 5
同时查看最近一段时间的内核日志:
sudo journalctl -k --since "-2 hours" --no-pager
如果日志中不再出现新的读写错误,文件系统保持 rw,容量和 inode 没有继续异常增长,I/O 延迟回到业务基线,关键服务也能完成读写和查询,才说明修复结果基本通过。后续可以在低负载和已有备份的前提下安排阵列一致性检查或巡检,但应区分“只读检查”和“自动修复”选项,不能未经评估就开启会写回数据的修复模式。
接下来至少观察一个完整的业务高峰周期,重点关注硬盘错误计数是否继续增加、日志是否再次快速增长、await 是否逐步升高,以及 RAID 是否重新进入降级状态。若同一块盘再次出现待处理扇区、不可校正错误或超时,即使阵列暂时显示健康,也应把它视为持续性风险,而不是一次已经结束的告警。


