

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


“香港云服务器适合托管跨境 CRM 系统吗?”不能靠一次 ping、一次登录或云服务器内部访问结果判断。常见的误判是:云内健康检查正常,但办公网络在业务高峰访问客户搜索接口时出现长尾延迟;服务恢复后首页能够打开,新增客户或跟进记录却出现重复、遗漏或读取不到。
我会按“确认采样有效性 → 外部可达性 → 关键业务接口 → 真实并发 → 数据一致性与故障恢复”的顺序评测。只有在实际用户节点、明确时间窗口、固定数据条件和可复现的并发模型下,延迟、错误率、容量与恢复结果都达到企业预先设定的业务目标,香港云服务器才具备托管该跨境 CRM 系统的候选条件。
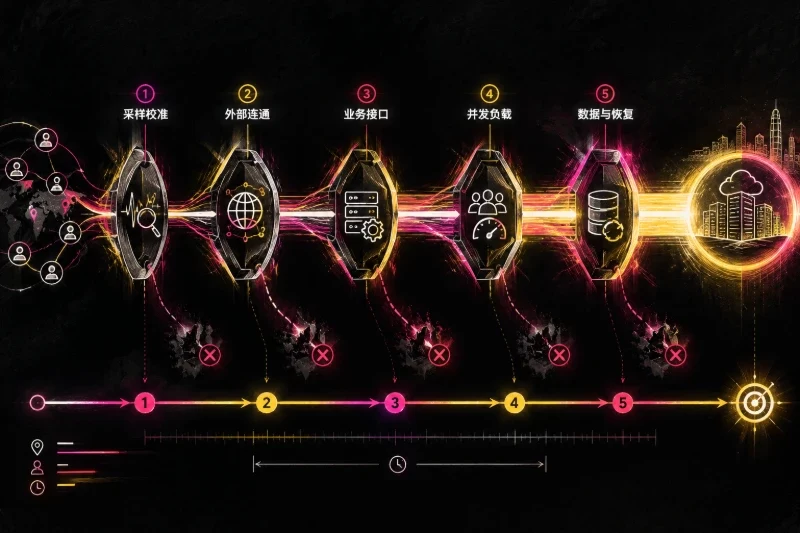
评测前不要只记录服务器是否在线,而要把 CRM 拆成可以重复执行和判定成功的业务动作。
| 业务动作 | 成功条件 | 计时范围 | 需要记录的异常 |
|---|---|---|---|
| 登录 | 身份验证成功并完成首页关键数据加载 | 发起请求至关键数据加载完成 | 超时、认证失败、重复提交 |
| 客户搜索或列表查询 | 返回完整结果,字段、分页和排序正确 | 请求发出至结果可展示 | 空结果、分页错误、数据库超时 |
| 新增或修改客户 | 返回成功,刷新或重新读取后仍能得到最新数据 | 提交至服务端确认并完成读取校验 | 重复写入、写入成功但读取不到 |
| 跟进记录写入 | 返回有效记录编号或成功状态 | 提交至服务端确认 | 重试重复、状态不一致 |
| 批量导入或导出 | 任务完成,数量和内容与源数据一致 | 任务提交至处理完成 | 队列积压、部分失败、文件超时 |
每项指标都要绑定业务目标,而不是事后看到数字再判断。例如,企业可以分别定义:
没有这些目标时,测试仍然可以产生数据,但只能说明“当前环境的表现”,不能直接说明“是否适合采购”。
网络和性能结论必须同时写明测试节点、测试时间、应用环境、方法与样本边界。至少保留以下信息:
| 记录项 | 应记录的内容 |
|---|---|
| 测试节点 | 企业办公网络、实际远程办公网络、云环境内部探针等 |
| 测试时间 | 开始时间、结束时间和时区;区分业务低峰、高峰及历史异常时段 |
| 应用环境 | 应用版本、数据库数据量、缓存状态、配置变更 |
| 业务条件 | 查询条件、分页位置、记录数量、文件大小、附件情况 |
| 并发模型 | 在线用户数、活跃请求数、每秒请求数、思考时间和接口比例 |
| 样本统计 | 总请求数、成功数、失败数、超时数及错误类型 |
| 性能指标 | 平均值、P50、P95、P99、最大值 |
| 服务端指标 | CPU、内存、存储等待、连接池、数据库等待、队列长度 |
| 恢复指标 | 故障触发时间、告警时间、业务恢复时间、数据校验结果 |
企业有多个办公地点或多种实际使用网络时,应按节点分别统计,不能把所有结果直接合并成一个平均值。否则单个节点的丢包或超时可能被其他正常节点掩盖。
连接状态也必须分开:
首次访问包含 DNS、TCP 和 TLS 建连,日常操作则可能复用连接。只测热连接会低估首次访问耗时,只测冷连接又可能高估连续操作的实际体验。
样本量不应只写“测试通过”。每个关键接口至少要保留样本总量、失败样本和分位数。P99 在样本很少时不稳定,因此必须把样本数量和测试窗口一并保存,不能只引用一个漂亮的平均值。
外部可达性排查的目标,是确认问题发生在 DNS、连接建立、TLS、网络传输,还是已经进入应用内部。应从实际用户节点和云内探针分别执行。
以下命令适用于能够运行 curl 的 Linux 或 macOS 测试终端。URL 只是占位符,应替换为企业已批准的固定健康检查地址;该地址不应触发写入或修改数据。
export URL='https://crm.example.com/healthz'

for i in $(seq 1 30); do
  printf '%s,' "$(date -Is)"
  curl -sS -o /dev/null \
    --connect-timeout 5 \
    --max-time 30 \
    -w 'dns=%{time_namelookup},tcp=%{time_connect},tls=%{time_appconnect},ttfb=%{time_starttransfer},total=%{time_total},code=%{http_code}\n' \
    "$URL"
  sleep 2
done
这组结果可以拆分为:
time_namelookup:DNS 解析耗时;time_connect:TCP 建连耗时;time_appconnect:TLS 握手完成耗时;time_starttransfer:收到首字节前的耗时;time_total:完整响应耗时;http_code:HTTP 状态码。如果要补充网络层观察,可以使用:
ping -c 20 crm.example.com
但 ICMP 可能被服务端或网络设备限制,ping 不能替代真实 HTTPS 请求,也不能单独证明 CRM 页面或接口性能。
外部可达性结果应按下面的方式解读:
| 现象 | 更可能的范围 | 后续操作 |
|---|---|---|
| DNS 偶发失败,其他请求正常 | 名称解析或本地缓存 | 按采样节点比较失败时间,核对解析记录与客户端缓存 |
| TCP 建连变慢并伴随丢包 | 用户节点到服务端的网络路径 | 按节点和时间段拆分,不要直接归因于云实例计算资源 |
| TCP 正常,但 TLS 或首字节耗时增加 | 服务端握手、连接数、应用排队或资源紧张 | 对照连接数、应用队列、CPU 和日志时间线 |
| 首字节正常,但完整响应变慢 | 返回数据量、传输过程或页面处理 | 固定响应大小,分别比较接口响应和页面渲染 |
| 云内探针正常,办公节点异常 | 用户侧网络、终端或外部访问路径 | 保留节点差异,不要用云内结果替代用户体验 |
| 所有节点同时变慢 | 应用、数据库或云实例整体压力 | 进入服务端指标和并发测试 |
| 健康检查正常,搜索接口超时 | 基础服务可达,但业务链路存在瓶颈 | 检查查询、数据库、连接池和返回数据量 |
健康检查接口只适合判断基础可用性。它很快,并不代表登录、搜索、写入和批量任务也满足业务要求。
网络确认正常后,再测试 CRM 关键接口。首页不应作为唯一指标,因为首页可能命中缓存,真正影响业务的通常是搜索、写入和批量任务。
用户侧总耗时可以拆成:
用户侧总耗时
≈ DNS + TCP + TLS + 排队 + 应用处理 + 数据库处理 + 响应传输
应用日志、网关日志和数据库监控需要使用同一请求编号或时间戳对齐。判断逻辑如下:
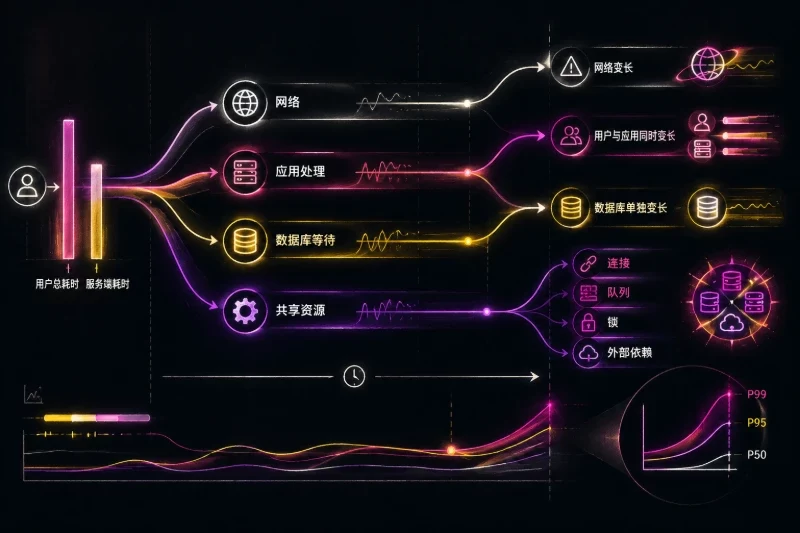
每个接口至少输出以下指标:
错误率可以按下式计算:
错误率 = 失败请求数 ÷ 总请求数 × 100%
查询测试必须固定筛选条件、结果数量和分页位置。新增、修改和跟进写入则要固定字段数量、校验规则和附件情况。批量任务要固定文件大小、记录数和字段类型,否则前后两次延迟没有可比性。
下面是一个只读接口的采样示例。它适合生成重复样本,不适合代替正式并发压测:
export API_URL='https://crm.example.com/api/customers?keyword=test&page=1'
export TOKEN='仅使用测试环境或专用测试账号令牌'

for i in $(seq 1 30); do
  printf '%s,' "$(date -Is)"
  curl -sS -o /dev/null \
    --connect-timeout 5 \
    --max-time 30 \
    -H "Authorization: Bearer ${TOKEN}" \
    -w 'status=%{http_code},ttfb=%{time_starttransfer},total=%{time_total}\n' \
    "$API_URL"
  sleep 2
done
不要把生产账号令牌直接写入脚本或提交到代码仓库。若接口涉及客户资料,应使用脱敏数据或专用测试租户。
同时在线用户数、正在执行请求的用户数和每秒请求数不是同一个指标。
设:
则可以使用:
请求速率 λ ≈ 在线用户数 N × 每用户请求率 r

平均同时执行请求数 C ≈ 请求速率 λ × 平均响应时间 T
例如,某测试模型假设每名用户平均每 20 秒发起一次请求,则每用户请求率为 1/20;如果同时在线用户数和平均响应时间发生变化,实际请求速率与同时执行请求数也会随之变化。这个示例只是说明计算方法,不能替代企业自己的用户行为数据。
压测计划至少要记录:
对于只读搜索接口,可以使用已批准的压测工具模拟用户思考时间。下面是一个最小化的 k6 示例,使用环境变量传入地址和测试参数,不包含写入操作:
import http from 'k6/http';
import { check, sleep } from 'k6';

const baseURL = __ENV.BASE_URL;
const searchPath = __ENV.SEARCH_PATH || '/api/customers?keyword=test&page=1';
const token = __ENV.TOKEN || '';
const targetVUs = Number(__ENV.TARGET_VUS || 10);
const thinkSeconds = Number(__ENV.THINK_SECONDS || 5);

export const options = {
  stages: [
    { duration: '5m', target: targetVUs },
    { duration: '10m', target: targetVUs },
    { duration: '5m', target: 0 }
  ]
};

export default function () {
  const params = token
    ? { headers: { Authorization: `Bearer ${token}` } }
    : {};

  const response = http.get(`${baseURL}${searchPath}`, params);

  check(response, {
    'status is 2xx': (r) => r.status >= 200 && r.status < 300
  });

  sleep(thinkSeconds);
}
执行时使用测试账号和测试地址:
BASE_URL='https://crm.example.com' \
SEARCH_PATH='/api/customers?keyword=test&page=1' \
TARGET_VUS=20 \
THINK_SECONDS=5 \
k6 run crm-read.js
这个脚本中的 VUs 表示压测工具维持的虚拟用户数,不等于每秒请求数,也不等于数据库连接数。需要验证固定请求速率时,应使用压测工具的到达率模型,并单独记录实际 RPS、响应时间和错误率。压测工具自身的 CPU、网络和连接能力也要确认,否则生成端可能先成为瓶颈。
建议按阶梯增加负载:先建立低负载基线,再逐步达到目标峰值和预留负载。每一级都要保留稳定运行窗口,不能刚加压就读取结果。出现以下任一情况时,应停止继续加压:
并发结果可以这样判断:
| 压力变化 | 延迟和错误变化 | 结果含义 |
|---|---|---|
| 并发增加,延迟小幅上升,错误率稳定 | 资源仍有余量 | 继续确认长时间运行是否稳定 |
| P50 稳定,P95、P99 陡增 | 排队或共享资源争用 | 检查连接池、数据库、锁等待和应用队列 |
| CPU随负载接近上限,延迟同步上升 | 计算资源成为瓶颈 | 降低并发复测,确认延迟是否随负载恢复 |
| CPU不高但请求超时 | 等待型瓶颈更可疑 | 检查数据库、存储、连接和外部依赖 |
| 连接数达到上限且错误率升高 | 连接或并发控制触顶 | 核对应用与数据库连接上限、超时和重试 |
| 压测结束后队列仍增长 | 处理能力低于进入速度 | 不能用压测期间平均值判定通过 |
| 服务正常但数据重复或缺失 | 幂等或重试处理不足 | 先停止加压,核对数据一致性 |
查询延迟正常,不代表 CRM 写入可靠。新增客户、修改客户和写入跟进记录至少要执行“写入—读取—再次写入或重试—结果核对”的闭环。
测试时应:
test_run_id;写入接口的命令只能替换为企业实际存在且已批准的测试接口。下面仅展示请求结构,不代表所有 CRM 都使用相同路径或字段:
export BASE_URL='https://crm.example.com'
export TOKEN='测试账号令牌'
export RUN_ID="test-$(date +%Y%m%dT%H%M%S)"

curl -sS -X POST "${BASE_URL}/api/test-records" \
  -H "Authorization: Bearer ${TOKEN}" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: ${RUN_ID}" \
  -d "{\"external_id\":\"${RUN_ID}\",\"name\":\"performance-test\"}"
执行前应确认测试范围、备份状态、数据清理方式和回滚方案。不要直接对生产客户资料执行批量写入、覆盖或删除操作。测试完成后,应使用系统已有的测试数据清理流程;如果没有安全的清理机制,应停止扩大测试范围并由业务负责人确认处理方式。
故障恢复测试不能只记录“页面重新打开”。至少要记录四个时间点:
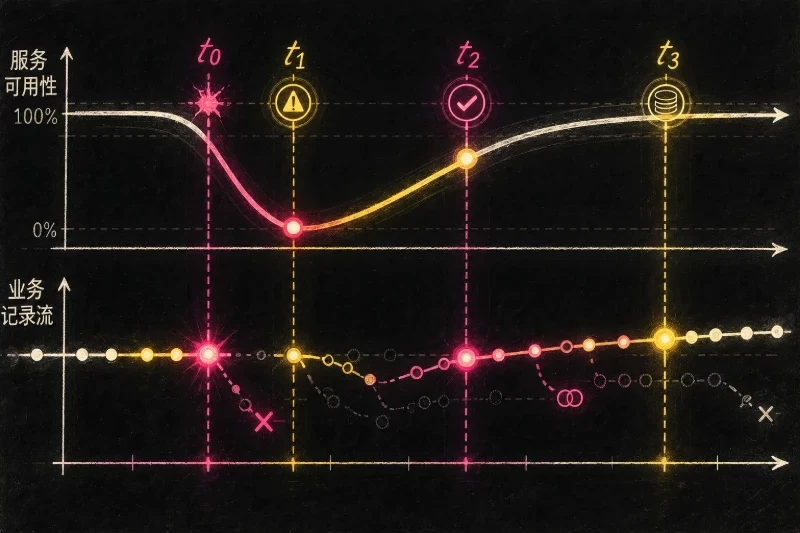
如果企业约定从故障发生开始计时,则:
RTO = t2 - t0
RPO = t0 - t3
若企业把告警时间定义为服务恢复计时起点,则必须在所有测试中统一使用该口径。RPO 不能只看备份任务显示成功,而要通过带时间和唯一编号的测试记录,验证恢复后实际存在的数据。
故障模型应分别测试,不能把所有故障合并成一次:
故障注入必须在预发布环境或批准的维护窗口进行,由现有变更流程执行。开始前确认备份可恢复、影响范围、原配置、回滚方案和业务联系人。不要直接在生产环境停止实例、断开数据库或修改防火墙来制造故障。
恢复后可以用以下方式连续验证健康检查和测试记录。路径需要替换为实际接口,不能假定所有系统都使用相同地址:
export BASE_URL='https://crm.example.com'
export RUN_ID='本次测试生成的唯一编号'

for i in $(seq 1 5); do
  date -Is
  curl -fsS --connect-timeout 5 --max-time 15 \
    "${BASE_URL}/healthz" >/dev/null || exit 1
  sleep 2
done

curl -fsS --connect-timeout 5 --max-time 15 \
  "${BASE_URL}/api/test-records/${RUN_ID}"
恢复成功至少应同时满足:
服务恢复很快但新增记录丢失,说明服务可用性与数据恢复能力不能混为一谈;数据没有丢失但队列长时间未清空,则还要单独记录业务恢复时间。
实际定位时,不要一看到高延迟就修改配置。按以下顺序可以减少误判:
核对节点、时间、应用版本、数据量、缓存状态、冷热连接和并发模型。查询条件不同、数据规模不同或一侧使用冷连接时,前后结果不能直接比较。
分别查看办公节点、实际远程办公节点和云内探针。如果只有一个节点异常,优先检查该节点的网络、终端和时间段;多个节点同时异常,再进入应用、数据库和云实例侧排查。
用请求编号或统一时间戳对齐客户端、网关、应用和数据库日志。网络阶段变慢,检查连接和传输;应用阶段变慢,检查接口逻辑、线程和队列;数据库阶段变慢,检查查询、锁等待、连接池和存储等待。
不要只看某个时刻的 CPU。并发、P95、P99、错误率、连接数、队列长度和存储等待需要一起观察。资源高位与延迟同步上升,更接近容量瓶颈;资源不高但延迟上升,则更像等待、锁、连接池或外部依赖问题。
一次同时调整连接池、超时、缓存和重试,会失去修复归因。应先提出一个假设,修改一个变量,再使用同一节点、同一数据和同一负载复测。
连接池、超时、重试和缓存调整可能改善正常请求,却加重恢复后的重连风暴或重复写入。因此性能复测通过后,仍要重新执行受控恢复演练。
“比之前快”不是充分的修复证据。修复后应尽量保持以下条件不变:
建议按这个顺序复测:
修复前后的记录可以采用同口径对比:
| 指标 | 修复前 | 修复后 | 是否同口径 | 解释 |
|---|---|---|---|---|
| 搜索接口 P95 | 实测值 | 实测值 | 是或否 | 是否达到业务目标 |
| 搜索接口 P99 | 实测值 | 实测值 | 是或否 | 尾部用户是否仍明显卡顿 |
| 写入成功率 | 实测值 | 实测值 | 是或否 | 是否存在重复或遗漏 |
| 峰值并发下错误率 | 实测值 | 实测值 | 是或否 | 是否仍有资源触顶 |
| 故障发现时间 | 实测值 | 实测值 | 是或否 | 告警是否及时 |
| 服务恢复时间 | 实测值 | 实测值 | 是或否 | 是否满足企业 RTO |
| 数据恢复点 | 实测值 | 实测值 | 是或否 | 是否满足企业 RPO |
| 恢复后队列清空时间 | 实测值 | 实测值 | 是或否 | 是否影响业务连续处理 |
如果 P50 变好而 P99 变差,说明典型请求改善的同时,尾部请求受到更大影响;如果恢复时间缩短但数据校验失败,应优先处理数据一致性,而不是追求更短的恢复数字。
当实际用户节点下的登录、搜索、写入和批量任务,在业务高峰和目标并发下都满足企业设定的延迟、成功率与一致性要求,同时故障恢复时间和数据恢复点也达标时,香港云服务器可以作为该跨境 CRM 系统的托管候选。
以下情况则不能直接判定为“适合”:
采购成本也应按同一测试口径记录,包括计算、存储、备份、监控、流量和故障演练等实际成本。没有经过核验的套餐、价格、库存或性能资料时,不能把这些变量写成确定承诺。企业应保留原始采样、错误日志、服务端指标、恢复时间线和修复后复测结果,使供应商交付验收与后续运维使用同一套判断标准。
这套方法只能对明确的测试节点、时间、应用版本、数据规模、并发模型和故障类型负责。它可以回答当前条件下是否达到企业业务目标,但不能把一次测试扩展成所有用户、所有时段或长期运行表现的保证。


