香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


恢复的目标不是把管理界面里的“Degraded”改成“Optimal”,而是在保住现有数据的前提下,恢复阵列可访问性、补足冗余,并确认文件系统和业务数据一致。阵列降级但仍在线时,通常应先限制写入、备份关键数据,再更换已确认故障的成员盘;阵列离线时,应先核对成员身份、控制器配置和故障数量,不能直接初始化、强制上线或重建。
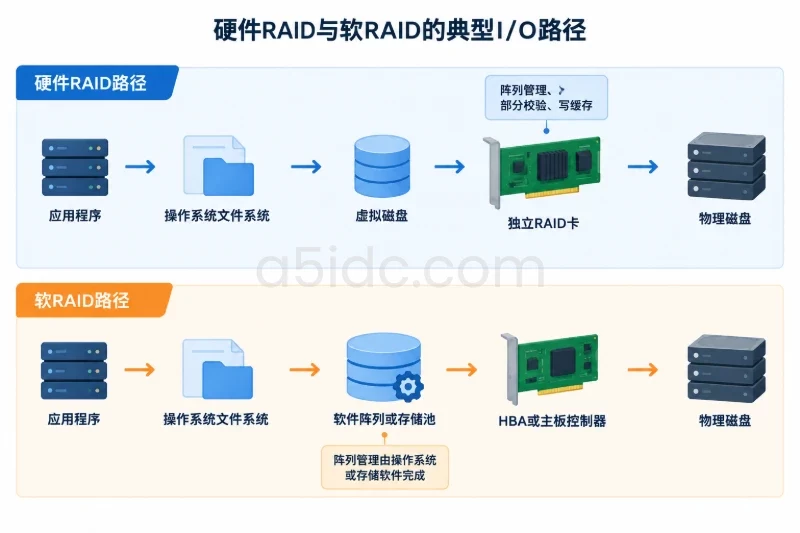
硬件 RAID 的恢复入口主要是控制器、物理盘和虚拟盘状态;Linux 软 RAID 的恢复入口主要是成员盘上的 RAID 元数据、mdadm 和内核状态。两者都要按故障等级处理:容量或文件系统问题不应触发换盘,单盘故障不应触发重建整个阵列,超过冗余能力或成员关系不明时,应转入镜像恢复或备份恢复流程。
软 RAID 操作以 Linux MD RAID、mdadm、ext4 或 XFS 为范围,不直接套用于其他存储实现。硬件 RAID 以带独立管理工具的阵列控制器为范围,具体写操作必须匹配控制器型号、固件和工具版本。
操作前,应具备以下条件:
备份不能只看“任务成功”。至少验证关键文件可读取、数据库备份可识别、恢复目标容量充足。同一阵列上的快照不能代替阵列故障场景下的独立备份。
若磁盘已经出现持续读错误,优先保全不可替代的数据,不要先运行全盘性能测试、长时间自检或高负载一致性扫描。
先弄清楚业务目录所在的设备链路:
业务目录 → 文件系统 → 逻辑卷或加密层 → RAID 设备 → 成员盘 → 槽位和序列号
在 Linux 中可先执行以下只读查询:
lsblk -o NAME,TYPE,SIZE,FSTYPE,UUID,MOUNTPOINT,MODEL,SERIAL
findmnt
df -hT
df -i
journalctl -k -b --no-pager -n 200
软 RAID 继续查看:
cat /proc/mdstat
mdadm --detail /dev/md0
这里的 /dev/md0 只是示例,必须替换为实际阵列设备。不要根据盘符猜测成员身份,/dev/sdb 在重新启动后可能对应另一块磁盘。
对于使用 StorCLI 管理的兼容控制器,可参考以下只读查询:
storcli /c0 show
storcli /c0/vall show all
storcli /c0/eall/sall show all
/c0 是示例控制器编号。先核对工具版本和控制器编号,再查看虚拟盘、物理盘、外来配置以及缓存保护状态。其他品牌应使用对应工具,不能混用变更命令。
记录结果应保存到外部管理终端或健康存储,不要只留在故障阵列上。
以下等级是运维处置分级,不是控制器厂商统一定义。
| 故障等级 | 典型状态 | 首要操作 | 禁止贸然执行的动作 |
|---|---|---|---|
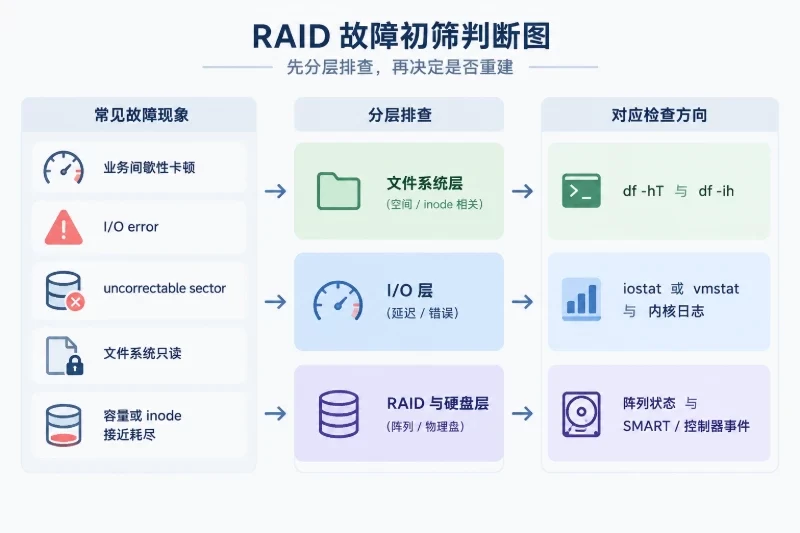
| L0:阵列健康,业务异常 | RAID 正常,但容量、inode、延迟或文件系统异常 | 定位阵列以上的故障层 | 无依据换盘、重建阵列 |
| L1:降级但仍在线 | 成员故障,数据仍可访问 | 保全数据,确认故障盘,恢复冗余 | 拔错盘、同时更换多个成员 |
| L2:离线,但可能具备恢复条件 | 控制器故障、成员暂时失联、配置未识别 | 恢复连接,核对配置,受控恢复访问 | 初始化、清除外来配置、强制组装 |
| L3:超过容错能力或成员关系不明 | 多盘损坏、源盘读错、元数据冲突 | 停止写入,镜像成员或恢复备份 | 反复通电、强制上线、原盘修复 |
容错能力必须结合布局判断:
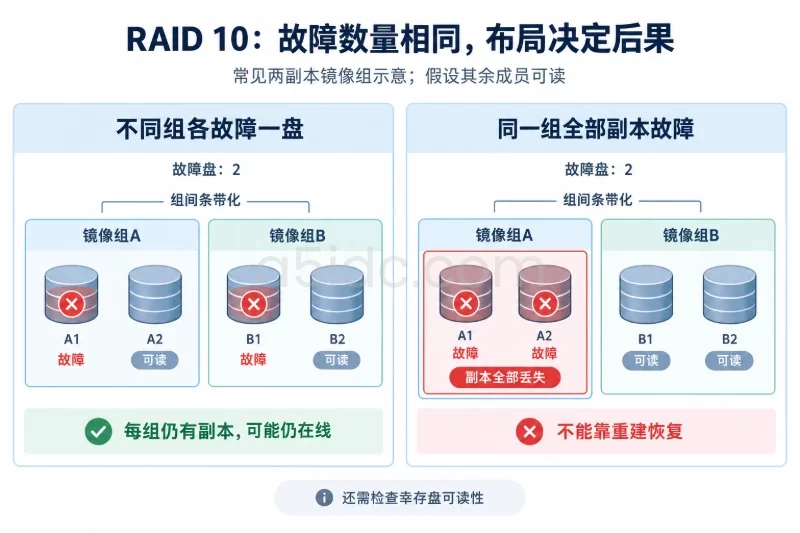
阵列离线不等于数据已经丢失,阵列降级也不等于可以安全继续生产。恢复决策应同时依据成员可读性、元数据一致性和备份可用性。
阵列显示正常时,不应直接按磁盘故障处理。先对比业务报错和系统状态。
| 检查结果 | 常见含义 | 下一步 |
|---|---|---|
df -hT 接近满容量 | 数据、日志或临时文件增长 | 找到增长来源,按保留策略迁移或清理 |
df -i 接近满值 | 小文件数量过多 | 排查缓存、会话、邮件或临时文件目录 |
| 删除文件后空间未释放 | 进程仍持有已删除文件 | 查找持有进程,安排其释放文件句柄 |
| 内核出现文件系统错误或只读重挂载 | 文件系统保护性停止写入 | 停业务,核验底层存储,再离线检查 |
| 阵列正常但延迟持续升高 | 重建、巡检、缓存策略或负载变化 | 对照控制器事件和 I/O 指标定位 |
确认阵列没有持续读错误后,可在对应挂载点内检查一级目录占用:
du -x -h --max-depth=1 /srv/data
该命令会遍历目录,不是零负载操作。大文件系统应避开业务高峰,不要对已经不稳定的阵列反复执行。
若系统已安装 lsof,可用以下命令检查仍被进程持有的已删除文件:
lsof +L1
不要直接截断数据库文件或活动日志。应先确认文件所属服务及轮转方式,再安排服务重新打开日志或受控重启;影响范围是对应业务,回退方式是恢复服务配置及必要的归档文件。
需要观察延迟时,可在已安装 sysstat 的系统中执行:
iostat -xz 1 5
结合 await、队列长度、吞吐量及业务负载判断,不用单个 %util 数值断言磁盘损坏。硬件 RAID 在操作系统中常表现为一个逻辑设备,成员盘错误还要回到控制器检查。
暂停批量导入、大规模日志回放等高写入任务。对仍可读的数据执行应用一致性备份;数据库应使用其支持的备份方式,而非直接复制活动数据文件。
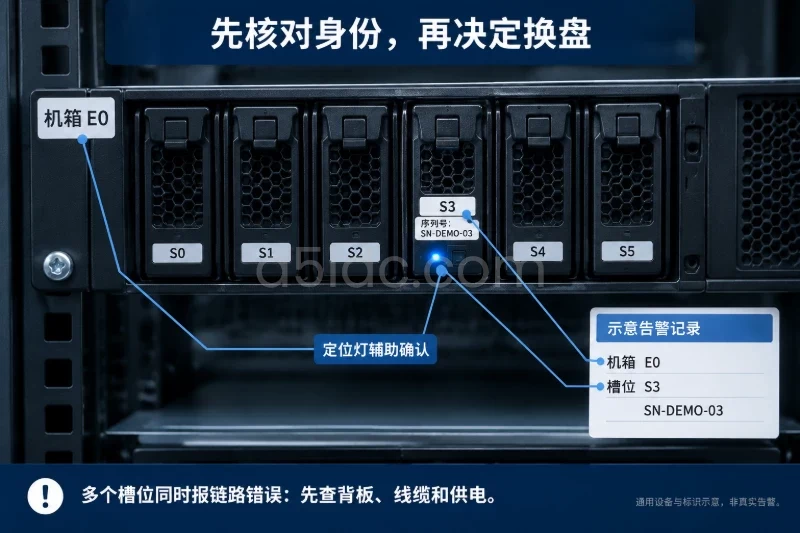
关联控制器告警中的机箱编号、槽位与序列号,再通过定位灯或现场标签确认。若多个槽位同时出现链路错误,应先检查背板、线缆和供电,不能将其全部判为磁盘损坏。
替换盘应满足控制器兼容要求,可用扇区数不小于原成员,扇区格式与现有阵列兼容。同样标称容量不代表实际可用扇区数相同。
仅在机箱、背板和控制器支持热插拔时在线换盘;不支持时按关机维护流程处理。提前确认插入新盘是否会自动触发重建,避免在数据尚未保全时启动高负载任务。
检查新盘是否被识别为可用盘、热备盘或重建成员。若出现外来配置,先核验其来源;旧阵列成员上的配置不能随意清除。
观察进度、读错误、掉盘、温度和业务延迟。重建时仍在使用的成员盘才是主要数据源,新盘不是“可覆盖旧盘”的恢复副本。
硬件 RAID 还应检查电池或闪存缓存保护状态。缓存保护失效后,控制器可能转为直写,造成明显性能变化;不要为追求速度强制开启未受保护的回写。控制器故障时若存在未落盘缓存,应保留原控制器及缓存模块,不能把“磁盘都在”当成可以直接重建配置的依据。
先用 mdadm --detail 确认阵列 UUID、级别、布局、成员数量及缺失位置。对还能识别的成员逐一查看元数据:
mdadm --examine /dev/disk/by-id/ata-MEMBER_SERIAL-part1
示例路径必须替换为实际成员分区。检查 Array UUID、Device Role、Events 和更新时间,但不能只凭 Events 最大就认定该成员完整可靠。
加入新盘前,应确认:
分区表复制属于写操作,可能覆盖目标盘。应另行核对目标序列号,避免重复磁盘或分区标识,本文不提供可盲目执行的整盘复制命令。
满足上述条件后,加入新成员的示例为:
mdadm --manage /dev/md0 --add /dev/disk/by-id/ata-REPLACEMENT_SERIAL-part1
该命令会向替换成员写入 RAID 元数据,并可能立即启动重建,覆盖该成员原有内容。 影响范围包括新盘以及重建期间的阵列性能。误加后不能靠简单拔盘恢复原内容,必须按当时阵列状态处置,并从原备份恢复被覆盖的数据。
随后观察:
cat /proc/mdstat
mdadm --detail /dev/md0
journalctl -k -b --no-pager -n 100
如果新盘仅成为备用盘,没有开始恢复预期缺失成员,应重新检查成员数、角色和容量,不要继续追加强制参数。
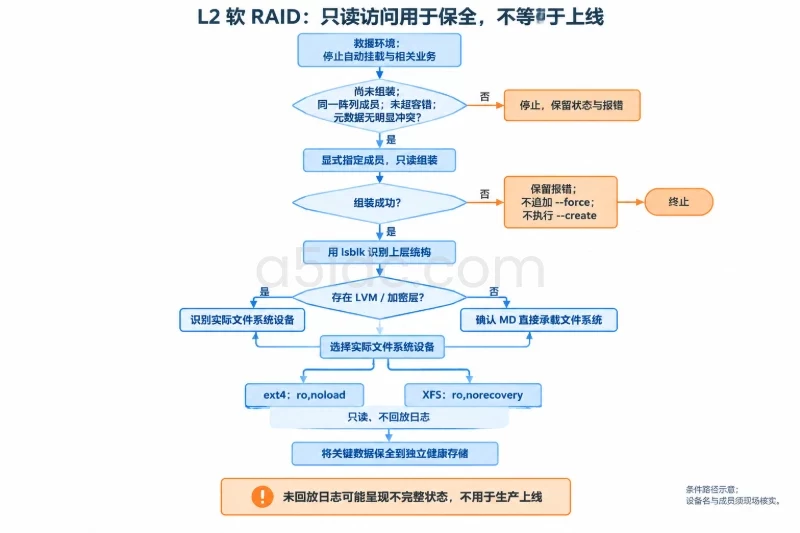
先停止自动挂载和相关业务。若涉及系统盘,在救援环境中操作,避免启动过程自动写入、组装或修复文件系统。
硬件 RAID 优先核对:
只有原成员集合、配置和缓存处理路径均已确认时,才按厂商对应流程导入外来配置或迁移控制器。导入后先确认虚拟盘容量、级别和状态,不要立刻启动业务。
“重新创建相同参数的虚拟盘”不是通用恢复方法。即使不做完整初始化,也可能改变元数据或映射;初始化更可能破坏原数据。
对于软 RAID,仅在已确认阵列尚未组装、成员来自同一阵列、未超过容错能力且元数据无明显冲突时,尝试显式指定成员只读组装。例如四成员 RAID 5 缺失一个成员的检查场景:
mdadm --assemble --readonly /dev/md/recovery \
  /dev/disk/by-id/ata-MEMBER_A-part1 \
  /dev/disk/by-id/ata-MEMBER_B-part1 \
  /dev/disk/by-id/ata-MEMBER_C-part1
这不是针对所有离线阵列的通用命令。若因脏状态、成员数量或元数据冲突拒绝启动,应保留报错并停止,不追加 --force、不执行 --create。
组装后先用 lsblk 确认上层结构。如果阵列之上还有 LVM 或加密层,必须识别实际文件系统设备,不能直接挂载 MD 设备。
对于已确认直接承载文件系统的设备,可在救援环境进行不回放日志的只读检查。挂载点 /mnt/recovery 应预先建立在健康存储上。
ext4 示例:
mount -t ext4 -o ro,noload /dev/md/recovery /mnt/recovery
XFS 示例:
mount -t xfs -o ro,norecovery /dev/md/recovery /mnt/recovery
禁止日志回放是为了避免检查过程修改原数据,但未回放日志的文件系统可能呈现不完整状态。此时只用于保全数据,不作为生产上线状态。
满足以下任一条件,应退出现场重建流程:
此时优先恢复独立备份。确需从原盘恢复,应逐盘制作受控镜像,记录坏块和读取过程,在镜像副本上分析。源盘状态恶化时,应由具备经验的人员决定读取顺序和重试策略,不进行反复全盘扫描。
将原 RAID 成员接入其他机器时,应使用能够可靠暴露原始成员数据且不会自动写入的访问方式。不要通过新建硬件 RAID 虚拟盘来“识别”旧成员。
硬件 RAID 应确认虚拟盘正常、成员在线、无未完成重建,并检查新错误和缓存策略。软 RAID 应确认活动成员数量符合配置,缺失标记消失,恢复或重同步已完成。
不能只看进度到达 100%。若之后再次掉盘,说明故障尚未消除;若剩余成员读错误增加,应先暂停上线验收。
重建时间可按有效进度速率估算。例如需要重建 8 TB 成员空间,有效速率为 150 MB/s,采用十进制单位:
8,000,000 MB ÷ 150 MB/s ≈ 53,333 秒,约 14.8 小时。
这只是连续稳定速率下的估算。业务竞争、读错误重试和控制器调度都会延长耗时,不应将估算值作为恢复承诺。
底层设备稳定后,才检查文件系统。以下只读检查应在文件系统卸载后执行,示例设备必须替换为实际文件系统设备:
e2fsck -fn /dev/mapper/vg_data-lv_data
xfs_repair -n /dev/mapper/vg_data-lv_data
两条命令分别用于 ext 系列和 XFS,不能混用。检查仍可能产生大量读取,建议优先在镜像或克隆上执行。XFS 若提示需要日志恢复,不能简单追加清除日志参数;应先保全数据,判断底层是否具备安全回放条件。
需要写入修复时,应先保存镜像或可验证备份,并明确可能丢失目录项、近期事务或文件内容。原盘修复没有可靠的一键撤销。
最后按顺序验证:
RAID 冗余恢复只证明成员关系恢复,不证明数据库事务或应用数据已经一致。
| 失败现象 | 优先排查 | 后续动作 |
|---|---|---|
| 换盘后仍不识别 | 槽位、背板、线缆、兼容性 | 保留原盘,核实链路,不盲目继续换盘 |
| 重建反复中断 | 源盘读错、掉链路、供电或温度异常 | 先保全数据,评估镜像或备份恢复 |
| 新盘容量不满足要求 | 可用扇区数、分区大小、扇区格式 | 使用符合条件的替换盘 |
| 软 RAID 拒绝组装 | UUID、角色、事件差异、阵列状态 | 保存元数据,在副本上分析 |
| 阵列在线但文件系统无法挂载 | 文件系统日志、上层映射、损坏 | 保全数据后离线检查,不先强制修复 |
| 重建后性能未恢复 | 缓存保护、后台任务、持续重试 | 核对事件及策略,不无依据修改缓存 |
| 磁盘空间再次耗尽 | 日志轮转、异常任务、保留策略 | 修复增长源,不以重复删除代替治理 |
多个磁盘同时掉线时,应检查共同故障点;单个成员重建过程中另一成员开始报读错时,应重新评级,而不是继续把它视为普通单盘故障。
只读检查通常可以通过卸载文件系统、停止临时阵列退出,但前提是没有业务使用它、没有上层映射占用,也没有恢复任务依赖它:
umount /mnt/recovery
mdadm --stop /dev/md/recovery
不要对生产中的 /dev/md0 直接照抄停止命令。若设备被占用,应先确认进程和上层设备,不强制卸载。
写操作的回滚应按影响范围区分:
| 已执行动作 | 回退方式与边界 |
|---|---|
| 停止业务或调整临时负载限制 | 恢复原配置,逐步启动并验证 |
| 加入新成员并启动重建 | 按当前阵列状态处理,不能靠插回旧盘撤销 |
| 导入硬件 RAID 配置 | 保留配置记录,依照兼容流程处置,不清配置“重试” |
| 修复文件系统或回放日志 | 从修复前镜像或备份恢复,通常无法简单撤销 |
| 初始化或覆盖成员数据 | 转入备份或专业数据恢复,不能承诺原盘可恢复 |
原故障盘可以保留为证据或恢复来源,但通常已不是可直接回插的回滚盘。阵列在故障后继续写入,旧盘上的数据可能已经过期。
需要恢复业务时,更可控的路径是在独立健康存储上恢复备份、完成验证,再切换业务。切换前保留原存储状态,并明确数据恢复时间点及之后的数据缺口。