

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


香港云服务器可以托管跨境 CRM 系统,但“适不适合”不能只看服务器所在地区或配置大小。判断依据应是:目标用户访问香港节点时的网络耗时、应用进程和线程是否耗尽、连接池是否排队、数据库连接是否成为瓶颈,以及 CPU、内存和磁盘等共享资源是否持续饱和。
当并发访问变慢时,优先不要直接扩大云服务器规格或盲目提高数据库连接池。应先把请求耗时拆成网络连接、Web 入口、应用队列、线程执行、连接池等待和数据库执行几个阶段。只有确认瓶颈所在层,再调整对应参数,才能避免“连接池变大了,数据库反而更慢”的情况。
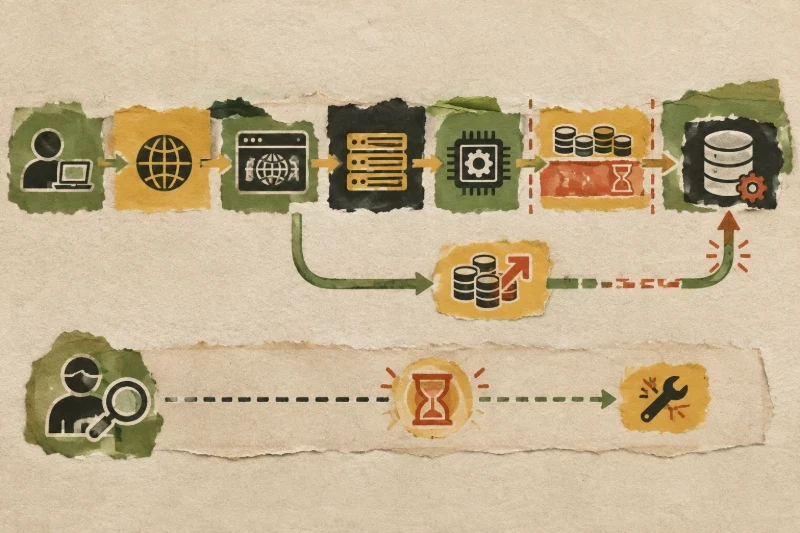
测试应尽量在预发布环境进行;如果只能在生产环境测试,应选择业务低峰期、只使用测试账号,并避开客户批量导入、批量发送、财务写入等不可逆操作。
至少固定以下条件:
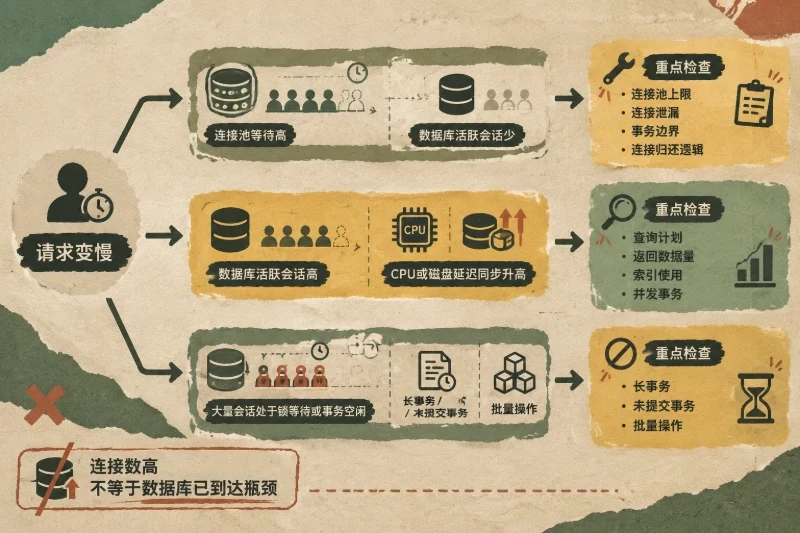
并发用户数不等于数据库连接数,也不等于应用线程数。一个用户请求可能在应用层等待线程,也可能在线程中等待数据库连接;数据库连接释放后,线程还可能继续等待锁、磁盘或其他外部资源。
先从实际访问位置发起一次受控请求,再从香港云服务器本机发起同一接口请求。接口应使用测试账号、只读数据和固定参数。
以下命令适用于 Linux 客户端或服务器,命令只读取请求耗时,不会修改业务数据:
curl -sS -o /dev/null \
  -w 'dns=%{time_namelookup} connect=%{time_connect} tls=%{time_appconnect} starttransfer=%{time_starttransfer} total=%{time_total} code=%{http_code}\n' \
  'https://crm.example.com/api/test-read'
预期结果是能够看到 DNS、TCP 连接、TLS、首字节和总耗时。如果从香港云服务器本机访问很快,而实际客户网络访问明显变慢,问题更可能出现在客户端到服务器之间的连接阶段;此时继续增大应用连接池不会改善首字节前的等待。
如果本机请求同样变慢,应继续检查 Web 入口、应用线程、队列和数据库。仅凭浏览器“转圈时间”无法判断是网络慢还是服务端处理慢。
可以使用已有的压测工具对只读接口进行阶梯测试。下面是示例命令,适用于已经安装 wrk 的 Linux 环境:
wrk -t2 -c20 -d60s --latency 'https://crm.example.com/api/test-read'
其中线程数、连接数和持续时间只是测试参数示例,应根据测试环境调整。不要直接对写接口使用这类命令,除非压测脚本已经实现唯一测试数据、清理机制和幂等控制。
建议逐级增加并发,每一级都记录:
| 观察项 | 需要记录的内容 | 主要用途 |
|---|---|---|
| 延迟 | 平均值、p50、p95、p99 | 判断是否只有少量慢请求,还是整体变慢 |
| 成功率 | HTTP 状态码、超时、连接失败 | 区分处理能力不足与业务错误 |
| 吞吐 | 每秒完成请求数 | 判断增加并发后是否仍有实际产出 |
| 应用 | 活跃线程、工作进程、请求队列 | 判断请求是否堵在应用层 |
| 连接池 | 使用中、空闲、等待数、获取连接耗时 | 判断线程是否等待数据库连接 |
| 数据库 | 活跃连接、锁等待、查询耗时、CPU 和磁盘 | 判断数据库是否是根因 |
| 主机 | CPU、内存、磁盘延迟、网络错误 | 排除共享资源争用 |
如果并发增加后吞吐基本不再增长,但p95和p99持续上升,通常表示某个共享资源已经排队。此时不应只看平均耗时,因为平均值可能掩盖队列中的长尾请求。
不同 CRM 应用可能采用多进程、多线程、异步事件循环或混合模型。需要先确认实际运行方式,而不是根据部署文档中的默认值猜测。
以下命令适用于 Linux,读取指定进程的线程数、CPU和内存使用情况:
ps -o pid,ppid,nlwp,stat,pcpu,pmem,etime,cmd -p
将 NLWP 和资源使用情况。
如果应用有多个工作进程,应分别查看:
ps -eo pid,ppid,nlwp,stat,pcpu,pmem,cmd --sort=-pcpu | head -n 20
结果解释如下:
如果系统安装了 sysstat,可以使用 pidstat 观察线程级别的变化:
pidstat -p -t 1 10
该命令适用于 Linux 服务器,只读取进程和线程统计。预期是看到各线程在连续采样期间的CPU使用和状态变化。
如果多数线程CPU使用较低,但请求延迟和应用队列同时上升,应重点查找等待点。常见等待包括:
如果多数线程都在计算,CPU也接近资源上限,则应先检查算法、序列化、权限查询和数据转换是否过重,再考虑增加工作进程。增加进程会带来更多内存占用,也可能使数据库连接需求成倍增加。
在 Linux 上可以查看监听端口:
sudo ss -lntp
该命令只读取套接字状态。需要关注应用监听端口对应的 Recv-Q 和 Send-Q:
Recv-Q 长时间较高,可能表示连接已经到达,但应用接受连接或处理连接的速度不足。Send-Q 通常反映监听队列上限,不能单独说明应用已经出现瓶颈。可以同时查看连接总量:
sudo ss -s
sudo ss -tanp | grep ':'
将
应用内部队列需要从应用指标或日志获得,重点不是“队列存在”,而是观察以下变化:
如果入队速率长期高于出队速率,队列必然增长。此时有三种常见分支:
不要把队列长度直接等同于吞吐能力。队列短但任务等待时间很长,可能是调度不及时;队列长但持续稳定出队,可能是业务峰值下的正常缓冲。应同时记录队列深度和最老任务年龄。
连接池至少应记录以下指标,具体名称以应用框架实际实现为准:
常见的判断组合如下:
| 现象 | 更可能的原因 | 不宜直接采取的措施 |
|---|---|---|
| 使用中连接长期达到上限,等待数和获取耗时上升,数据库并不繁忙 | 连接池偏小、连接未及时归还或事务持有过久 | 不要先把数据库最大连接数整体调大 |
| 连接池使用数不高,但请求仍慢,数据库查询耗时上升 | SQL、锁、磁盘或数据库内部资源问题 | 不要继续增加连接池 |
| 连接池连接数快速增加,数据库连接数接近上限 | 泄漏、重试风暴或多个应用实例总量失控 | 不要在生产环境直接提高数据库连接上限 |
| 连接池空闲较多,应用线程全忙 | 瓶颈在应用计算、锁、外部调用或队列 | 不要只调整连接池 |
| 连接获取耗时与数据库查询耗时都低,但整体请求仍慢 | 可能是网络、入口、序列化或其他共享资源 | 不要把问题归因于数据库 |
连接池总容量应按“实例数量 × 单实例池容量”计算,而不是只看单台应用服务器。如果部署了多个应用进程或多个容器,每个实例都拥有独立连接池,数据库实际承受的是所有实例连接数之和。
数据库侧检查应采用只读查询,并控制执行频率。不要在高负载时反复刷新全量进程列表。
MySQL 或 MariaDB 环境可以先确认版本和线程状态:
SELECT VERSION();

SHOW GLOBAL STATUS LIKE 'Threads_connected';
SHOW GLOBAL STATUS LIKE 'Threads_running';
SHOW FULL PROCESSLIST;
这些语句用于观察当前连接数、正在执行的线程和连接状态。若 Threads_connected 很高但 Threads_running 较低,可能是连接池保留连接较多、空闲连接过多或连接没有及时释放;若 Threads_running 持续较高,还要继续查看慢查询、锁等待和磁盘资源。
PostgreSQL 环境可以使用以下只读查询:
SELECT version();

SELECT
    state,
    wait_event_type,
    wait_event,
    count(*) AS connection_count
FROM pg_stat_activity
GROUP BY state, wait_event_type, wait_event
ORDER BY connection_count DESC;
如果数据库权限不足,查询可能无法看到其他会话,此时应由数据库管理员提供聚合后的连接和等待指标,不要为了排查临时扩大权限范围。
需要区分三种状态:
对慢查询进行优化时,应先在预发布环境或数据库副本上使用执行计划分析。涉及索引、表结构和参数的变更,要先备份配置及变更脚本,确认回滚方式,再安排低峰期执行。没有确认数据库类型、版本和表结构时,不应直接给生产库执行修改表结构的命令。
应用、连接池和数据库都正常时,还要检查香港云服务器本身的共享资源。以下命令适用于 Linux,只读取系统指标:
vmstat 1 10
重点观察运行队列、空闲CPU、内存回收和交换活动。如果内存不足并触发交换,应用线程可能表现为“线程很多但处理很慢”。
如果系统安装了 iostat,继续执行:
iostat -xz 1 10
重点看磁盘利用率、平均等待时间和队列变化。数据库查询变慢、应用日志写入阻塞、备份任务与正式请求争用,都可能表现为磁盘等待升高。
还可以查看CPU被虚拟化平台占用的时间:
top
在输出中观察 %st。该指标持续升高并且与请求p95同步上升时,说明虚拟化环境中的计算资源争用值得关注。此时应结合云平台监控确认,而不是立即修改应用线程数。
这些命令不会修改系统配置,不需要回滚。如果发现磁盘、内存或CPU持续接近资源上限,先停止非必要的压测和批处理任务;不要在压力测试仍运行时直接重启应用或数据库,否则会把资源瓶颈和重启影响混在一起。
排查结果可以按以下顺序处理:
如果客户端请求慢,但香港云服务器本机访问同一接口很快,先分离客户端连接耗时和服务端处理耗时。保持应用、连接池和数据库配置不变,重新从多个实际客户访问位置进行对照测试。
如果入口连接正常、服务器本地请求也慢,再检查应用和数据库;不要因为客户端连接慢就增大数据库连接池。
如果工作线程全部忙碌、队列增长、数据库连接池仍有余量,优先检查同步计算、锁、序列化和外部调用。
调整工作进程或线程数前,应备份当前配置,记录旧值,并确认内存和数据库连接预算。修改后先进行配置校验,再滚动发布或按应用支持的方式重载。若错误率、内存占用或数据库连接数上升,立即恢复旧配置并停止扩容测试。
如果连接池等待时间占据请求总耗时,而数据库本身还有处理余量,可小幅调整池容量,并同时检查连接是否按时归还、事务是否过长。
每次只改一个变量,保留旧配置作为回滚值。应用重启可能中断已有请求,应提前安排维护窗口或采用应用支持的平滑发布方式。调整后必须观察数据库总连接数,确认没有因多个实例叠加而超过数据库承载范围。
如果数据库CPU、磁盘、锁等待或慢查询与请求延迟同步上升,应优先优化查询、缩小返回数据量、缩短事务和拆分批处理。此时提高连接池通常只会增加并发查询和锁竞争。
数据库参数、索引和表结构调整应先在接近生产的数据集上验证,并保存变更前配置、执行计划和回滚脚本。生产变更完成后,至少复查错误率、锁等待、连接数、查询耗时和业务结果正确性。
如果CPU、内存或磁盘成为瓶颈,应先确认是哪类任务占用资源,例如报表、日志、备份或批量同步。可以在测试窗口停止非必要任务后复测,判断资源释放是否带来改善。
如果停止后台任务后延迟恢复,而连接池和数据库指标没有明显变化,说明并发瓶颈可能来自共享资源争用。此时调整应用线程或数据库连接不会解决根因。
复测必须尽量保持原测试条件,包括相同接口、数据规模、账号权限、并发阶梯、持续时间和监控采样方式。否则即使结果变好,也无法确认是修复有效还是测试负载变化。
建议按以下顺序复测:
可以将一次复测判定为有效的条件设为:目标接口功能正确;错误率没有因调参上升;长尾延迟在相同负载下改善;连接池等待、应用队列或数据库等待至少有一项与修复目标一致地下降;同时没有把压力转移到另一个层级。
例如,连接池调大后p95下降,但数据库锁等待和CPU明显上升,说明只是把等待从应用层转移到了数据库层,不能视为真正解决。相反,如果连接获取等待下降、数据库活跃连接仍在可控范围、查询耗时未恶化,才说明该调整在当前负载下成立。
香港云服务器是否适合继续托管跨境 CRM,最终应以持续监控结果判断,而不是一次压测结果。至少保留以下监控:
当用户访问变慢时,先用服务器本地请求与实际访问请求做对照,再按“入口—应用进程和线程—应用队列—连接池—数据库—共享资源”的顺序核对。只要能够证明慢点位于可控制的应用或数据库资源,并且复测后长尾延迟、错误率和连接等待均得到改善,香港云服务器就可以作为该 CRM 系统的托管环境;如果瓶颈始终发生在用户到服务器的连接阶段,则应单独评估实际访问体验,不能用应用层扩容替代网络侧验证。


