

香港特惠服务器
三网CN2带宽,提供30M至100M大带宽,保障CN2/CMIN2/CU/PCCW四大运营商线路稳定接入


多语言外贸网站部署到海外后,接口变慢不一定是MySQL执行慢:请求可能先在应用连接池中排队,也可能SQL执行很快、但应用与数据库之间的往返或结果传输耗时较长。排查时应分别记录“获取连接耗时、SQL执行耗时、接口总耗时”,先用执行计划处理确有问题的查询,再依据连接池等待和数据库并发调整池大小。
规划海外部署节点和访问线路时,数据库排查的关键是核实应用到数据库的实际访问路径和耗时,而不是仅凭访客所在位置推断数据库性能。应用与数据库之间的网络往返会影响接口总耗时,但不会因为增加索引或连接数而消失。以下步骤适用于 Linux、systemd、MySQL 8.0、InnoDB;应用框架的连接池参数名称可能不同,应按其文档映射对应设置。
开始前应确认:
performance_schema 统计信息。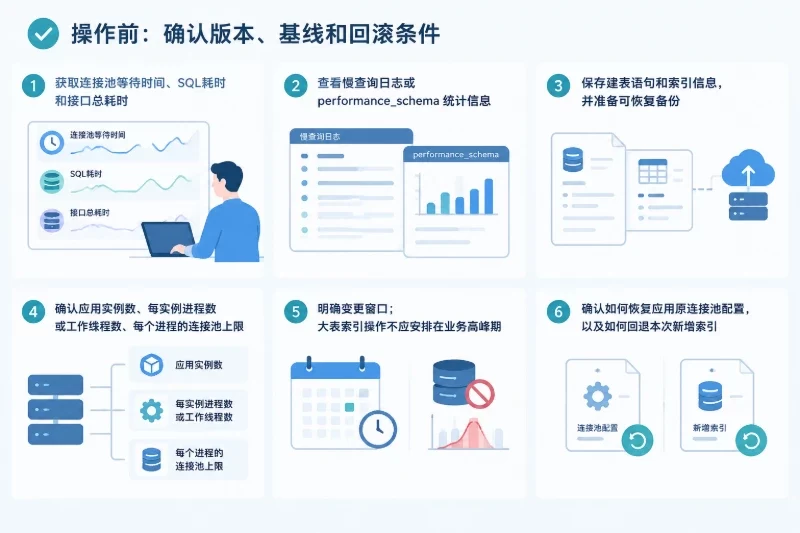
图示对应原文命令:performance_schema。
在 Linux 终端核验客户端版本:
mysql --version
在 MySQL 中核验服务端版本、表引擎和关键参数:
SELECT VERSION(), @@version_comment;

SHOW TABLE STATUS LIKE 'article'\G

SHOW GLOBAL VARIABLES
WHERE Variable_name IN (
  'max_connections',
  'wait_timeout',
  'interactive_timeout',
  'slow_query_log',
  'slow_query_log_file',
  'long_query_time'
);
article 应替换为实际表名。若表不是 InnoDB,或服务端不是 MySQL 8.0,应先核对当前版本对后续DDL、不可见索引和执行计划命令的支持情况,不要直接照搬操作。
保存变更前的表结构和索引:
SHOW CREATE TABLE article\G
SHOW INDEX FROM article;
这些语句用于读取元数据。正式修改前仍需依照数据库规模和运维流程完成备份;不要在高峰期临时执行可能造成额外读写负载的大规模备份。
应用侧至少记录三个时间点:从连接池申请连接到拿到连接、从SQL发送到收到数据库结果、收到结果到接口响应完成。同时记录池内已用和空闲连接数、等待线程数及超时次数。
| 观察结果 | 更可能的原因 | 下一步 |
|---|---|---|
| 获取连接等待变长,SQL执行耗时没有同步上升 | 池耗尽、连接未归还或事务持有连接过久 | 检查连接释放、事务边界和池上限 |
| 获取连接很快,SQL耗时和扫描行数偏高 | 索引不合适、SQL不能有效使用索引或查询范围过大 | 查看慢查询和 EXPLAIN |
| SQL耗时不高,但接口仍慢 | 应用处理、结果集传输或应用到数据库的网络往返耗时 | 单独测量各阶段,检查返回数据量 |
Threads_connected 高而 Threads_running 低 | 空闲连接过多或池上限设置过大 | 核对各进程连接池配置,不要先增大数据库连接上限 |
Threads_running 持续较高,CPU或磁盘读压力也升高 | 同时执行的SQL较多、单条SQL过慢或事务争用 | 先处理高耗时SQL,再评估并发 |
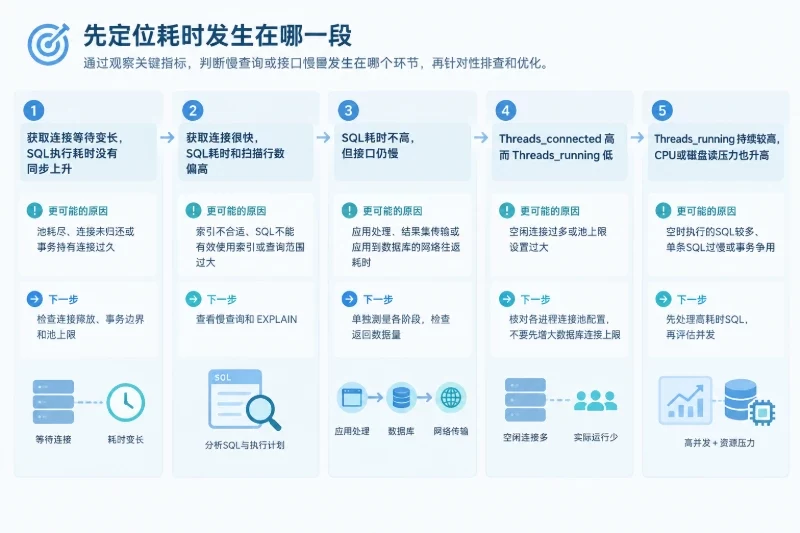
图示对应原文命令:EXPLAIN。
Threads_connected 是已建立连接数,Threads_running 是当前正在工作的线程数。连接数高不等于数据库正在高负载运行,两者应结合SQL耗时和系统资源观察。
先记录慢查询配置原值:
SHOW GLOBAL VARIABLES
WHERE Variable_name IN (
  'slow_query_log',
  'slow_query_log_file',
  'long_query_time',
  'log_queries_not_using_indexes'
);
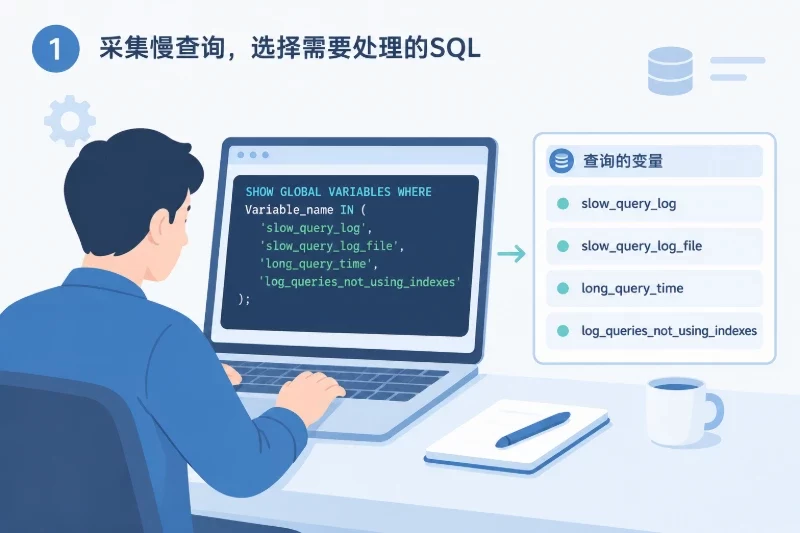
如果慢查询日志未开启,可在确认磁盘空间和变更时段后临时启用。下面以 1 秒为示例阈值,实际值应依据接口目标、现有基线和日志量确定:
SET GLOBAL slow_query_log = ON;
SET GLOBAL long_query_time = 1;
调整全局阈值会影响后续新建的会话;需要验证实际记录效果,并按数据库当前版本确认会话变量行为。阈值过低会增加日志写入和磁盘占用。不要在缺少磁盘监控时长期使用过低阈值;log_queries_not_using_indexes 也不宜不加评估地长期开启,因为小表全表扫描不一定是问题,日志可能迅速增加。
查询日志路径后,在 Linux 上可用 mysqldumpslow 初步归类:
SHOW GLOBAL VARIABLES LIKE 'slow_query_log_file';
sudo mysqldumpslow -s t -t 20 /path/to/mysql-slow.log
将示例路径替换为实际查询结果。该命令只读取日志;执行账号需有读取该文件的权限。
如果 performance_schema 已启用,可按SQL摘要查看耗时和扫描量:
SELECT
    SCHEMA_NAME,
    DIGEST_TEXT,
    COUNT_STAR,
    ROUND(AVG_TIMER_WAIT / 1000000000000, 6) AS avg_seconds,
    ROUND(MAX_TIMER_WAIT / 1000000000000, 6) AS max_seconds,
    SUM_ROWS_EXAMINED,
    SUM_ROWS_SENT
FROM performance_schema.events_statements_summary_by_digest
WHERE SCHEMA_NAME = 'appdb'
ORDER BY SUM_TIMER_WAIT DESC
LIMIT 20;
将 appdb 替换为实际数据库名。扫描行数远高于返回行数,通常值得检查索引;调用次数很高但单次耗时不大,可能是重复读取,可在SQL稳定后再评估缓存;最大耗时显著高于平均耗时,则应进一步排查参数分布、锁等待或偶发资源争用。统计信息是聚合结果,不能单独证明某条SQL一定缺少索引,应结合具体参数和执行计划判断。
以多语言内容表为例,业务需要按站点、语言和发布状态筛选文章,并按发布时间倒序读取:
SELECT id, title, slug
FROM article
WHERE site_id = 12
  AND locale = 'en-US'
  AND status = 'published'
ORDER BY published_at DESC, id DESC
LIMIT 20;
先查看已有索引,再检查执行计划:
SHOW INDEX FROM article;
EXPLAIN
SELECT id, title, slug
FROM article
WHERE site_id = 12
  AND locale = 'en-US'
  AND status = 'published'
ORDER BY published_at DESC, id DESC
LIMIT 20;
重点核对 key 实际选择了哪个索引、possible_keys 是否列出候选索引、rows 估算扫描行数,以及 Extra 是否提示额外排序或临时表。type 显示全表扫描时也不能立即判定为故障:小表上全表扫描可能比走索引更便宜。还应检查比较字段的数据类型、字符集和表达式,隐式转换或对索引列套函数都可能影响索引使用。
对于示例查询,可评估如下联合索引:
(site_id, locale, status, published_at, id)
其依据是先放等值过滤列,再放排序相关列;是否有效必须由实际执行计划验证。范围条件可能影响后续索引列的使用方式;查询若不固定按语言筛选,locale 是否应纳入索引也需重新评估。联合索引还应与已有索引的最左前缀对照,避免重复或高度重叠。索引越宽,写入开销和存储占用越高,不宜为了覆盖全部返回列而无限扩展。
MySQL 8.0 可在测试环境或受控的只读查询上使用 EXPLAIN ANALYZE:
EXPLAIN ANALYZE
SELECT id, title, slug
FROM article
WHERE site_id = 12
  AND locale = 'en-US'
  AND status = 'published'
ORDER BY published_at DESC, id DESC
LIMIT 20;
该命令会实际执行查询,可能读取大量数据。不要在高峰期对大范围查询使用,也不要对生产环境的更新或删除语句使用。
确认目标表、字段及索引不存在重复后,才考虑创建索引:
ALTER TABLE article
  ADD INDEX idx_article_site_locale_status_pub_id
  (site_id, locale, status, published_at, id),
  ALGORITHM=INPLACE,
  LOCK=NONE;
ALGORITHM=INPLACE 和 LOCK=NONE 仅在当前版本及操作条件支持时适用;它们不代表操作完全没有业务影响。创建索引会消耗读写资源,且可能受到元数据锁、磁盘空间和版本限制影响。可在同一管理连接中先设置较短的元数据锁等待时间,再执行DDL:
SET SESSION lock_wait_timeout = 5;
如果DDL因锁等待超时,不要循环重试。先查看会话状态:
SHOW FULL PROCESSLIST;
确认锁占用情况、资源余量和变更时段后,再决定是否取消并改期。索引创建成功后,用原查询重新执行 EXPLAIN,并在相同参数下比较扫描行数和实际耗时。若计划没有改善,应检查索引顺序、字段类型、隐式转换、函数调用、统计信息和参数分布,而不是继续堆叠索引。
例如,对时间列使用 DATE()、对字符串列使用 LOWER(),或使用前置通配符,都可能使普通索引难以有效发挥作用:
-- 时间列套函数
WHERE DATE(published_at) = '2026-09-27'

-- 字符串列套函数
WHERE LOWER(slug) = 'sample-page'

-- 前置通配符
WHERE slug LIKE '%sample%'
按日期筛选时,可改为明确的起止范围,并结合业务时区核对边界:
WHERE published_at >= '2026-09-27 00:00:00'
  AND published_at <  '2026-09-28 00:00:00'
改写后仍需用实际执行计划验证,不能仅凭SQL形式判断优化已经生效。
连接池复用连接并限制应用并发,不能代替索引;单条SQL变慢时,单纯增大池上限可能让更多慢查询同时进入数据库。先查看MySQL连接状态:
SHOW GLOBAL STATUS
WHERE Variable_name IN (
  'Threads_connected',
  'Threads_running',
  'Max_used_connections',
  'Threads_created',
  'Aborted_connects'
);
估算应用连接上限时,可按以下关系核对:
应用连接上限估算值
≈ 应用实例数 × 每实例进程数或工作线程数 × 每进程连接池上限
这是连接数估算,不是每秒请求数,也不是数据库承载能力公式。连接池连接数不能直接替代请求速率;请求并发和SQL执行时长还会影响实际同时占用的连接数量。估算总连接时还要为管理连接、后台任务、监控程序及其他应用预留空间,不能将所有应用池上限简单配置到接近 max_connections。
调整前逐项核对应用连接池参数:
| 参数 | 判断依据 |
|---|---|
| 最大连接数 | 结合应用并发、SQL耗时和数据库资源;扩大前先排除慢SQL和连接泄漏 |
| 最小空闲连接数 | 结合启动流量是否集中,避免多个进程同时建立过多连接 |
| 获取连接超时时间 | 应与接口超时和故障处理时间相匹配;它不等于SQL执行超时 |
| 空闲连接回收时间 | 结合数据库及相关基础设施的空闲连接策略 |
| 连接最大生命周期 | 不超过基础设施允许的连接生命周期 |
| 连接泄漏检测 | 可用于测试和排障;生产启用前评估日志量 |
每次借用连接都应通过 try/finally、上下文管理器或框架的自动归还机制释放。不要持有连接等待外部服务、远程文件或长时间模板渲染;事务只应包围必要的数据库操作。多进程应用要逐进程核对池配置。调整时一次只改一个方向,并先在一个应用实例上观察。
如果连接池等待变长而 Threads_running 也高,优先回查慢查询和事务;若 Threads_connected 接近连接上限而 Threads_running 长期较低,则检查空闲连接过多、连接泄漏或池配置过大。只有在确认SQL效率、连接归还和资源余量后,才考虑调整池上限。Too many connections 出现时,直接提高 max_connections 可能只是扩大资源风险,不能替代对应用总池上限的核算。
缓存只适合减少稳定且重复的读取,不能修复写查询、后台任务或缓存未命中的慢查询。只有在SQL和索引已验证后,才评估缓存;缓存键应区分站点、语言、内容标识及影响结果的筛选条件,内容发布、修改和下线时应有失效策略。若缓存命中率低、失效频繁或一致性无法保障,应撤销缓存改动并回到数据库查询验证。
索引或连接池调整后,应在可比的流量条件下观察一个完整业务周期,而不是只比较单个瞬时值。可查询以下状态:
SHOW GLOBAL STATUS
WHERE Variable_name IN (
  'Threads_connected',
  'Threads_running',
  'Max_used_connections',
  'Created_tmp_tables',
  'Created_tmp_disk_tables',
  'Innodb_buffer_pool_reads',
  'Innodb_buffer_pool_read_requests'
);
Threads_running 持续升高时应检查并发SQL和事务;磁盘临时表增长较快时,应结合排序、分组及结果集大小排查;缓冲池物理读取相对逻辑读取增长较快,说明部分数据需要从磁盘读取,但不能单凭这一项判断必须增加内存;Max_used_connections 接近上限时,要先分辨是连接泄漏、池上限过大还是业务并发变化。
Linux 上可用以下只读命令观察系统统计:
vmstat 1 5
iostat -xz 1 5
iostat 通常由 sysstat 软件包提供。若SQL执行耗时稳定而接口仍慢,应继续核对连接获取、应用处理、结果集传输和应用到数据库之间的往返耗时,不要用新增索引或扩大连接数处理并非SQL执行造成的延迟。
常见失败应按低风险方式处理:
ANALYZE TABLE article;,随后重新运行 EXPLAIN。该操作可能消耗资源,避免与大规模写入或索引创建同时进行。SHOW FULL PROCESSLIST; 查看会话和锁等待,不要终止未知会话;确认属于本次变更且符合运维流程后再处理。不要反复执行相同DDL。验收应同时确认:相同查询参数下执行计划合理;扫描行数或SQL耗时有可重复的改善;应用连接池等待没有因盲目提高并发而加重;连接峰值留有管理和其他任务所需余量;多语言页面的站点、语言和状态筛选结果正确;数据库错误率、系统资源和慢查询日志量没有持续恶化。
回滚时按变更类型处理:
   ALTER TABLE article
     ALTER INDEX idx_article_site_locale_status_pub_id INVISIBLE;
若版本不支持不可见索引,应依据保存的表结构和变更记录,在维护窗口删除本次新增索引:
   ALTER TABLE article
     DROP INDEX idx_article_site_locale_status_pub_id;
删除前须确认没有其他SQL依赖该索引,并评估DDL的资源消耗和元数据锁影响。
long_query_time 和日志开关状态。以下仅为命令形式示例,数值和开关必须替换为实际保存的原值: SET GLOBAL long_query_time = 10;
SET GLOBAL slow_query_log = OFF;
最终检查应确认SQL、连接池和接口耗时分别有记录,索引变更可验证且可回退,连接总量没有挤占管理和其他任务的空间。海外部署场景下,如果数据库执行耗时已稳定而接口仍慢,应把剩余耗时定位到连接获取、网络往返、结果传输或应用处理环节;此时继续增加索引或连接数并不能证明问题已解决。


