香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


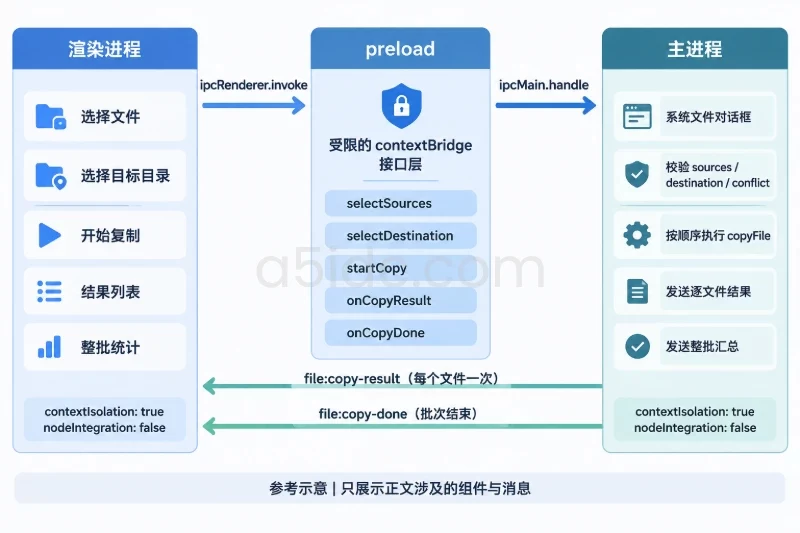
批量复制时,真正需要接好的不是一次调用文件系统 API,而是“文件处理完成”与“界面状态更新”之间的协作。主进程负责访问本地路径并逐个执行复制,预加载脚本只暴露有限的文件操作接口,渲染进程则根据每个文件返回的结果更新列表。这样即使其中一个文件失败,其他文件仍可以继续处理,界面也能立即显示成功、跳过或失败状态。
下面以“选择多个普通文件,复制到一个目标目录,并处理同名文件”为例。示例使用 Electron 主进程、preload、contextBridge、ipcMain.handle、ipcRenderer.invoke 和 Node.js 的 fs.promises.copyFile,不依赖第三方复制库。
文件管理工具中的“批量复制”至少要明确三个问题:
当前示例只处理普通文件。用户通过系统文件选择框选中文件,再选择一个目标目录,程序按照选择顺序逐个处理。目录、快捷方式和符号链接不会被当成普通文件直接复制。
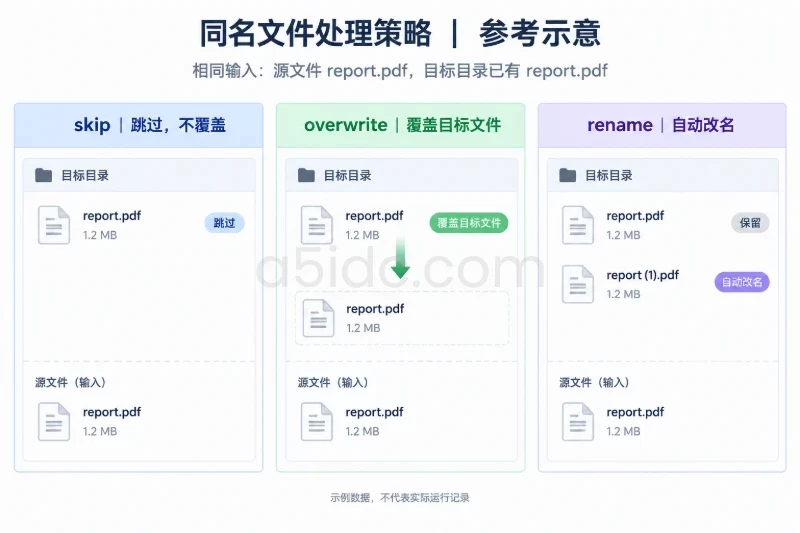
同名文件提供三种策略:
| 策略值 | 处理方式 | 适合场景 |
|---|---|---|
skip | 目标已存在时跳过,不覆盖 | 默认保护目标目录中的已有文件 |
overwrite | 目标已存在时覆盖 | 用户明确要求以源文件替换目标文件 |
rename | 自动生成新的文件名,例如 report (1).pdf | 希望保留两份文件 |
每个文件都会产生一条独立结果,结果结构可以统一为下面的形式:
| 字段 | 说明 |
|---|---|
jobId | 当前批次的标识,用于过滤旧任务的事件 |
index | 文件在源列表中的位置,从 0 开始 |
source | 源文件路径 |
target | 实际目标路径,失败时可能为空 |
status | copied、skipped 或 failed |
bytes | 本次目标文件的字节数,跳过和失败通常为 0 |
elapsedMs | 当前文件的处理耗时 |
code | 失败时的错误代码 |
message | 面向界面的说明信息 |
这里的结果表示“一个文件是否已经处理完成”,不是文件内部的百分比进度。fs.promises.copyFile() 会在文件复制完成或发生错误后返回。如果还需要显示一个大文件从 0% 到 100% 的进度,就需要改用读写流并按已写入字节数发送进度事件。
在开启 contextIsolation 且关闭 nodeIntegration 的 Electron 应用中,渲染进程不应该直接调用 Node.js 文件系统 API。系统文件对话框和实际复制操作放在主进程中,既符合 Electron 的进程边界,也便于集中处理权限、路径和异常。
下面是一个可直接作为 main.js 基础版本的示例。它会:
file:copy-result 逐个发送结果;file:copy-done 发送整批汇总;COPYFILE_EXCL 避免 skip 和 rename 策略意外覆盖文件。const { app, BrowserWindow, dialog, ipcMain } = require('electron');
const path = require('node:path');
const fs = require('node:fs/promises');
const { constants } = require('node:fs');
const { randomUUID } = require('node:crypto');
const CONFLICT_POLICIES = new Set(['skip', 'overwrite', 'rename']);
function makeError(message, code = 'APP_ERROR') {
const error = new Error(message);
error.code = code;
return error;
}
function getErrorInfo(error) {
return {
code: error?.code || 'UNKNOWN_ERROR',
message: error?.message || '未知错误'
};
}
function renamedCandidate(basePath, index) {
const parsed = path.parse(basePath);
if (parsed.ext) {
return path.join(
parsed.dir,
`${parsed.name} (${index})${parsed.ext}`
);
}
return path.join(
parsed.dir,
`${parsed.base} (${index})`
);
}
async function isSameFile(source, target) {
try {
const [sourceRealPath, targetRealPath] = await Promise.all([
fs.realpath(source),
fs.realpath(target)
]);
return sourceRealPath === targetRealPath;
} catch (error) {
if (error.code === 'ENOENT') {
return false;
}
throw error;
}
}
async function rejectSymlinkTarget(target) {
try {
const targetStat = await fs.lstat(target);
if (targetStat.isSymbolicLink()) {
throw makeError(
'目标路径是符号链接,为避免误写入其他位置,已停止覆盖',
'SYMLINK_TARGET'
);
}
} catch (error) {
if (error.code !== 'ENOENT') {
throw error;
}
}
}
async function copyOneFile(source, destinationDir, conflict) {
const sourceStat = await fs.lstat(source);
if (!sourceStat.isFile()) {
throw makeError(
'当前示例只支持普通文件,不支持目录或符号链接',
'UNSUPPORTED_FILE'
);
}
const baseTarget = path.join(destinationDir, path.basename(source));
let target = baseTarget;
if (conflict === 'overwrite') {
await rejectSymlinkTarget(target);
if (await isSameFile(source, target)) {
throw makeError(
'源文件和目标文件是同一个文件,不能覆盖自身',
'SAME_FILE'
);
}
await fs.copyFile(source, target);
} else if (conflict === 'skip') {
try {
await fs.copyFile(
source,
target,
constants.COPYFILE_EXCL
);
} catch (error) {
if (error.code === 'EEXIST') {
return {
status: 'skipped',
target,
bytes: 0,
message: '目标文件已存在,已跳过'
};
}
throw error;
}
} else {
let copied = false;
for (let index = 1; index <= 10000; index += 1) {
target = renamedCandidate(baseTarget, index);
try {
await fs.copyFile(
source,
target,
constants.COPYFILE_EXCL
);
copied = true;
break;
} catch (error) {
if (error.code !== 'EEXIST') {
throw error;
}
}
}
if (!copied) {
throw makeError(
'连续生成可用文件名失败,已停止处理该文件',
'NAME_CONFLICT'
);
}
}
const targetStat = await fs.stat(target);
return {
status: 'copied',
target,
bytes: targetStat.size,
message: target === baseTarget
? '复制完成'
: '目标已存在,已改名复制'
};
}
function sendToRenderer(sender, channel, payload) {
if (!sender.isDestroyed()) {
sender.send(channel, payload);
}
}
async function copyBatch(event, payload) {
const {
jobId,
sources,
destination,
conflict = 'skip'
} = payload || {};
if (typeof jobId !== 'string' || jobId.length === 0) {
throw makeError('缺少批次标识', 'INVALID_JOB_ID');
}
if (
!Array.isArray(sources) ||
sources.length === 0 ||
sources.some((item) => typeof item !== 'string' || item.length === 0)
) {
throw makeError('源文件列表为空或包含无效路径', 'INVALID_SOURCES');
}
if (typeof destination !== 'string' || destination.length === 0) {
throw makeError('缺少目标目录', 'INVALID_DESTINATION');
}
if (!CONFLICT_POLICIES.has(conflict)) {
throw makeError('不支持的同名文件处理策略', 'INVALID_CONFLICT');
}
const destinationStat = await fs.stat(destination);
if (!destinationStat.isDirectory()) {
throw makeError('目标路径不是目录', 'DESTINATION_NOT_DIRECTORY');
}
const summary = {
jobId,
total: sources.length,
completed: 0,
copied: 0,
skipped: 0,
failed: 0
};
for (let index = 0; index < sources.length; index += 1) {
const source = sources[index];
const startedAt = Date.now();
let result;
try {
const item = await copyOneFile(
source,
destination,
conflict
);
summary[item.status] += 1;
result = {
jobId,
index,
source,
target: item.target,
status: item.status,
bytes: item.bytes,
elapsedMs: Date.now() - startedAt,
message: item.message
};
} catch (error) {
const errorInfo = getErrorInfo(error);
summary.failed += 1;
result = {
jobId,
index,
source,
target: null,
status: 'failed',
bytes: 0,
elapsedMs: Date.now() - startedAt,
code: errorInfo.code,
message: errorInfo.message
};
}
summary.completed += 1;
sendToRenderer(
event.sender,
'file:copy-result',
result
);
}
sendToRenderer(
event.sender,
'file:copy-done',
summary
);
return summary;
}
function createWindow() {
const window = new BrowserWindow({
width: 1100,
height: 720,
webPreferences: {
preload: path.join(__dirname, 'preload.js'),
contextIsolation: true,
nodeIntegration: false
}
});
window.loadFile(path.join(__dirname, 'index.html'));
}
app.whenReady().then(() => {
ipcMain.handle('file:select-sources', async () => {
const result = await dialog.showOpenDialog({
properties: ['openFile', 'multiSelections']
});
return result.canceled ? [] : result.filePaths;
});
ipcMain.handle('file:select-destination', async () => {
const result = await dialog.showOpenDialog({
properties: ['openDirectory']
});
return result.canceled ? '' : result.filePaths[0];
});
ipcMain.handle('file:copy-batch', copyBatch);
createWindow();
app.on('activate', () => {
if (BrowserWindow.getAllWindows().length === 0) {
createWindow();
}
});
});
app.on('window-all-closed', () => {
if (process.platform !== 'darwin') {
app.quit();
}
});
示例中使用 for 循环配合 await,而不是直接写成:
await Promise.all(
  sources.map((source) => copyOneFile(source, destination, conflict))
);
Promise.all() 的主要问题不是不能复制,而是它不适合直接承担当前的结果反馈职责:
rename 策略时,并发生成文件名更容易发生竞争。逐个执行可以让每个文件的完成边界清晰:一个文件完成后立即发送结果,再处理下一个文件。对于常规桌面文件管理工具,这种方式更容易验证,也更适合准确反馈。
如果文件数量特别多,后续可以设计有限并发,例如同时处理 2 至 4 个文件,但仍要保留 index 字段,并使用 Promise.allSettled() 或任务队列收集每个文件的结果。不要直接使用无限并发。
COPYFILE_EXCL 对同名策略的作用overwrite 策略使用默认的 copyFile 行为,目标已存在时会覆盖普通文件。
skip 和 rename 使用了:
constants.COPYFILE_EXCL
它要求目标不存在才能创建。如果目标已经存在,Node.js 会返回 EEXIST。这样即使在检查目标和实际写入之间出现了其他进程创建同名文件的情况,也不会因为竞争条件而意外覆盖已有文件。
需要注意,COPYFILE_EXCL 只能解决“不覆盖”的问题,不能让整个批次具备事务特性。批量复制执行到一半时应用退出,已经完成的文件不会自动回滚。
预加载脚本不应把完整的 ipcRenderer 对象暴露给页面。页面只需要知道“选择文件”“选择目录”“开始复制”和“监听结果”这几个能力。
preload.js 可以这样写:
const { contextBridge, ipcRenderer } = require('electron');
const { randomUUID } = require('node:crypto');

contextBridge.exposeInMainWorld('fileApi', {
  newJobId() {
    return randomUUID();
  },

  selectSources() {
    return ipcRenderer.invoke('file:select-sources');
  },

  selectDestination() {
    return ipcRenderer.invoke('file:select-destination');
  },

  startCopy(payload) {
    return ipcRenderer.invoke('file:copy-batch', payload);
  },

  onCopyResult(callback) {
    const listener = (_event, result) => {
      callback(result);
    };

    ipcRenderer.on('file:copy-result', listener);

    return () => {
      ipcRenderer.removeListener('file:copy-result', listener);
    };
  },

  onCopyDone(callback) {
    const listener = (_event, summary) => {
      callback(summary);
    };

    ipcRenderer.on('file:copy-done', listener);

    return () => {
      ipcRenderer.removeListener('file:copy-done', listener);
    };
  }
});
这里的两个监听方法返回了取消监听的函数。页面销毁或重新加载时移除监听,可以避免重复注册导致同一条结果被渲染多次。
这段代码使用的是 Electron 内置的 contextBridge 和 IPC API,以及 Node.js 内置的 crypto.randomUUID。示例没有绑定某个具体 Electron 小版本;如果项目使用的是较老版本或 ESM 模块,需要以项目当前锁定版本中的 API 文档为准,并可在主进程输出下面的信息进行核对:
console.log({
  electron: process.versions.electron,
  node: process.versions.node,
  chrome: process.versions.chrome
});
页面至少需要保存四类状态:
jobId;一个简化的 index.html 如下:
<!doctype html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>批量复制文件</title>
</head>
<body>
  <main>
    <h2>批量复制文件</h2>

    <p>
      <button id="pickSources">选择文件</button>
      <span id="sourceInfo">尚未选择文件</span>
    </p>

    <p>
      <button id="pickDestination">选择目标目录</button>
      <span id="destinationInfo">尚未选择目标目录</span>
    </p>

    <p>
      <label for="conflict">同名文件处理:</label>
      <select id="conflict">
        <option value="skip">跳过,不覆盖</option>
        <option value="overwrite">覆盖目标文件</option>
        <option value="rename">自动改名</option>
      </select>
    </p>

    <p>
      <button id="startCopy">开始复制</button>
      <span id="summary">等待开始</span>
    </p>

    <table border="1" cellpadding="6" cellspacing="0">
      <thead>
        <tr>
          <th>序号</th>
          <th>源文件</th>
          <th>目标文件</th>
          <th>状态</th>
          <th>大小</th>
          <th>耗时</th>
          <th>说明</th>
        </tr>
      </thead>
      <tbody id="resultBody"></tbody>
    </table>
  </main>

  <script src="./renderer.js"></script>
</body>
</html>
对应的 renderer.js 负责发起操作和追加结果:
const state = {
  sources: [],
  destination: '',
  jobId: '',
  running: false
};

const pickSourcesButton = document.querySelector('#pickSources');
const pickDestinationButton = document.querySelector('#pickDestination');
const startCopyButton = document.querySelector('#startCopy');
const conflictSelect = document.querySelector('#conflict');

const sourceInfo = document.querySelector('#sourceInfo');
const destinationInfo = document.querySelector('#destinationInfo');
const summaryElement = document.querySelector('#summary');
const resultBody = document.querySelector('#resultBody');

const statusText = {
  copied: '成功',
  skipped: '跳过',
  failed: '失败'
};

function formatBytes(bytes) {
  if (!bytes) {
    return '0 B';
  }

  const units = ['B', 'KiB', 'MiB', 'GiB'];
  let value = bytes;
  let unitIndex = 0;

  while (value >= 1024 && unitIndex < units.length - 1) {
    value /= 1024;
    unitIndex += 1;
  }

  return `${value.toFixed(unitIndex === 0 ? 0 : 1)} ${units[unitIndex]}`;
}

function updateSelectionText() {
  sourceInfo.textContent = state.sources.length
    ? `已选择 ${state.sources.length} 个文件`
    : '尚未选择文件';

  destinationInfo.textContent = state.destination || '尚未选择目标目录';
}

function setRunning(running) {
  state.running = running;

  pickSourcesButton.disabled = running;
  pickDestinationButton.disabled = running;
  conflictSelect.disabled = running;
  startCopyButton.disabled = running;
}

function setSummary(summary) {
  summaryElement.textContent =
    `处理 ${summary.completed}/${summary.total} 个,` +
    `成功 ${summary.copied} 个,` +
    `跳过 ${summary.skipped} 个,` +
    `失败 ${summary.failed} 个`;
}

function clearResults() {
  resultBody.replaceChildren();
  summaryElement.textContent = '准备开始';
}

function appendResult(result) {
  const row = document.createElement('tr');

  const detail = result.status === 'failed'
    ? `${result.code}: ${result.message}`
    : result.message;

  const values = [
    String(result.index + 1),
    result.source,
    result.target || '-',
    statusText[result.status] || result.status,
    formatBytes(result.bytes),
    `${result.elapsedMs} ms`,
    detail
  ];

  for (const value of values) {
    const cell = document.createElement('td');
    cell.textContent = value;
    row.appendChild(cell);
  }

  resultBody.appendChild(row);
}

function finishJob(summary) {
  if (summary.jobId !== state.jobId) {
    return;
  }

  setSummary(summary);
  setRunning(false);
}

pickSourcesButton.addEventListener('click', async () => {
  const selected = await window.fileApi.selectSources();

  if (selected.length > 0) {
    state.sources = selected;
    updateSelectionText();
  }
});

pickDestinationButton.addEventListener('click', async () => {
  const selected = await window.fileApi.selectDestination();

  if (selected) {
    state.destination = selected;
    updateSelectionText();
  }
});

startCopyButton.addEventListener('click', async () => {
  if (state.running) {
    return;
  }

  if (state.sources.length === 0) {
    summaryElement.textContent = '请先选择至少一个文件';
    return;
  }

  if (!state.destination) {
    summaryElement.textContent = '请先选择目标目录';
    return;
  }

  clearResults();

  const jobId = window.fileApi.newJobId();
  state.jobId = jobId;

  setRunning(true);
  summaryElement.textContent = '正在处理';

  try {
    const summary = await window.fileApi.startCopy({
      jobId,
      sources: state.sources,
      destination: state.destination,
      conflict: conflictSelect.value
    });

    // 正常情况下 file:copy-done 会先更新页面。
    // 这里作为 invoke 返回结果的兜底处理。
    if (state.running && summary.jobId === state.jobId) {
      finishJob(summary);
    }
  } catch (error) {
    setRunning(false);
    summaryElement.textContent =
      `批次启动失败:${error.code || 'UNKNOWN_ERROR'},` +
      `${error.message || '未知错误'}`;
  }
});

const removeResultListener = window.fileApi.onCopyResult((result) => {
  if (result.jobId !== state.jobId) {
    return;
  }

  appendResult(result);
});

const removeDoneListener = window.fileApi.onCopyDone((summary) => {
  finishJob(summary);
});

window.addEventListener('beforeunload', () => {
  removeResultListener();
  removeDoneListener();
});

updateSelectionText();
主进程中的 file:copy-batch 返回值代表整批任务结束后的汇总,不能用它实现逐文件反馈。渲染进程应该监听 file:copy-result:
window.fileApi.onCopyResult((result) => {
  appendResult(result);
});
收到事件后立即追加一行,用户不需要等待整批任务结束,就能看到当前文件的处理状态。最后再通过 file:copy-done 更新顶部统计信息。
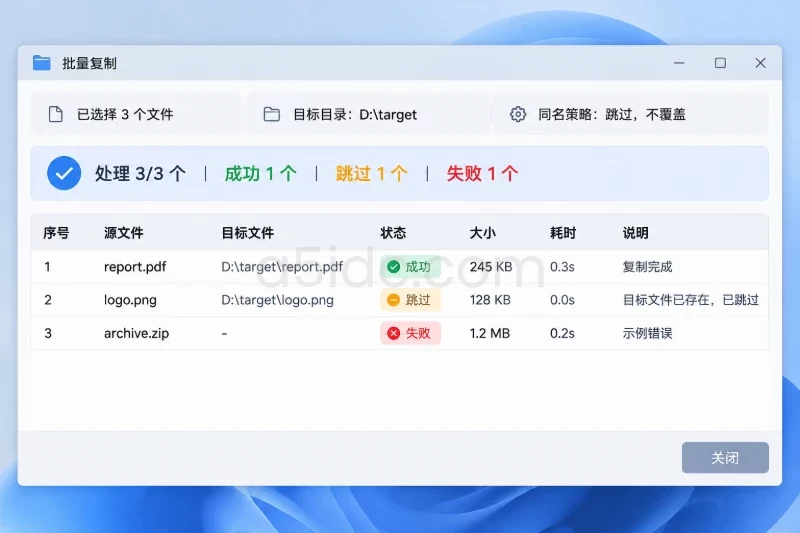
index 字段即使在当前顺序执行模式下看起来不是必须,也建议保留。以后改成有限并发时,文件完成顺序可能与源文件选择顺序不同,界面可以依据 index 重新排序,而不需要修改 IPC 数据结构。
示例把单个文件的复制过程放进 try...catch,失败后继续进入下一次循环。这样可以区分两类错误。
下面这些错误通常只影响当前文件:
当前文件会生成一条 failed 结果,后面的文件仍然继续处理。
目标目录不存在、目标路径不是目录、IPC 参数结构无效等问题属于批次级错误。这些问题如果不先处理,后续所有文件都会失败,因此示例会在循环前执行:
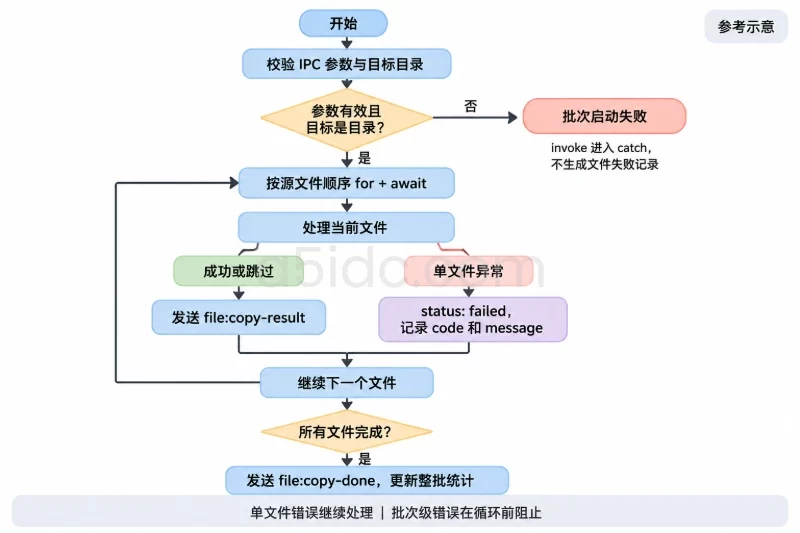
const destinationStat = await fs.stat(destination);

if (!destinationStat.isDirectory()) {
  throw makeError('目标路径不是目录', 'DESTINATION_NOT_DIRECTORY');
}
这类错误会让 ipcRenderer.invoke() 直接进入 catch,页面显示“批次启动失败”,而不是伪造多条文件失败记录。
这种区分可以让用户理解问题范围:如果列表中只有一条失败记录,通常是某个文件自身的问题;如果任务根本没有开始,通常是目标目录或请求参数的问题。
假设源列表中有三个文件:
D:\work\report.pdfD:\work\logo.pngD:\work\archive.zip目标目录中已经存在 logo.png,选择 skip 策略后,页面可能显示如下结果:
| 序号 | 状态 | 目标文件 | 说明 |
|---|---|---|---|
| 1 | 成功 | ...\report.pdf | 复制完成 |
| 2 | 跳过 | ...\logo.png | 目标文件已存在,已跳过 |
| 3 | 成功或失败 | ...\archive.zip | 取决于实际文件权限和磁盘状态 |
这里的数据只是界面展示示例,不代表某次实际运行结果。真正的结果由主进程在复制完成后生成。
如果选中 rename,两个不同源目录中的同名文件也会被展平到同一个目标目录,并依次生成:
report.pdf
report (1).pdf
report (2).pdf
如果选择 overwrite,程序会直接替换目标中的普通文件。由于覆盖行为可能造成数据丢失,界面上最好增加明确提示,并把默认策略设置为 skip。
系统文件选择框通常不会返回重复路径,但如果源列表来自其他页面或数据库,仍可能出现同一个路径多次出现的情况。
示例没有静默去重,而是按照收到的顺序处理:
是否去重应由业务决定。若重复选择通常属于用户误操作,可以在发送 IPC 前使用 Set 去重;如果每一条记录代表一次独立任务,则不应擅自合并。
当前 copyOneFile() 使用:
const sourceStat = await fs.lstat(source);

if (!sourceStat.isFile()) {
  throw makeError(
    '当前示例只支持普通文件,不支持目录或符号链接',
    'UNSUPPORTED_FILE'
  );
}
这样可以避免把目录误传给文件复制函数,也避免在没有明确策略时跟随符号链接写入其他位置。
如果需要支持目录复制,应先在主进程中递归遍历目录,得到实际文件列表,再逐个调用复制逻辑。此时还要决定:
不要简单地把目录直接交给单文件复制函数,否则界面中的“逐个文件结果”就无法和实际操作对应。
fs.promises.copyFile() 适合判断一个文件是否完成,但不会持续返回已经复制的字节数。因此当前实现可以显示:
它不能直接显示:
archive.zip:已经完成 46%
如果确实需要文件内部进度,可以使用流:
createReadStream(source) 创建源文件读取流;createWriteStream(target) 创建目标文件写入流;copied;流式复制需要额外处理背压、目标文件临时名、异常关闭和临时文件清理。如果只是批量复制办公文档、图片或安装包,并不需要显示单文件百分比,那么使用 copyFile 的代码更短,失败边界也更清晰。
对于大文件进度事件,不建议每写入一个数据块就发送一次 IPC 消息。可以按照 100 毫秒至 300 毫秒的间隔节流,否则大量消息会增加渲染进程更新压力。
当前示例在复制成功后执行:
const targetStat = await fs.stat(target);
并把目标文件的大小放入 bytes。这可以确认目标路径已经存在,并为页面提供展示数据,但它不是完整的内容校验。
如果文件完整性要求较高,可以在复制完成后比较源文件和目标文件的哈希值,例如使用 SHA-256。代价是需要再次读取文件,文件越大,额外耗时越明显。普通文件管理场景通常先依靠 copyFile 的错误返回和目标文件存在性检查;备份、归档或传输校验场景再增加哈希验证。
overwrite 目前直接写入目标文件。如果目标文件很重要,建议改为:
这样可以减少复制中断后正式目标文件处于不完整状态的风险。不过,替换动作在不同操作系统和目标文件占用状态下仍有差异,不能把临时文件方案描述成跨平台事务。
示例中使用了以下进程边界:
渲染进程
  ├─ 请求选择文件
  ├─ 请求选择目标目录
  └─ 发起复制批次
        ↓ IPC
主进程
  ├─ 打开系统对话框
  ├─ 校验路径和策略
  ├─ 执行文件复制
  └─ 发送逐文件结果
        ↓ IPC
渲染进程
  ├─ 更新单行结果
  └─ 更新整批统计
接入现有项目时,至少保留以下约束:
nodeIntegration: false;contextIsolation: true;ipcRenderer 暴露给页面;sources、destination 和 conflict;textContent 写入路径和错误信息,不使用未经处理的 innerHTML;示例默认页面是本地可信界面,并允许渲染进程把已选择的绝对路径传回主进程。如果应用加载的是远程页面,或者页面中含有不完全可信的脚本,更稳妥的做法是由主进程保存文件选择结果,只向渲染进程返回一个临时任务标识,批量复制时让渲染进程提交任务标识而不是任意绝对路径。
可以按照下面的顺序验证功能:
copied 结果;skip,确认结果变为 skipped,原目标文件内容不变;rename,确认目标目录中出现带序号的新文件;overwrite,确认目标文件被替换,并注意界面是否提供了明确提示;failed,其他文件仍继续处理;完成接入后,用户看到的不再是一个只有“复制成功”或“复制失败”的总提示,而是每个文件都有独立状态,顶部还保留整批任务的成功、跳过和失败统计。后续无论增加取消任务、有限并发、目录递归还是文件哈希校验,都可以继续沿用当前的 IPC 结果协议,而不需要重新设计页面和主进程之间的基本协作。
对于还需集中存放文件或归档数据的应用,A5idc数据提供香港存储型物理服务器方案,例如配置四块14TB企业级机械硬盘及H730控制器的资源,可作为大容量文件数据的存储基础,配合相关数据服务部署。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/10017.html