香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


上传接口收到一个名为 report.pdf 的文件时,文件名、扩展名和浏览器提交的 Content-Type 都不能证明它真的是可解析的 PDF。更可靠的做法是把校验分成两层:先检查文件本身的基本结构,再交给 PDF 解析器打开并遍历页面内容。只有两层都通过,才进入正式的文本、表格或业务字段解析。
PDF 文件的异常通常不只有一种表现,可以按处理阶段分为以下几类:
%PDF-,文件可能是 HTML 错误页、图片、压缩包,或者只是被错误地改成了 .pdf 后缀。因此,不能只用下面这种判断:
if (Path.GetExtension(fileName).Equals(".pdf",
    StringComparison.OrdinalIgnoreCase))
{
    // 直接解析
}
这个判断最多只能作为界面提示,不能作为安全校验或解析前置条件。
一个适合接入上传服务的流程是:
上传完成并写入临时文件
        ↓
文件大小与基本特征检查
        ↓
PDF 解析器打开文件
        ↓
读取页数并遍历所有页面
        ↓
按业务要求进入文本、表格或附件解析
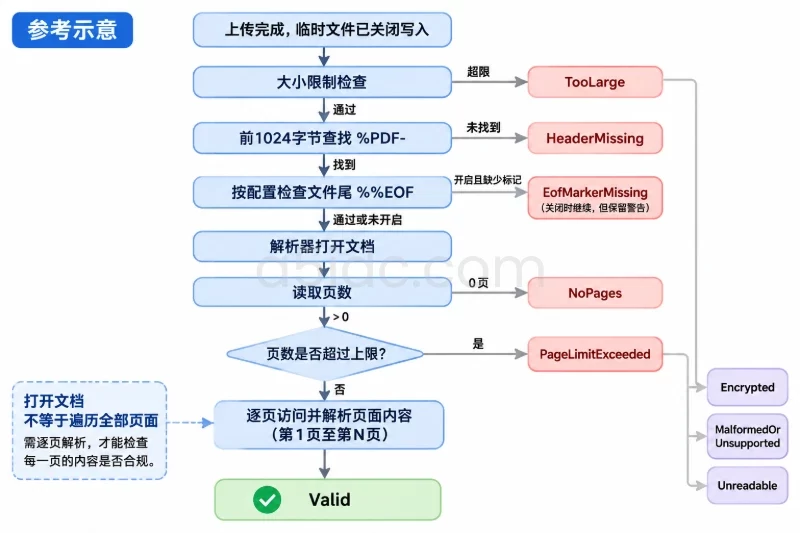
需要特别注意,很多 PDF 解析器采用延迟读取。仅仅执行“打开文档”不一定会访问所有页面,更不能据此判断文档的每一页都没有损坏。
下面的示例以 .NET 8 和 iText 7.2.x 的 Kernel API 为基础,NuGet 包使用 itext7。例如可以固定到项目已经审核过的版本:
dotnet add package itext7 --version 7.2.5
iText 的授权方式需要结合项目发布模式确认。AGPL 或商业授权的适用条件可能不同,商业项目不应只复制代码后忽略依赖许可。
先定义校验状态。状态不要只设计成 true 或 false,否则调用方无法区分“文件损坏”“需要密码”和“超过业务限制”。
namespace PdfPreflightDemo;

public enum PdfCheckStatus
{
    Valid,

    FileNotFound,
    EmptyFile,
    TooLarge,
    HeaderMissing,
    EofMarkerMissing,

    Encrypted,
    NoPages,
    PageLimitExceeded,

    MalformedOrUnsupported,
    Unreadable
}

public sealed class PdfValidationOptions
{
    // 示例值:100 MiB,不代表所有项目都适用
    public long MaxBytes { get; init; } = 100L * 1024 * 1024;

    // 示例值:5000 页,应根据业务文档类型调整
    public int MaxPages { get; init; } = 5000;

    // 严格模式下,要求文件尾部能够找到 %%EOF
    public bool RequireEofMarker { get; init; } = true;

    // 是否遍历每一页并执行内容解析
    public bool ParsePageContent { get; init; } = true;
}

public sealed record PdfCheckResult(
    PdfCheckStatus Status,
    long FileLength,
    int? PageCount,
    bool HasEofMarker,
    string Message)
{
    public bool Accepted => Status == PdfCheckStatus.Valid;
}
这里的 100L <em> 1024 </em> 1024 是 100 MiB,而不是十进制意义上的 100 MB。如果系统的上传限制使用十进制 MB,需要统一配置口径,避免网关、应用和校验器设置不一致。
HasEofMarker 单独保留下来,是因为缺少 %%EOF 可以作为异常信号,但它并不等于解析器一定无法读取。部分解析器能够对某些不完整文件进行恢复,因此是否将它直接判定为拒绝,应由项目的严格程度决定。
PDF 文件通常以 %PDF- 开头,并在文件末尾附近出现 %%EOF。这两个检查只适合快速筛选,不足以证明 PDF 结构完整。
文件头不一定必须位于第 0 个字节。有些 PDF 生成器会在文件头前写入少量二进制数据,因此示例会在前 1024 个字节内查找 %PDF-,而不是只比较开头五个字节。
using System.Text;

namespace PdfPreflightDemo;

public static class PdfSignatureCheck
{
    public static bool HasPdfHeader(Stream stream)
    {
        stream.Seek(0, SeekOrigin.Begin);

        byte[] buffer = new byte[1024];
        int read = ReadAtMost(stream, buffer);

        for (int i = 0; i <= read - 5; i++)
        {
            if (buffer[i] == (byte)'%' &&
                buffer[i + 1] == (byte)'P' &&
                buffer[i + 2] == (byte)'D' &&
                buffer[i + 3] == (byte)'F' &&
                buffer[i + 4] == (byte)'-')
            {
                return true;
            }
        }

        return false;
    }

    public static bool HasEofMarker(Stream stream)
    {
        if (!stream.CanSeek || stream.Length == 0)
        {
            return false;
        }

        long tailLength = Math.Min(4096L, stream.Length);
        stream.Seek(-tailLength, SeekOrigin.End);

        byte[] tail = new byte[(int)tailLength];
        int read = ReadAtMost(stream, tail);

        string tailText = Encoding.ASCII.GetString(tail, 0, read);
        return tailText.Contains("%%EOF", StringComparison.Ordinal);
    }

    private static int ReadAtMost(Stream stream, byte[] buffer)
    {
        int total = 0;

        while (total < buffer.Length)
        {
            int count = stream.Read(
                buffer,
                total,
                buffer.Length - total);

            if (count == 0)
            {
                break;
            }

            total += count;
        }

        return total;
    }
}
这个轻量检查有几个明确边界:
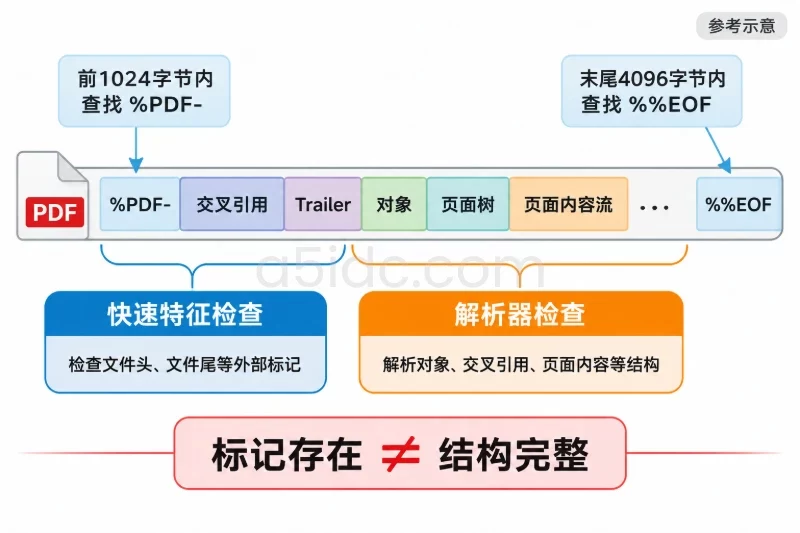
%%EOF,只说明能找到结束标记,不代表交叉引用表没有损坏。%%EOF,可能来自上传截断、写入未完成或生成器输出不规范。%%EOF,因此不应只搜索一个固定位置。因此,预检通过后仍必须执行真正的解析。
下面的校验器将轻量检查和 iText 解析结合起来。代码中的 PdfTextExtractor 不是为了提取最终业务文本,而是为了让页面内容流至少经过一次解析路径。对扫描型 PDF 来说,提取结果为空是正常的,并不代表文档损坏。
using System.IO;
using iText.Kernel.Exceptions;
using iText.Kernel.Pdf;
using iText.Kernel.Pdf.Canvas.Parser;
using iText.Kernel.Pdf.Canvas.Parser.Listener;

namespace PdfPreflightDemo;

public static class PdfPreflightValidator
{
    public static PdfCheckResult Validate(
        string path,
        PdfValidationOptions? options = null)
    {
        options ??= new PdfValidationOptions();

        if (!File.Exists(path))
        {
            return new PdfCheckResult(
                PdfCheckStatus.FileNotFound,
                0,
                null,
                false,
                "文件不存在。");
        }

        FileInfo fileInfo;

        try
        {
            fileInfo = new FileInfo(path);
        }
        catch (Exception)
        {
            return new PdfCheckResult(
                PdfCheckStatus.Unreadable,
                0,
                null,
                false,
                "无法读取文件信息。");
        }

        if (fileInfo.Length == 0)
        {
            return new PdfCheckResult(
                PdfCheckStatus.EmptyFile,
                0,
                null,
                false,
                "文件大小为 0。");
        }

        if (options.MaxBytes <= 0 || options.MaxPages <= 0)
        {
            throw new ArgumentOutOfRangeException(
                nameof(options),
                "MaxBytes 和 MaxPages 必须大于 0。");
        }

        if (fileInfo.Length > options.MaxBytes)
        {
            return new PdfCheckResult(
                PdfCheckStatus.TooLarge,
                fileInfo.Length,
                null,
                false,
                "文件超过允许的大小限制。");
        }

        bool hasEofMarker = false;

        try
        {
            // 文件应在上传完成并关闭写入流后再进行校验。
            using var stream = new FileStream(
                path,
                FileMode.Open,
                FileAccess.Read,
                FileShare.Read,
                bufferSize: 64 * 1024,
                options: FileOptions.SequentialScan);

            if (!PdfSignatureCheck.HasPdfHeader(stream))
            {
                return new PdfCheckResult(
                    PdfCheckStatus.HeaderMissing,
                    stream.Length,
                    null,
                    false,
                    "文件头不是可识别的 PDF 特征。");
            }

            hasEofMarker = PdfSignatureCheck.HasEofMarker(stream);

            if (options.RequireEofMarker && !hasEofMarker)
            {
                return new PdfCheckResult(
                    PdfCheckStatus.EofMarkerMissing,
                    stream.Length,
                    null,
                    false,
                    "文件尾部没有找到 %%EOF,可能上传不完整或结构不规范。");
            }

            stream.Seek(0, SeekOrigin.Begin);

            // iText 7.2.x 使用 PdfReader 和 PdfDocument 打开 PDF。
            using var reader = new PdfReader(stream);
            using var document = new PdfDocument(reader);

            int pageCount = document.GetNumberOfPages();

            if (pageCount == 0)
            {
                return new PdfCheckResult(
                    PdfCheckStatus.NoPages,
                    stream.Length,
                    0,
                    hasEofMarker,
                    "PDF 可以打开,但没有可用页面。");
            }

            if (pageCount > options.MaxPages)
            {
                return new PdfCheckResult(
                    PdfCheckStatus.PageLimitExceeded,
                    stream.Length,
                    pageCount,
                    hasEofMarker,
                    "PDF 页数超过业务允许范围。");
            }

            if (options.ParsePageContent)
            {
                for (int pageNumber = 1;
                     pageNumber <= pageCount;
                     pageNumber++)
                {
                    PdfPage page = document.GetPage(pageNumber);

                    // 触发页面对象访问。
                    _ = page.GetPdfObject();

                    // 触发内容流和文本解析路径。
                    // 扫描 PDF 可能返回空字符串,这是正常现象。
                    _ = PdfTextExtractor.GetTextFromPage(
                        page,
                        new LocationTextExtractionStrategy());
                }
            }

            string message = hasEofMarker
                ? "文件头、文件尾和页面内容均可由当前解析器读取。"
                : "页面内容可以读取,但未找到 %%EOF,建议保留警告并复核来源。";

            return new PdfCheckResult(
                PdfCheckStatus.Valid,
                stream.Length,
                pageCount,
                hasEofMarker,
                message);
        }
        catch (BadPasswordException)
        {
            // iText 7.2.x 对无法提供密码的加密文件通常进入此分支。
            return new PdfCheckResult(
                PdfCheckStatus.Encrypted,
                fileInfo.Length,
                null,
                hasEofMarker,
                "PDF 需要密码,不能按未加密文档继续解析。");
        }
        catch (PdfException)
        {
            return new PdfCheckResult(
                PdfCheckStatus.MalformedOrUnsupported,
                fileInfo.Length,
                null,
                hasEofMarker,
                "PDF 结构损坏,或当前解析器不支持其中的特性。");
        }
        catch (UnauthorizedAccessException)
        {
            return new PdfCheckResult(
                PdfCheckStatus.Unreadable,
                fileInfo.Length,
                null,
                hasEofMarker,
                "应用没有读取该文件的权限。");
        }
        catch (IOException)
        {
            return new PdfCheckResult(
                PdfCheckStatus.Unreadable,
                fileInfo.Length,
                null,
                hasEofMarker,
                "文件读取失败,可能仍在写入或底层存储不可用。");
        }
        catch (Exception)
        {
            return new PdfCheckResult(
                PdfCheckStatus.MalformedOrUnsupported,
                fileInfo.Length,
                null,
                hasEofMarker,
                "读取或解析过程中发生未分类异常。");
        }
    }
}
这段代码有几个重要设计点。
如果只写下面的代码:
using var reader = new PdfReader(path);
using var document = new PdfDocument(reader);

int pageCount = document.GetNumberOfPages();
它只能证明解析器完成了部分初始化。某些文档的第一页正常,但后面的页面对象、内容流或字体对象已经损坏。只有继续执行:
for (int pageNumber = 1;
     pageNumber <= document.GetNumberOfPages();
     pageNumber++)
{
    PdfPage page = document.GetPage(pageNumber);
    _ = PdfTextExtractor.GetTextFromPage(
        page,
        new LocationTextExtractionStrategy());
}
才更有机会发现后续页面中的异常。
不过,页面遍历仍然不是渲染验收。PDF 可能能被文本解析器读取,却在特定字体、透明度、图像解码或图形操作上无法正常显示。如果业务需要确认“用户看到的页面也能渲染”,还需要增加渲染引擎生成缩略图或页面位图的检查。
PdfException 可能对应多种原因:
因此,示例将它们归为 MalformedOrUnsupported,而不是直接向最终用户承诺“文件一定损坏”。如果项目固定使用某个具体版本的解析器,可以根据该版本的异常类型继续细分;当升级 PDF 库时,也应重新核对异常映射。
加密文件应单独处理。它不是损坏文件,用户可能只是需要提供密码。如果业务允许输入密码,应通过受控的密码参数构造 ReaderProperties,不要把密码写入日志、错误信息或校验结果:
var properties = new ReaderProperties()
    .SetPassword(System.Text.Encoding.UTF8.GetBytes(password));

using var reader = new PdfReader(stream, properties);
using var document = new PdfDocument(reader);
密码是否正确、是否允许继续处理,应由业务规则决定。校验器只需要把“需要密码”和“结构解析失败”区分开。
应用应在文件完成写入后调用校验器。不要一边接收上传流,一边让解析器读取同一个仍在增长的文件,否则很容易得到“文件尾缺失”或“随机读取失败”的结果。
一个简化的接入方式如下:
using PdfPreflightDemo;

string storedPath = uploadStoragePath;

// storedPath 应由服务端生成,不能直接使用用户提交的路径。
PdfCheckResult check = PdfPreflightValidator.Validate(
    storedPath,
    new PdfValidationOptions
    {
        MaxBytes = 100L * 1024 * 1024,
        MaxPages = 2000,
        RequireEofMarker = true,
        ParsePageContent = true
    });

switch (check.Status)
{
    case PdfCheckStatus.Valid:
        // 进入已有的正式解析流程。
        // 例如:提取文本、识别表格或读取业务字段。
        ParsePdfBusinessData(storedPath);
        break;

    case PdfCheckStatus.Encrypted:
        // 提示用户提供密码,或转入人工处理。
        RejectUpload("该 PDF 受到密码保护。");
        break;

    case PdfCheckStatus.HeaderMissing:
    case PdfCheckStatus.EmptyFile:
    case PdfCheckStatus.EofMarkerMissing:
    case PdfCheckStatus.MalformedOrUnsupported:
        RejectUpload("文件不是可处理的完整 PDF,或文件结构无法读取。");
        break;

    case PdfCheckStatus.TooLarge:
    case PdfCheckStatus.PageLimitExceeded:
        RejectUpload("文件超过当前业务允许的处理范围。");
        break;

    case PdfCheckStatus.Unreadable:
        RetryOrReportStorageProblem();
        break;

    default:
        RejectUpload(check.Message);
        break;
}
实际项目中,ParsePdfBusinessData 和 RejectUpload 应替换为已有的服务方法。校验结果中的 Message 可以用于内部日志或管理后台,但不建议把底层解析器的原始异常文本直接返回给上传者,因为异常信息可能包含内部路径、对象编号或依赖库细节。
临时文件建议使用服务端随机名称,并保存到应用专用目录。上传流程至少应满足以下条件:
下面的表格可以直接用于设计接口返回码或管理后台状态。
| 校验状态 | 通常原因 | 是否等同于文件损坏 | 建议处理 |
|---|---|---|---|
Valid | 文件结构和页面内容可被当前解析器读取 | 否 | 进入正式业务解析 |
HeaderMissing | HTML、图片、压缩包或错误文件被改成 PDF 后缀 | 通常不是 PDF | 拒绝并提示重新上传 |
EofMarkerMissing | 上传截断、生成未完成、文件尾缺失 | 高度可疑,但不一定绝对损坏 | 严格业务直接拒绝,宽松业务进入隔离复核 |
Encrypted | 文档需要密码或权限口令 | 否 | 提示提供密码,或转人工处理 |
NoPages | PDF 页面树为空 | 不一定是结构损坏 | 如果业务需要页面,则拒绝 |
PageLimitExceeded | 页数超过处理资源或业务上限 | 否 | 要求拆分文件或改用异步处理 |
MalformedOrUnsupported | 对象、交叉引用、内容流损坏或特性不支持 | 可能是 | 拒绝、隔离或要求重新导出 |
Unreadable | 权限、锁定、存储错误或文件仍在写入 | 否 | 重试或检查存储流程 |
TooLarge | 文件超过大小限制 | 否 | 按业务规则拒绝或转异步处理 |
其中,EofMarkerMissing 值得单独说明。若应用面对的是财务、合同、归档等要求较高的文件,可以保持 RequireEofMarker = true,让缺少结束标记的文件在进入解析器前就被拦截。若应用主要处理来源复杂的历史 PDF,并且解析器具备恢复能力,可以设置为 false,但必须将 HasEofMarker = false 作为警告保存,而不是当作完全正常的文件。
验收时不要只用一个能够正常打开的 PDF。至少准备以下几类副本进行测试:
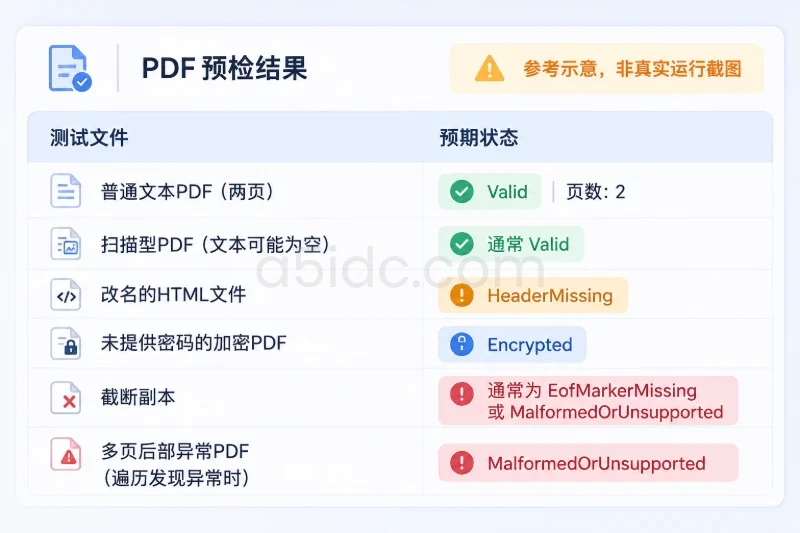
| 测试文件 | 构造或来源 | 预期结果 |
|---|---|---|
| 普通文本 PDF | 含两页可复制文本 | Valid,页数为 2 |
| 扫描型 PDF | 页面主要是图片,没有文本层 | 通常为 Valid,提取文本为空不应直接失败 |
| 改名的 HTML 文件 | 将错误页保存为 sample.pdf | HeaderMissing |
| 截断副本 | 只对测试副本删除末尾部分 | 通常为 EofMarkerMissing 或 MalformedOrUnsupported |
| 加密 PDF | 未提供密码 | Encrypted |
| 空白页面 PDF | 文档有页面但没有文字 | 只要页面结构正常,仍可为 Valid |
| 多页后部异常 PDF | 前几页正常,后续页面对象损坏 | 遍历到异常页时返回 MalformedOrUnsupported |
| 超大或超多页 PDF | 超过配置限制 | TooLarge 或 PageLimitExceeded |
如果要构造截断文件,只能对测试副本操作,不要直接修改用户上传的原始文件。更安全的测试方式是先复制文件,再对复制品使用文件流调整长度。测试目标是验证状态分支,不是修复原始文档。
还应检查结果是否符合以下预期:
.pdf,但文件内容是合法 PDF 时,不应仅因为后缀不同就判定失败;.pdf,但内容是 HTML 或图片时,应被基本预检拦截;这种方式消耗很小,适合在上传入口快速筛除明显错误文件,但无法发现页面对象、交叉引用和内容流问题。它只能作为第一道门,不能替代 PDF 解析器。
这是最适合常规业务的方案。校验和后续解析使用同一类 PDF 能力,能提前发现正式解析阶段会遇到的多数问题,也不需要引入额外命令行进程。
缺点是它会消耗 CPU、内存和时间。对大量扫描件、超长文档或来源不可信的公开上传接口,应配合文件大小、页数、并发数和队列限制。
如果归档或文档治理场景要求更强的结构诊断,可以在隔离环境中使用独立 PDF 检查工具,例如 qpdf 的检查命令:
qpdf --check input.pdf
这类工具通常更适合作为运维诊断或离线复核,不一定适合作为每个 Web 请求的同步依赖。应用需要额外处理进程启动开销、可执行文件部署、超时、退出码、临时路径和命令参数安全问题。它的结构检查结果也不能替代业务所需的文本抽取或页面渲染验证。
如果项目因授权或功能原因更换 .NET PDF 库,应保留现有的文件大小、文件头、文件尾和业务限制层,只替换“打开文档、读取页数、遍历页面内容”的实现。不同库对损坏文件的容错程度不同,不能把某个库能够打开的结果直接当作所有解析器都能正常处理。
PDF 解析不应被当作普通字符串读取。文件可能包含大量页面、嵌套对象、压缩数据或复杂内容流,即使文件大小不大,也可能消耗较多 CPU 和内存。
实际服务中可以采用以下限制:
Task.Run 模拟超时;Task.Run 不能真正终止已经进入底层解析库的工作。如果需要强制限制解析时间,应让独立工作进程执行解析,在超时后终止该进程,并清理其临时目录。对于内部可信文件,可以采用较轻量的线程池方案;对于开放上传入口,则应把资源隔离放在更高优先级。
文件哈希也可以用于确认上传前后是不是同一份文件,但哈希本身不能证明 PDF 没有损坏。只有在存在可信的预期哈希值时,哈希比对才具有完整性验证意义。
经过上述处理后,调用方得到的不再只是“能不能打开”的布尔值,而是包括文件大小、页数、文件尾状态和具体失败类别的结果。正常文件进入正式解析,密码文件进入授权处理,资源超限文件进入业务限制分支,结构异常文件则可以被拒绝或隔离,后续排查不会再与权限、上传未完成和格式不支持混在一起。
A5数据提供香港、美国、日本等地区的物理服务器,涵盖不同CPU、内存及SSD、NVMe存储配置,可用于承载文件上传接口、PDF解析任务和相关业务数据处理;各地资源可结合应用访问区域与负载安排。企业亦提供域名与SSL证书业务,支持网站及接口通过域名提供HTTPS加密连接,为文档上传与处理应用的运行入口和基础资源提供配套选择。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9966.html