香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


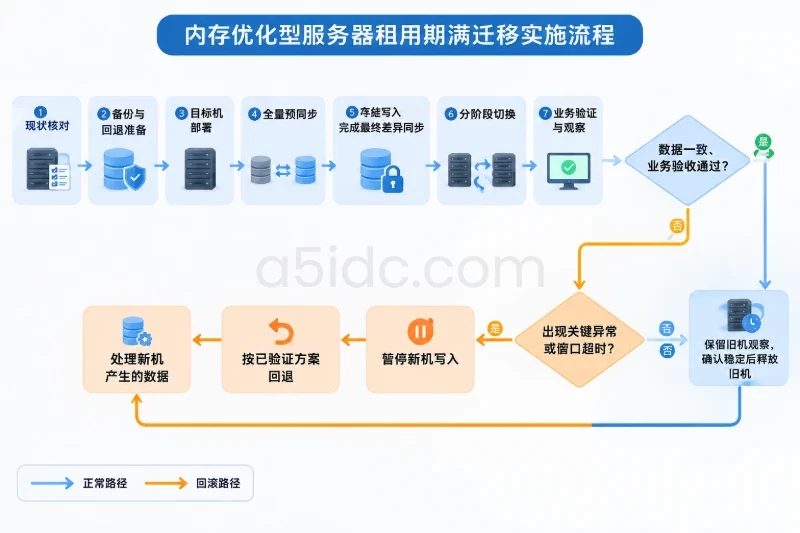
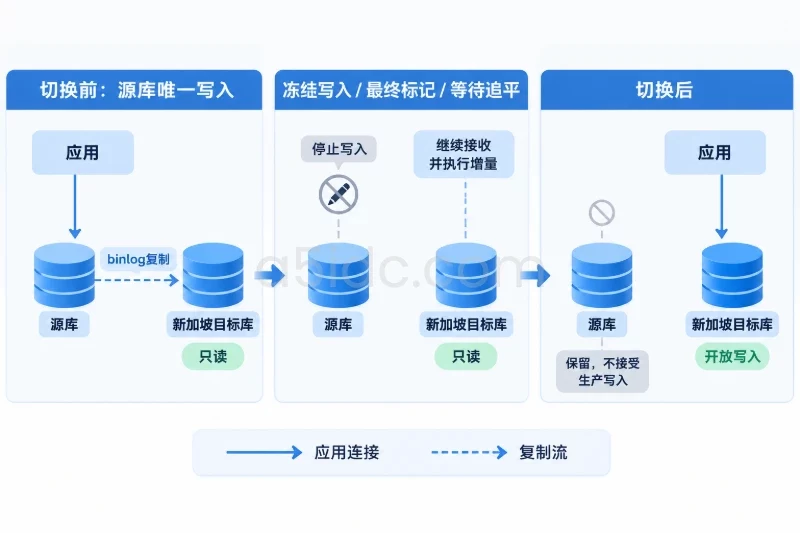
把现网数据库迁到新加坡服务器,最终同步不应理解为在停机窗口重新导入一次全量备份。更稳妥的生产方案是“全量初始化+持续增量复制+短暂冻结写入+校验后切换”:迁移期间源库继续提供服务,最终窗口只处理尚未追平的增量、连接切换和业务验证。
切换前,源库必须仍是唯一写入端,目标库保持只读并持续接收源库变更。切换时先停止业务写入,等待目标库追上最后一个事务标记,再切换应用连接池和定时任务。目标库一旦开始接受生产写入,旧源库就不再具备无条件的即时回滚能力,因此需要区分“目标库尚未写入”和“目标库已经产生新写入”两种回滚路径。
下文的命令以 MySQL 8.0.23 及以上、InnoDB、单主一向复制为例。PostgreSQL、SQL Server 或其他数据库应使用对应的物理复制、逻辑复制或日志传输机制,不能直接套用 MySQL 命令,但最终同步和切换原则相同。
| 阶段 | 唯一写入端 | 新加坡目标库状态 | 放行条件 |
|---|---|---|---|
| 全量初始化 | 源库 | 只读或不对应用开放 | 全量数据恢复完成 |
| 持续同步 | 源库 | 只读,复制线程正常 | 无 I/O 或 SQL 线程错误 |
| 最终同步 | 暂停所有业务写入 | 等待复制追平 | 最后一个事务标记已执行 |
| 业务切换 | 目标库 | 关闭复制并开放写入 | 应用连接和关键功能验证通过 |
| 观察期 | 目标库 | 主库运行,源库保留 | 监控指标稳定且无数据异常 |
迁移前应先确认以下依赖:
数据库时区不要因为服务器位于新加坡就自动改变。先记录源库环境:
SELECT
    @@global.time_zone AS global_time_zone,
    @@system_time_zone AS system_time_zone,
    @@global.sql_mode AS sql_mode,
    @@lower_case_table_names AS lower_case_table_names,
    @@server_uuid AS server_uuid;

SHOW VARIABLES LIKE 'event_scheduler';
如果源库和目标库的时区不同,定时任务、订单时间、账期和报表可能出现偏差。除非业务已经明确采用 UTC 并完成验证,否则迁移时应保持数据库时间语义一致。
A5idc数据提供新加坡物理服务器,可作为数据库迁移后的目标运行环境。当地方案涵盖至强 E3、双路 E5 和金牌平台,内存可选 16GB 至 64GB,并有 HDD、SSD 或 NVMe 存储;网络选项包括大陆优化、精品 CN2 及部分国际 BGP 线路,可结合数据库资源与业务访问需求选择相应配置。
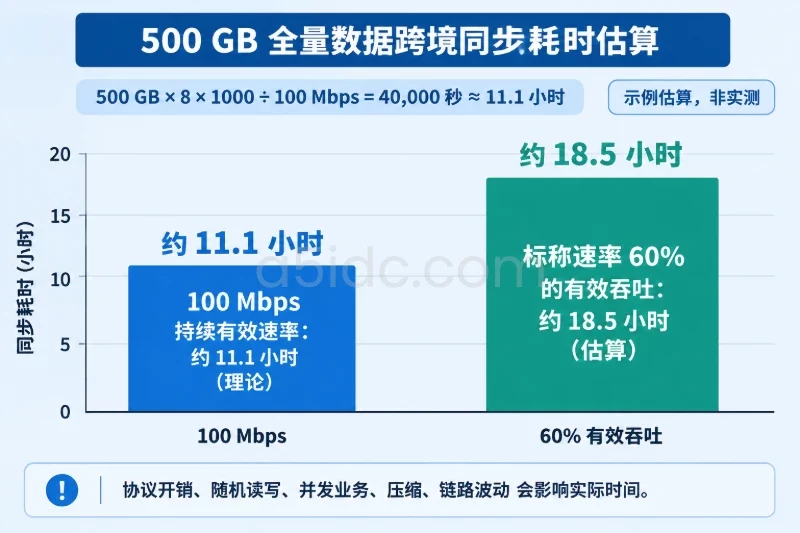
全量复制时间和最终同步时间是两个不同概念:
按十进制单位估算,500 GB 数据通过 200 Mbps 链路传输,理论传输时间为:
500 × 8 × 1000 ÷ 200 = 20000 秒 ≈ 5.6 小时
这是不计协议开销、压缩、磁盘读写和恢复时间的理论值。最终同步时,如果还剩 12 GB binlog,目标库应用速度约为 80 MB/s,则理论追平时间约为:
12 × 1000 ÷ 80 = 150 秒
实际窗口还应加上事务排空、校验、切换连接池和冒烟测试的时间。不要把全量传输时间直接当成业务停机时间。
先在源库和目标库分别检查日志、GTID、复制格式和服务器标识:
mysql -h SOURCE_HOST -u admin -p -e "
SELECT VERSION();
SHOW VARIABLES WHERE Variable_name IN
('log_bin','binlog_format','gtid_mode',
 'enforce_gtid_consistency','server_id','server_uuid');
"
生产环境通常应使用:
log_bin=ONbinlog_format=ROWserver_idserver_uuid 不得与源库相同如果当前没有启用 binlog 或 GTID,不建议在最终切换当天临时修改并重启数据库。应先安排独立的配置变更、备份和验证窗口。
常见的基础配置示例如下,实际配置文件路径取决于发行版和安装方式:
[mysqld]
server-id=101
log_bin=mysql-bin
binlog_format=ROW
目标库需要使用不同的 server-id,并在初始化阶段保持只读:
[mysqld]
server-id=202
log_bin=mysql-bin
read_only=ON
super_read_only=ON
event_scheduler=OFF
目标库的事件调度器在切换前应保持关闭,避免源库和目标库同时执行相同的定时任务。
复制连接只需要允许新加坡目标服务器访问源库的数据库端口,防火墙不要对整个公网开放。复制账号应限制来源地址并要求 TLS:
CREATE USER 'repl'@'TARGET_IP'
  IDENTIFIED BY 'replace-with-a-secret-from-secret-manager';

GRANT REPLICATION SLAVE, REPLICATION CLIENT
  ON *.* TO 'repl'@'TARGET_IP';

ALTER USER 'repl'@'TARGET_IP' REQUIRE SSL;
密码不要写入公共脚本、代码仓库或命令历史。应用账号也应在目标库重新创建并按最小权限授权,不能简单地把源库的系统账号表覆盖到目标库。
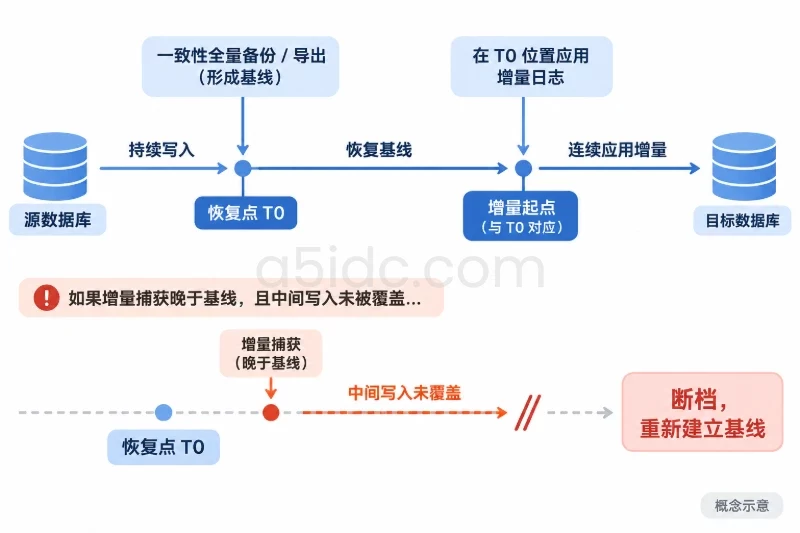
对于以 InnoDB 为主的业务库,可以使用一致性逻辑备份。不要把 MySQL 系统库和业务库混在一起直接覆盖目标库账号:
mysqldump -h SOURCE_HOST -u backup -p \
  --single-transaction \
  --routines \
  --events \
  --triggers \
  --hex-blob \
  --master-data=2 \
  --databases app_db audit_db \
  --set-gtid-purged=ON \
  > /backup/app.sql
--single-transaction 只保证事务型表的一致性。若业务中存在 MyISAM 等非事务型表,应在备份期间停止相关写入,或改用经过验证的物理备份方式。备份期间还应暂停 DDL,避免表结构变化导致逻辑备份或复制失败。
如果未启用 GTID,则使用:
mysqldump -h SOURCE_HOST -u backup -p \
  --single-transaction \
  --routines \
  --events \
  --triggers \
  --hex-blob \
  --master-data=2 \
  --set-gtid-purged=OFF \
  --databases app_db audit_db \
  > /backup/app.sql
恢复前确认目标库是空的或已经经过明确清理,并验证备份文件完整:
sha256sum /backup/app.sql

mysql -h TARGET_HOST -u root -p < /backup/app.sql
如果备份中包含 SET @@GLOBAL.GTID_PURGED,目标库必须是没有冲突 GTID 历史的初始化实例。不要把已有生产数据的目标库直接当作空库恢复。
目标库恢复完成后,使用自动定位:
CHANGE REPLICATION SOURCE TO
    SOURCE_HOST='source.example.com',
    SOURCE_PORT=3306,
    SOURCE_USER='repl',
    SOURCE_PASSWORD='replace-with-replication-password',
    SOURCE_AUTO_POSITION=1,
    SOURCE_SSL=1,
    SOURCE_SSL_CA='/etc/mysql/ssl/ca.pem',
    SOURCE_SSL_VERIFY_SERVER_CERT=1;

START REPLICA;
从备份文件中找到 --master-data=2 写入的源库日志文件和位置,然后配置文件位置复制:
CHANGE REPLICATION SOURCE TO
    SOURCE_HOST='source.example.com',
    SOURCE_PORT=3306,
    SOURCE_USER='repl',
    SOURCE_PASSWORD='replace-with-replication-password',
    SOURCE_LOG_FILE='mysql-bin.000123',
    SOURCE_LOG_POS=456789,
    SOURCE_SSL=1,
    SOURCE_SSL_CA='/etc/mysql/ssl/ca.pem',
    SOURCE_SSL_VERIFY_SERVER_CERT=1;

START REPLICA;
GTID 自动定位和文件位置定位只能选择一种,不要同时配置。较早版本 MySQL 使用 MASTER、SLAVE 命名时,需要将 SOURCE、REPLICA 替换为对应的旧语法。
启动后检查复制状态:
SHOW REPLICA STATUS\G
至少确认以下条件:
Replica_IO_Running: YesReplica_SQL_Running: YesLast_IO_Error 为空Last_SQL_Error 为空Retrieved_Gtid_Set 持续增长Executed_Gtid_Set 能够追上源库Seconds_Behind_Source 没有持续扩大Seconds_Behind_Source=0 只能作为辅助指标。复制线程停止、没有新事务或存在长事务时,这个值可能为 0 或 NULL,不能单独作为最终切换依据。
目标库恢复完成并确认复制正常后,保持只读:
SET GLOBAL super_read_only = ON;
SET GLOBAL read_only = ON;
同时确认应用、报表和人工脚本无法把目标库当成生产写入端。
最终切换前先冻结所有可能产生数据库写入的入口:
可以通过以下查询辅助确认是否仍有长事务:
SELECT
    trx_mysql_thread_id,
    trx_started,
    trx_state,
    trx_query
FROM information_schema.innodb_trx
ORDER BY trx_started;
不要在没有确认业务影响的情况下批量执行 KILL。长事务应由对应业务负责人确认后处理。
如果使用 GTID,在写入冻结并等待活动事务排空后记录源库 GTID:
SELECT @@GLOBAL.gtid_executed AS source_gtid;
将结果保存到变更记录中,这个值就是目标库必须追平的最终标记。
如果没有 GTID,则记录源库当前 binlog 文件和位置:
SHOW BINARY LOG STATUS;
较早版本可以使用:
SHOW MASTER STATUS;
记录返回的 File 和 Position,不要在切换时重新估算位置。
目标库继续运行复制线程,直到执行位置达到刚才记录的标记。
GTID 模式可以在目标库执行:
SELECT GTID_SUBSET(
    'SOURCE_GTID_RECORDED_IN_STEP_2',
    @@GLOBAL.gtid_executed
) AS caught_up;
返回 1 表示记录的源库 GTID 集合已经包含在目标库已执行集合中。实际执行时,将占位文本替换为步骤 2 保存的 GTID 集合。
非 GTID 模式下,检查:
SHOW REPLICA STATUS\G
确认 Source_Log_File 和 Exec_Source_Log_Pos 已达到或超过源库记录的文件位置。若文件已经轮换,应根据日志序号和复制状态确认目标库确实越过了该位置。
只要出现以下任一情况,就不能进入切换:
Replica_IO_Running 或 Replica_SQL_Running 不是 YesLast_IO_Error 或 Last_SQL_Error 有内容最终同步完成后,源库已经停止业务写入,此时可以进行更可靠的一致性检查:
COUNT(*)。server_uuid 确实是新加坡目标服务器。例如,关键表可以执行:
SELECT
    COUNT(*) AS total_rows,
    MIN(id) AS min_id,
    MAX(id) AS max_id,
    MAX(updated_at) AS latest_update
FROM app_db.orders;
COUNT(*)、范围统计和应用验证应在源库写入已经冻结、复制已经追平之后进行。复制仍在追赶时直接比较行数,可能把正常的增量差异误判为数据丢失。
在目标库已追平、数据检查通过后,仍然保持业务写入开关关闭,按以下顺序切换:
目标库上的关键操作可以是:
STOP REPLICA;

SHOW REPLICA STATUS\G

SET GLOBAL super_read_only = OFF;
SET GLOBAL read_only = OFF;
应用切换前不要提前开放目标库写入。源库与目标库同时接受业务写入会形成双写,后续很难通过复制自动合并冲突。
源库应通过应用配置、网络访问控制或账号权限防止旧连接继续写入。必要时,在所有旧连接排空后将源库设置为只读:
SET GLOBAL super_read_only = ON;
SET GLOBAL read_only = ON;
如果运维、备份或审计程序依赖源库的特殊权限,先确认这些程序不会被只读设置中断,再执行该操作。
目标库开放写入后,先执行低风险的生产冒烟检查:
SELECT
    @@hostname AS db_hostname,
    @@server_uuid AS db_server_uuid,
    @@read_only AS read_only,
    @@global.time_zone AS time_zone,
    NOW() AS db_time;
随后观察:
低流量业务可以先观察 30~60 分钟;如果存在小时级、日级结算或批处理,应至少覆盖一个关键任务周期。观察时间应覆盖实际业务高峰或最容易触发的业务流程,而不是只看切换后的几分钟。
源库的备份、binlog 和目标库切换前快照不要立即删除,至少保留到观察期结束并满足既定恢复周期。
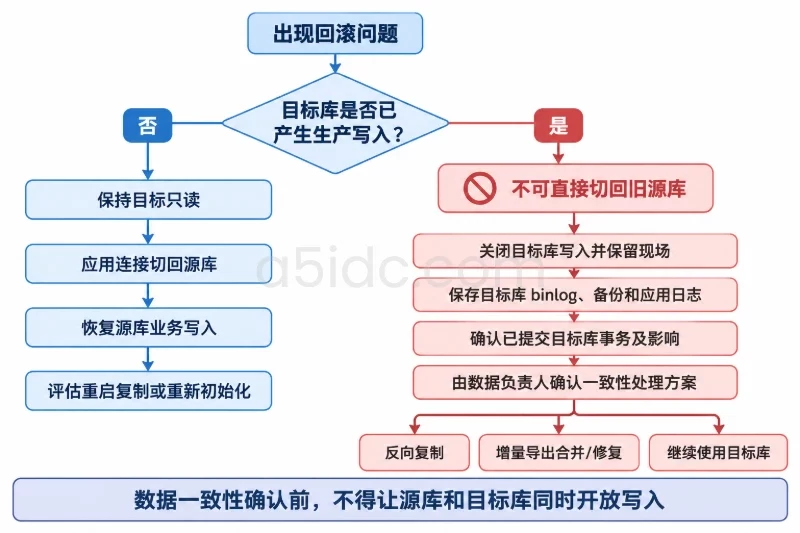
回滚条件应在变更前写入方案,不要等故障发生后临时判断。典型触发条件包括:
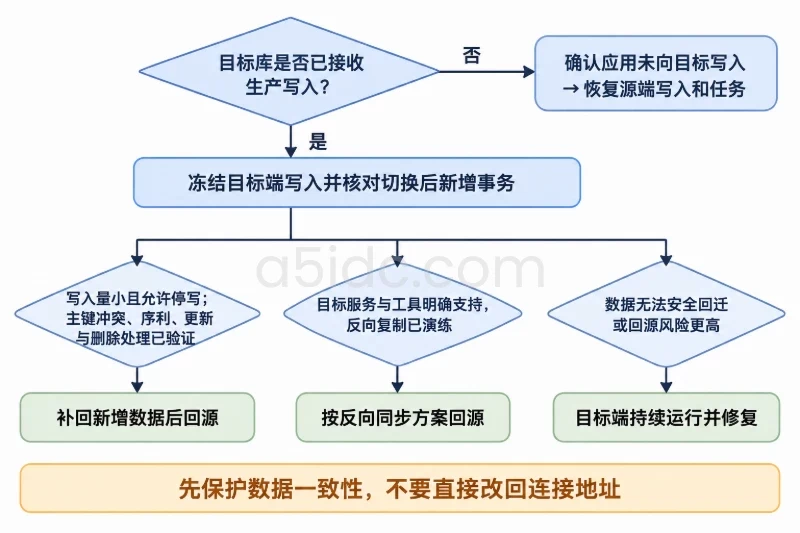
如果问题发生在目标库开放写入之前,处理相对简单:
如果目标库已经提交过生产事务,不能直接把应用指回旧源库。此时源库缺少目标库产生的新数据,强行切回会造成数据丢失或主键、状态冲突。
正确处理顺序是:
如果业务要求目标库写入后仍能在数分钟内快速切回,应在迁移前单独设计并演练反向复制或变更数据捕获方案,不能在故障发生后临时建立。对于大多数单主数据库迁移,较安全的做法是把“目标库开始接受生产写入”设为回滚边界,并在此之前完成全部连接、数据和业务验证。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9948.html