香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


要判断 C++ 数据采集程序是否出现消费速度不足,不能只看某一时刻的队列长度。更可靠的做法是在“收到数据、成功入队、取出任务、处理完成、处理失败”几个位置埋点,同时记录队列当前深度、最早任务等待时间、处理耗时分位数和活跃消费者数量。
当单位时间内进入队列的任务持续多于消费者取出的任务,或者消费者线程全部处于工作状态、处理耗时持续升高,就可以确认处理能力已经接近或低于输入速率。通过这些指标,还能区分是消费者数量不足、下游存储变慢、队列锁竞争,还是异常重试导致了积压。
围绕数据采集程序的持续运行与数据处理,A5数据提供香港、美国、日本等地区的物理服务器资源,配置涵盖不同CPU、内存及SSD、NVMe存储,可用于部署采集服务、接口和相关数据服务。各地区的硬件与网络方案有所不同,可按业务访问区域及处理、存储需求组织运行环境。
数据采集链路通常可以抽象为:
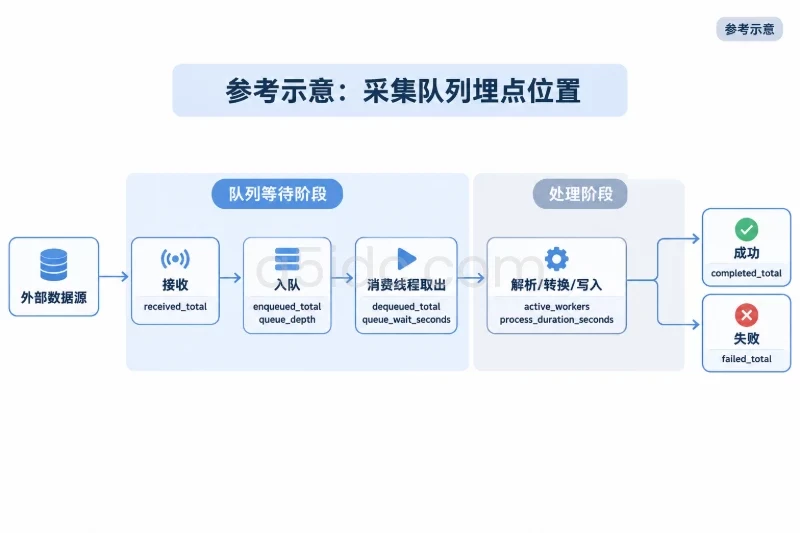
数据源 -> 接收 -> 入队 -> 消费线程取出 -> 解析/转换/写入 -> 成功或失败
每个阶段观察到的“速度”并不完全相同:
因此,建议至少定义以下指标。
| 指标 | 类型 | 记录时机 | 主要用途 |
|---|---|---|---|
received_total | Counter | 收到外部数据时 | 判断输入压力 |
enqueued_total | Counter | 成功放入队列后 | 计算队列进入速率 |
dequeued_total | Counter | 消费线程取出任务后 | 计算开始处理速率 |
completed_total | Counter | 任务成功完成后 | 计算有效处理速率 |
failed_total | Counter | 任务处理失败后 | 区分速度问题与异常问题 |
rejected_total | Counter | 队列已满或入队失败时 | 判断是否发生丢弃或背压 |
queue_depth | Gauge | 队列状态变化时 | 查看当前积压量 |
queue_capacity | Gauge | 程序启动或配置加载时 | 计算容量使用率 |
oldest_wait_seconds | Gauge | 监控抓取时 | 判断最早任务等待多久 |
active_workers | Gauge | 消费线程开始和结束处理时 | 判断消费者是否饱和 |
process_duration_seconds | Histogram | 任务处理完成时 | 观察平均耗时和分位数 |
queue_wait_seconds | Histogram | 消费线程取出任务时 | 观察任务在队列中等待多久 |
这里有一个容易混淆的地方:queue_depth 只表示尚未被消费者取出的任务数量。如果消费者已经取出任务,但都阻塞在数据库写入或网络请求上,队列长度可能不高,实际处理能力却已经饱和。因此还要同时观察 active_workers、completed_total 和处理耗时。
在一个时间窗口内,可以用下面的关系判断队列是否正在增长:
积压增长速度 = 入队速率 - 取出速率
如果要判断整个处理链路是否有未完成任务,则可以观察:
未完成任务增长速度 ≈ 入队速率 - 完成速率 - 终止失败速率
对于一个不允许静默丢失数据的采集程序,通常应满足:
enqueued_total ≈ completed_total + failed_terminal_total + 当前在途任务数
如果程序存在重试,enqueued_total 可能包含同一条逻辑数据的多次尝试。此时需要额外区分:
否则,重试产生的额外入队会被误认为普通输入增长。
队列容量使用率可以作为第一层告警:
队列使用率 = queue_depth / queue_capacity
但它不是唯一判断依据。容量为 10,000 的队列,如果每秒只能处理 10 条数据,积压 8,000 条可能意味着需要等待很长时间;容量为 1,000,000 的队列,即使使用率只有 20%,也可能已经超过数据时效要求。
更有价值的指标是预计填满时间:
预计填满时间 = (queue_capacity - queue_depth) / (入队速率 - 取出速率)
只有当入队速率大于取出速率时,这个公式才有意义。例如:
则净增长速度为:
900 - 640 = 260 条/秒
剩余容量为:
10,000 - 8,500 = 1,500 条
预计约:
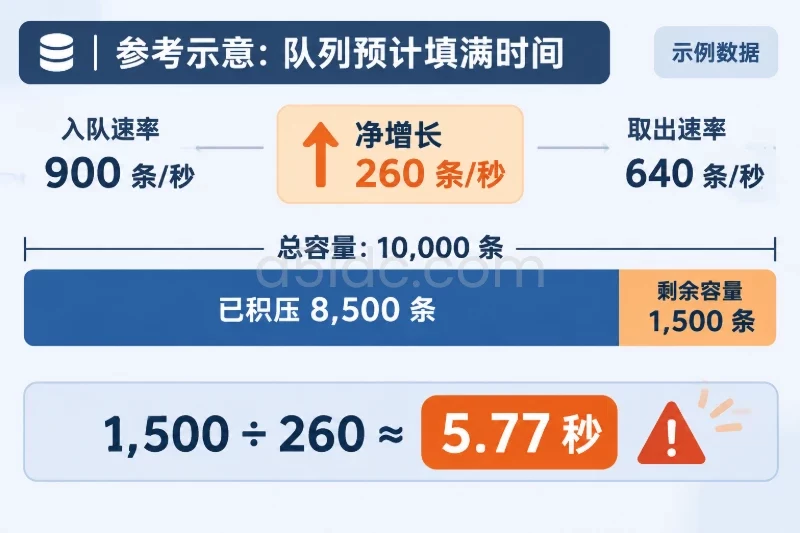
1,500 / 260 ≈ 5.77 秒
就会达到队列上限。此时即使队列还没有完全填满,也应该立即告警。
如果原有程序使用 std::queue、std::deque 或第三方线程安全队列,建议不要在业务代码外部定时读取长度,而是在队列封装层统一维护指标。这样可以确保入队成功、出队成功和队列长度变化对应起来。
任务等待时间和处理耗时应使用 std::chrono::steady_clock,而不是 system_clock:
steady_clock 不会因为系统校时或 NTP 调整而倒退;system_clock 适合记录日志中的日历时间;steady_clock 时间点互相相减。下面的代码使用 C++17 标准库实现一个带容量、入队时间和最早等待时间查询的队列。它不是完整的采集业务队列,而是可以嵌入现有项目的核心封装。
#include <array>
#include <atomic>
#include <chrono>
#include <condition_variable>
#include <cstdint>
#include <deque>
#include <mutex>
#include <optional>
#include <stdexcept>
#include <utility>

using Clock = std::chrono::steady_clock;

static std::uint64_t duration_us(Clock::duration duration) {
    const auto value =
        std::chrono::duration_cast<std::chrono::microseconds>(duration).count();

    return value > 0 ? static_cast<std::uint64_t>(value) : 0;
}

template <typename T>
class TimedQueue {
public:
    struct Entry {
        T value;
        Clock::time_point queued_at;
    };

    explicit TimedQueue(std::size_t capacity)
        : capacity_(capacity) {
        if (capacity_ == 0) {
            throw std::invalid_argument("queue capacity must be greater than zero");
        }
    }

    bool try_push(T value) {
        {
            std::lock_guard<std::mutex> lock(mutex_);

            if (stopped_ || items_.size() >= capacity_) {
                return false;
            }

            items_.push_back(Entry{
                std::move(value),
                Clock::now()
            });

            depth_.store(items_.size(), std::memory_order_release);
        }

        condition_.notify_one();
        return true;
    }

    std::optional<Entry> wait_pop() {
        std::unique_lock<std::mutex> lock(mutex_);

        condition_.wait(lock, [this] {
            return stopped_ || !items_.empty();
        });

        if (items_.empty()) {
            return std::nullopt;
        }

        Entry item = std::move(items_.front());
        items_.pop_front();

        depth_.store(items_.size(), std::memory_order_release);
        return std::optional<Entry>(std::move(item));
    }

    void stop() {
        {
            std::lock_guard<std::mutex> lock(mutex_);
            stopped_ = true;
        }

        condition_.notify_all();
    }

    std::size_t depth() const noexcept {
        return depth_.load(std::memory_order_acquire);
    }

    std::size_t capacity() const noexcept {
        return capacity_;
    }

    std::optional<std::uint64_t> oldest_wait_us() const {
        std::lock_guard<std::mutex> lock(mutex_);

        if (items_.empty()) {
            return std::nullopt;
        }

        return duration_us(Clock::now() - items_.front().queued_at);
    }

private:
    const std::size_t capacity_;

    mutable std::mutex mutex_;
    std::condition_variable condition_;
    std::deque<Entry> items_;

    std::atomic<std::size_t> depth_{0};
    bool stopped_{false};
};
这段实现有几个重要行为:
items_ 后,depth_ 才会增加。try_push 返回 false,调用方可以记录 rejected_total。wait_pop 在取出任务的同时减少当前队列深度。oldest_wait_us() 读取队首任务的入队时间,适合由监控抓取线程周期性调用。stop() 后仍会继续取出队列中已有的任务,队列为空后消费者才退出。如果现有队列使用阻塞式 push,也可以保留阻塞行为,但必须额外记录阻塞次数和阻塞时长。否则,生产者被背压后,外部输入速率下降,监控可能错误地认为系统已经恢复。
下面定义一个固定桶直方图,用于记录队列等待时间和处理时间。固定桶不会为每条数据创建标签,适合高频采集程序。
class FixedHistogram {
public:
    static constexpr std::size_t kBucketCount = 11;

    FixedHistogram() {
        for (auto& bucket : buckets_) {
            bucket.store(0, std::memory_order_relaxed);
        }
    }

    void observe_us(std::uint64_t value_us) {
        count_.fetch_add(1, std::memory_order_relaxed);
        sum_us_.fetch_add(value_us, std::memory_order_relaxed);

        const auto& bounds = bounds_us();

        // 每个桶使用累计计数,适合转换成 Prometheus histogram。
        for (std::size_t i = 0; i < kBucketCount; ++i) {
            if (value_us <= bounds[i]) {
                buckets_[i].fetch_add(1, std::memory_order_relaxed);
            }
        }
    }

    std::uint64_t count() const noexcept {
        return count_.load(std::memory_order_relaxed);
    }

    std::uint64_t sum_us() const noexcept {
        return sum_us_.load(std::memory_order_relaxed);
    }

    std::uint64_t bucket(std::size_t index) const noexcept {
        return buckets_[index].load(std::memory_order_relaxed);
    }

    static const std::array<std::uint64_t, kBucketCount>& bounds_us() {
        static const std::array<std::uint64_t, kBucketCount> bounds{
            1'000,       // 1 ms
            5'000,       // 5 ms
            10'000,      // 10 ms
            25'000,      // 25 ms
            50'000,      // 50 ms
            100'000,     // 100 ms
            250'000,     // 250 ms
            500'000,     // 500 ms
            1'000'000,   // 1 s
            5'000'000,   // 5 s
            30'000'000   // 30 s
        };

        return bounds;
    }

private:
    std::array<std::atomic<std::uint64_t>, kBucketCount> buckets_{};
    std::atomic<std::uint64_t> count_{0};
    std::atomic<std::uint64_t> sum_us_{0};
};

struct CollectorMetrics {
    std::atomic<std::uint64_t> received_total{0};
    std::atomic<std::uint64_t> enqueued_total{0};
    std::atomic<std::uint64_t> dequeued_total{0};
    std::atomic<std::uint64_t> completed_total{0};
    std::atomic<std::uint64_t> failed_total{0};
    std::atomic<std::uint64_t> rejected_total{0};

    std::atomic<std::uint64_t> active_workers{0};

    FixedHistogram queue_wait;
    FixedHistogram process_duration;
};
采集对象可以携带第一次收到数据的时间,用于进一步计算端到端新鲜度:
struct Sample {
    std::uint64_t id;
    std::string payload;
    Clock::time_point first_received_at;
};
如果数据会重试,重新入队时只更新队列内部的 queued_at,不要覆盖 first_received_at。这样可以分别得到:
生产者应该在收到数据后先增加 received_total,然后根据入队结果增加不同计数:
void submit_sample(
    Sample sample,
    TimedQueue<Sample>& queue,
    CollectorMetrics& metrics) {

    metrics.received_total.fetch_add(1, std::memory_order_relaxed);

    if (queue.try_push(std::move(sample))) {
        metrics.enqueued_total.fetch_add(1, std::memory_order_relaxed);
    } else {
        metrics.rejected_total.fetch_add(1, std::memory_order_relaxed);

        // 这里根据业务策略处理:
        // 1. 阻塞等待;
        // 2. 写入磁盘缓冲;
        // 3. 返回上游重试;
        // 4. 明确记录丢弃。
    }
}
不能在调用 try_push 之前就增加 enqueued_total。否则队列已满时,入队速率会被虚高,监控中的速率差无法对应真实积压。
对于有数据丢失要求的采集程序,队列满时不应直接静默丢弃。阻塞、磁盘暂存和上游重试各有影响:
假设现有项目中已有 process_one 函数,负责解析样本并写入下游。消费者线程可以这样埋点:
bool process_one(const Sample& sample);

void worker_loop(
    TimedQueue<Sample>& queue,
    CollectorMetrics& metrics) {

    while (true) {
        auto item = queue.wait_pop();

        if (!item.has_value()) {
            return;
        }

        metrics.dequeued_total.fetch_add(1, std::memory_order_relaxed);

        const auto dequeue_time = Clock::now();
        metrics.queue_wait.observe_us(
            duration_us(dequeue_time - item->queued_at));

        metrics.active_workers.fetch_add(1, std::memory_order_relaxed);

        const auto process_begin = Clock::now();
        bool success = false;

        try {
            success = process_one(item->value);
        } catch (...) {
            // 生产代码应记录任务ID、异常类型和下游错误。
            // 是否重试应由独立策略决定,不能在这里无限重试。
            success = false;
        }

        const auto process_end = Clock::now();

        metrics.process_duration.observe_us(
            duration_us(process_end - process_begin));

        if (success) {
            metrics.completed_total.fetch_add(
                1, std::memory_order_relaxed);
        } else {
            metrics.failed_total.fetch_add(
                1, std::memory_order_relaxed);
        }

        metrics.active_workers.fetch_sub(1, std::memory_order_relaxed);
    }
}
这里的 process_duration 只包括消费者取出任务后的处理阶段,不包括排队等待。如果希望监控完整的新鲜度,还可以增加:
const auto end_to_end_us =
    duration_us(process_end - item->value.first_received_at);
然后单独记录 end_to_end_duration。不要把队列等待和处理时间混在同一个指标中,否则无法判断瓶颈到底发生在队列前还是下游处理阶段。
如果 process_one 内部是批量处理,还需要明确计数单位。例如一次取出 100 条记录并批量写入数据库时:
dequeued_total 可以按批次统计;dequeued_records_total 按记录数统计;process_duration 记录一批的耗时;processed_records_total 记录成功写入的记录数。告警时应优先使用同一计量口径,不能拿“批次数/秒”直接和“记录数/秒”比较。
如果项目已有 HTTP 管理端点,可以在 /metrics 或现有监控接口中输出这些指标。C++ 标准库不包含 HTTP 服务,因此不应在业务代码中假设某个具体 Web 框架。核心是把采集到的原始值按照所用监控系统的格式暴露出去。
以 Prometheus 文本格式为例,可以暴露:
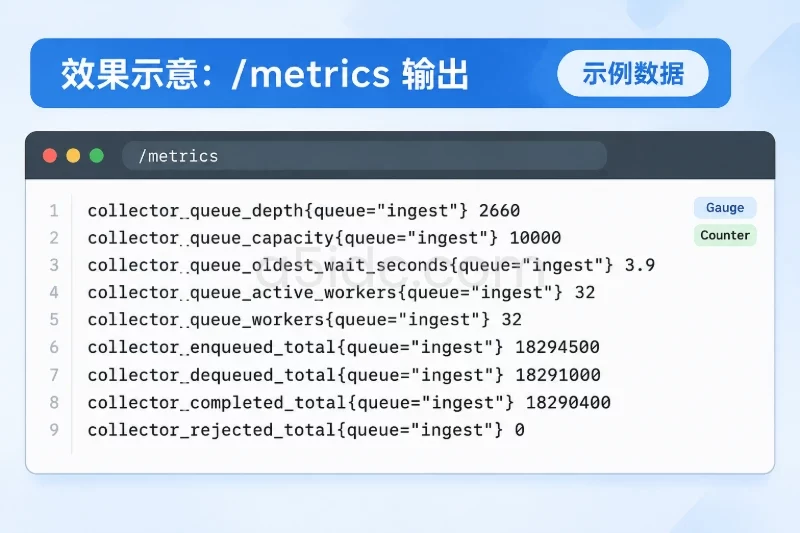
# TYPE collector_queue_depth gauge
collector_queue_depth{queue="ingest"} 2660

# TYPE collector_queue_capacity gauge
collector_queue_capacity{queue="ingest"} 10000

# TYPE collector_queue_oldest_wait_seconds gauge
collector_queue_oldest_wait_seconds{queue="ingest"} 3.9

# TYPE collector_queue_active_workers gauge
collector_queue_active_workers{queue="ingest"} 32

# TYPE collector_queue_workers gauge
collector_queue_workers{queue="ingest"} 32

# TYPE collector_enqueued_total counter
collector_enqueued_total{queue="ingest"} 18294500

# TYPE collector_dequeued_total counter
collector_dequeued_total{queue="ingest"} 18291000

# TYPE collector_completed_total counter
collector_completed_total{queue="ingest"} 18290400

# TYPE collector_rejected_total counter
collector_rejected_total{queue="ingest"} 0
直方图需要把微秒转换成秒:
# TYPE collector_process_duration_seconds histogram
collector_process_duration_seconds_bucket{queue="ingest",le="0.01"} 12000
collector_process_duration_seconds_bucket{queue="ingest",le="0.05"} 96500
collector_process_duration_seconds_bucket{queue="ingest",le="0.1"} 110200
collector_process_duration_seconds_bucket{queue="ingest",le="1"} 115000
collector_process_duration_seconds_bucket{queue="ingest",le="+Inf"} 115100
collector_process_duration_seconds_sum{queue="ingest"} 4820.35
collector_process_duration_seconds_count{queue="ingest"} 115100
在导出时需要注意:
queue_depth 和 active_workers 是 Gauge;received_total、enqueued_total、completed_total 是 Counter;rate 或 increase;le 的单位必须和指标名一致,这里是秒;如果程序有多个实例,不能简单平均所有指标。例如:
sum;sum;max;阈值应结合数据时效要求和队列的实际排空能力设置。下面的 60%、85% 和 5 分钟只是常用的起始值,不是所有程序都适用的固定标准。
如果目标是发现“任务还没有被消费者取出”,应比较 enqueued_total 和 dequeued_total:
groups:
  - name: collector-queue
    rules:
      - alert: CollectorQueueGrowing
        expr: |
          collector_queue_capacity{queue="ingest"} > 0
          and (
            collector_queue_depth{queue="ingest"}
            /
            collector_queue_capacity{queue="ingest"}
          ) > 0.60
          and rate(collector_enqueued_total{queue="ingest"}[5m])
              >
              rate(collector_dequeued_total{queue="ingest"}[5m]) * 1.05
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "采集队列持续增长"
          description: "入队速率持续高于消费者取出速率"

      - alert: CollectorQueueNearCapacity
        expr: |
          collector_queue_capacity{queue="ingest"} > 0
          and (
            collector_queue_depth{queue="ingest"}
            /
            collector_queue_capacity{queue="ingest"}
          ) > 0.85
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "采集队列接近容量上限"
          description: "需要检查消费者、下游存储和重试情况"
这里使用 5% 的差异作为缓冲,是为了减少计数误差和短时波动造成的告警。对于有明显周期性的采集程序,窗口可以从 5 分钟调整到 10 分钟或 15 分钟,但窗口过长会延迟发现问题。
队列长度没有明显增长,并不代表处理能力正常。消费者可能已经全部取出任务并阻塞在下游服务上。因此还需要观察活跃消费者和处理耗时:
      - alert: CollectorWorkersSaturated
        expr: |
          collector_queue_workers{queue="ingest"} > 0
          and (
            collector_queue_active_workers{queue="ingest"}
            /
            collector_queue_workers{queue="ingest"}
          ) > 0.90
          and histogram_quantile(
                0.95,
                sum by (queue, le) (
                  rate(collector_process_duration_seconds_bucket{
                    queue="ingest"
                  }[5m])
                )
              ) > 0.20
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "采集消费者接近饱和"
          description: "活跃消费者比例较高且处理耗时P95超过阈值"
0.20 表示 200 毫秒示例阈值。实际值应根据数据时效要求和正常处理耗时设置。如果单条数据处理允许 2 秒,就不能直接套用 200 毫秒。
对于有明确时效要求的数据,最早等待时间往往比队列使用率更直接:
      - alert: CollectorOldestTaskTooOld
        expr: |
          collector_queue_oldest_wait_seconds{queue="ingest"} > 30
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "采集任务等待时间过长"
          description: "队首任务等待时间超过数据时效阈值"
如果业务要求数据在 10 秒内落库,30 秒就不适合作为阈值。可以设置:
告警恢复阈值应低于触发阈值。例如触发条件是队列使用率超过 85%,恢复条件可以设为低于 50%,并持续 10 分钟。这样可以避免队列在 84% 和 86% 之间来回波动,产生重复通知。
下面是一组用于说明判断过程的示例数据,数值为演示用途:
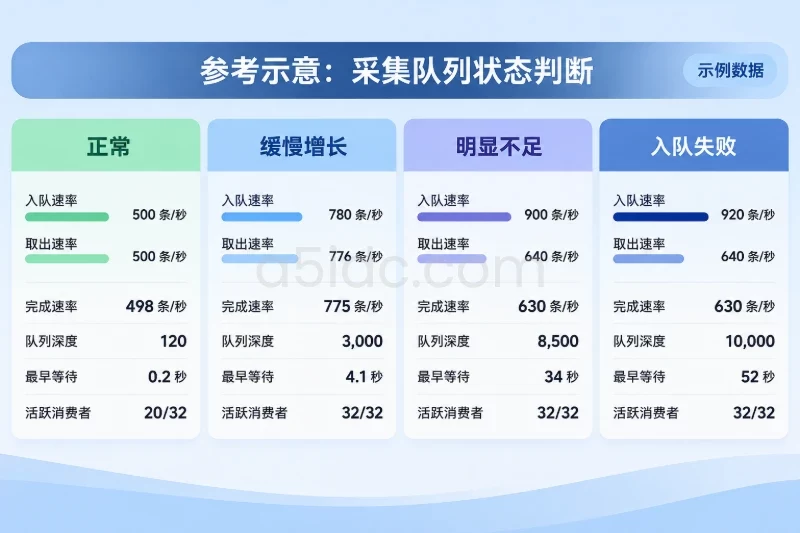
| 状态 | 入队速率 | 取出速率 | 完成速率 | 队列深度 | 最早等待 | 活跃消费者 |
|---|---|---|---|---|---|---|
| 正常 | 500 条/秒 | 500 条/秒 | 498 条/秒 | 120 | 0.2 秒 | 20/32 |
| 缓慢增长 | 780 条/秒 | 776 条/秒 | 775 条/秒 | 3,000 | 4.1 秒 | 32/32 |
| 明显不足 | 900 条/秒 | 640 条/秒 | 630 条/秒 | 8,500 | 34 秒 | 32/32 |
| 入队失败 | 920 条/秒 | 640 条/秒 | 630 条/秒 | 10,000 | 52 秒 | 32/32 |
第二行的净增长速度约为:
780 - 776 = 4 条/秒
如果 5 分钟内队列从 1,800 增长到 3,000,增长量为:
3,000 - 1,800 = 1,200 条
5 分钟共有 300 秒,因此实际增长速度为:
1,200 / 300 = 4 条/秒
这说明速率指标和队列实际变化相互吻合。虽然当前还没有立刻填满队列,但 32 个消费者都处于工作状态,说明已经没有明显的空闲处理能力。
第三行中,净增长速度为:
900 - 640 = 260 条/秒
剩余容量只有 1,500 条,预计约 5.77 秒填满。此时应优先采取降低输入、增加消费者、缩短下游写入时间或启用可靠暂存等措施,而不是仅仅调高队列容量。
第四行说明队列已经满了。此时要检查 rejected_total 是否增长:
这通常表示输入速率超过了当前消费者数量能够承担的速率。可以进一步计算每个消费者的平均处理能力:
单消费者平均能力 ≈ 完成速率 / 活跃消费者数
如果增加消费者后完成速率近似线性提升,说明主要瓶颈是并发度不足。如果增加线程没有明显改善,则可能受制于数据库连接池、文件锁、CPU 或下游限流。
这种情况不能直接归因于消费速度不足,应优先检查:
wait_pop 是否因为停止标志提前返回;如果 oldest_wait_seconds 持续增长,而 active_workers 接近零,通常比“增加消费者数量”更应该先检查线程生命周期。
这常见于消费者取出任务后阻塞在下游:
此时应同时记录下游操作耗时和错误码。仅记录总处理时间,只能知道“变慢”,不能知道慢在哪里。
这更接近业务失败或依赖故障,而不是消费速度问题。例如消费者能够持续取出任务,但大部分任务在解析、校验或写入时失败。
建议把失败拆成至少几类:
parse_failed_total
validation_failed_total
storage_failed_total
timeout_total
retry_total
terminal_failed_total
不同类别应使用不同告警。数据格式错误通常不应和数据库连接失败共用同一个“消费不足”告警。
如果处理失败后立即重新入队,可能形成如下循环:
处理失败 -> 重新入队 -> 再次处理 -> 再次失败
这会让入队速率持续高于完成速率,即使原始数据输入已经恢复正常。建议:
retry_total;接入监控后,不要只查看“指标有值”。应在测试环境人为构造几种状态,验证每个计数器的变化关系。
准备固定数量的数据,例如 1,000 条,使用处理时间稳定的模拟函数:
bool process_one(const Sample& sample) {
    (void)sample;
    std::this_thread::sleep_for(std::chrono::milliseconds(5));
    return true;
}
应观察到:
received_total     增加 1,000
enqueued_total     增加 1,000
dequeued_total     增加 1,000
completed_total    增加 1,000
failed_total       不增加
rejected_total     不增加
如果 completed_total 少于 dequeued_total,需要检查处理函数返回值和异常路径。若 queue_wait 的桶全部为零,也要确认是否真的记录了取出时间,而不是把处理结束时间误当成等待结束时间。
在测试环境中让处理函数增加固定延迟,例如每条 100 毫秒,同时以更高速度提交数据。预期结果是:
queue_depth 持续增加;oldest_wait_seconds 持续增加;active_workers / worker_count 接近 1;process_duration_seconds 的 P95 上升;enqueued_total 的速率大于 dequeued_total;rejected_total 开始增长,或者生产者出现可观测阻塞。让 process_one 对部分任务返回 false 或抛出异常,检查:
failed_total 是否增加;active_workers 是否最终恢复;completed_total + failed_total 是否与 dequeued_total 大致对应。特别要检查异常路径是否漏掉 active_workers.fetch_sub(1)。如果漏减,监控会长期显示消费者已经满载,即使线程实际上已经空闲。
queue_depth 可以在每次入队和出队时更新原子值,但 oldest_wait_seconds 通常只需要在监控抓取时读取。没有必要为每条数据启动计时器或写一条日志。
高吞吐场景下建议:
如果使用无界队列,只观察当前长度,可能等到进程内存接近耗尽才发现问题。可以增加一个逻辑软容量:
soft_capacity = 允许的内存占用 / 单条任务估算大小
同时记录:
如果任务大小差异很大,仅看元素数量可能低估内存风险。
例如单条任务平均占用约 2 KB,内存预算为 512 MB,不能直接用 512 / 2 得出数量,必须统一单位:
512 MB = 512 × 1024 × 1024 字节
2 KB = 2 × 1024 字节
可容纳数量约为:
(512 × 1024 × 1024) / (2 × 1024) = 262,144 条
实际容量还要扣除对象管理、字符串扩容、线程栈、连接池和程序其他内存。因此这个结果只能作为估算,不应直接作为生产配置。
增加线程适合以下情况:
如果瓶颈是单数据库连接、全局锁、单文件写入或下游限流,增加线程只会增加上下文切换和失败重试。此时更适合优化批量写入、减少锁持有时间、扩大连接池或调整下游并发限制。
简单采集程序可以使用一个队列:
接收 -> 队列 -> 解析并写入
当解析、转换和持久化速度差异较大时,可以拆成多个阶段:
接收 -> 原始队列 -> 解析队列 -> 写入队列 -> 存储
拆分后必须为每个队列分别记录:
不要把多个阶段的积压简单相加后只生成一个总告警,否则会隐藏真正的瓶颈位置。
日常排查可以按照以下顺序查看:
queue_depth / queue_capacity,确认是否接近容量上限。enqueued_total 与 dequeued_total 的速率差。oldest_wait_seconds,判断是否已经影响数据时效。active_workers / worker_count,确认消费者是否饱和。failed_total、rejected_total 和 retry_total,排除异常放大。当队列深度、速率差、最早等待时间和活跃消费者状态能够相互印证时,监控告警就不再只是“队列超过某个数字”,而是能够说明系统正在以什么速度积压、还能维持多久,以及应优先检查哪一层。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9909.html