香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


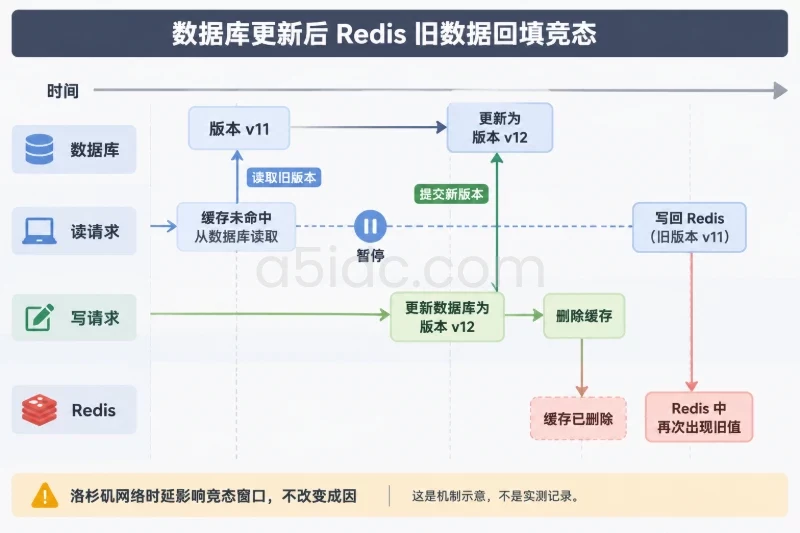
数据库更新与 Redis 之间没有跨系统事务,单纯在 SQL 提交后执行 DEL,仍可能出现旧数据回填:读请求先从数据库读到旧版本,随后写请求提交新版本并删除缓存,最后那个读请求才把旧值写回 Redis。洛杉矶服务器的网络时延会影响这个竞态窗口,但不会改变它的成因。
较稳妥的处理方式是:在数据库事务中同时保存业务更新和一条待处理的缓存失效事件;事件携带递增版本号,由 Redis 原子地记录已失效到哪个版本,并拒绝低版本的缓存写入。这样既能应对进程中断和重复投递,也能避免较早的读请求覆盖新数据。
如果业务只要求短暂的最终一致性,可以由后台任务投递失效事件,Redis 不可用时继续重试。此时数据库提交后、事件处理前,读请求仍可能短暂读到旧缓存。
如果写接口返回成功后就要求后续读请求看到新版本,应在返回成功前等待 Redis 完成版本标记。后台事件仍应保留,作为进程崩溃或 Redis 超时后的补偿。数据库已经提交但 Redis 暂不可用时,不要把结果误报为“数据库未写入”;应明确表示缓存同步待处理,并通过幂等请求或事件重试完成恢复。
为每条记录维护单调递增的 cache_version。更新业务数据时,在同一个数据库事务中递增版本号并写入 outbox。以下 SQL 以 PostgreSQL 为例,假设业务表已有 cache_version 列:
BEGIN;

WITH changed AS (
    UPDATE item
    SET title = $1,
        cache_version = cache_version + 1
    WHERE id = $2
    RETURNING id, cache_version
)
INSERT INTO cache_outbox (entity_type, entity_id, version)
SELECT 'item', id, cache_version
FROM changed;

COMMIT;
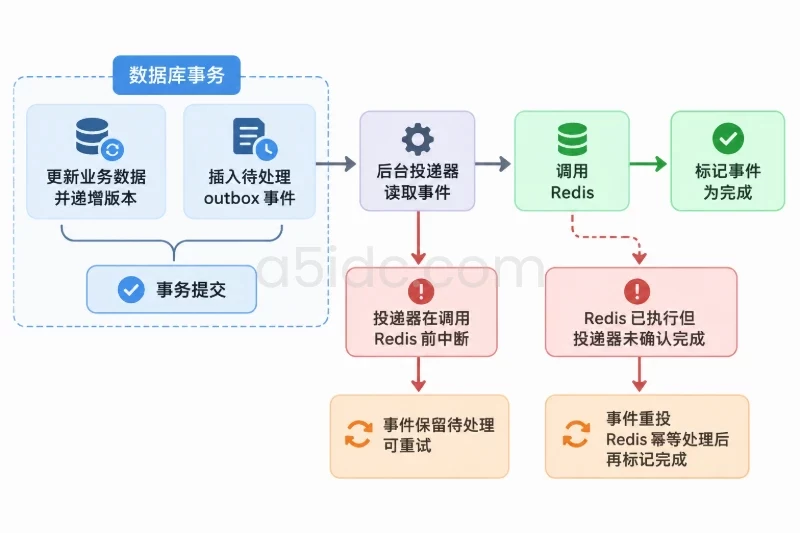
cache_outbox 至少需要保存事件类型、记录 ID、版本号和处理状态。业务更新与事件插入同处一个事务,因此不会出现“数据库已提交,但进程在写失效事件之前退出,事件永久丢失”的情况。实际项目还应处理 UPDATE 未匹配到记录的分支,并为新建、删除操作分别写入对应事件。
后台投递器读取待处理事件,调用 Redis 后再标记事件完成。若进程在 Redis 已处理、数据库尚未标记完成时退出,事件会再次投递;因此 Redis 操作必须幂等。若事件乱序到达,也不能让较旧版本覆盖较新版本。
缓存值和失效水位分开存储。下面使用 Redis Hash 保存缓存版本和 JSON 数据,使用独立的 String 保存已知的最低有效版本。两个键带有相同的 Redis Cluster hash tag,能够落在同一槽位,由 Lua 脚本原子处理。
版本在 Redis 中格式化为固定宽度的十进制字符串。以下示例假设版本是非负的 64 位整数;固定宽度后可以直接做字符串比较,不依赖 Lua 数值的精度范围。
import json

MARK_VERSION_LUA = """
local watermark = redis.call('GET', KEYS[1])

if (not watermark) or ARGV[1] > watermark then
    redis.call('SET', KEYS[1], ARGV[1])
    watermark = ARGV[1]
end

local cached_version = redis.call('HGET', KEYS[2], 'v')
if cached_version and cached_version < watermark then
    redis.call('DEL', KEYS[2])
end

return watermark
"""

FILL_CACHE_LUA = """
local watermark = redis.call('GET', KEYS[1])
if watermark and ARGV[1] < watermark then
    return 0
end

local cached_version = redis.call('HGET', KEYS[2], 'v')
if cached_version and cached_version > ARGV[1] then
    return 0
end

redis.call('HSET', KEYS[2], 'v', ARGV[1], 'data', ARGV[2])
redis.call('EXPIRE', KEYS[2], ARGV[3])
return 1
"""


def redis_item_keys(item_id: int) -> tuple[str, str]:
    # {item_id} 是 Redis Cluster hash tag,两个键会位于同一槽位。
    tag = f"{{{item_id}}}"
    return f"item:{tag}:watermark", f"item:{tag}:data"


def version_token(version: int) -> str:
    if version < 0 or version > 9_223_372_036_854_775_807:
        raise ValueError("version 必须是非负的 64 位整数")
    return f"{version:020d}"


def mark_item_version(redis_client, item_id: int, version: int) -> None:
    watermark_key, data_key = redis_item_keys(item_id)
    redis_client.eval(
        MARK_VERSION_LUA,
        2,
        watermark_key,
        data_key,
        version_token(version),
    )


def fill_item_cache(
    redis_client,
    item_id: int,
    version: int,
    payload: dict,
    ttl_seconds: int = 300,
) -> bool:
    watermark_key, data_key = redis_item_keys(item_id)
    result = redis_client.eval(
        FILL_CACHE_LUA,
        2,
        watermark_key,
        data_key,
        version_token(version),
        json.dumps(payload, ensure_ascii=False, separators=(",", ":")),
        int(ttl_seconds),
    )
    return result == 1
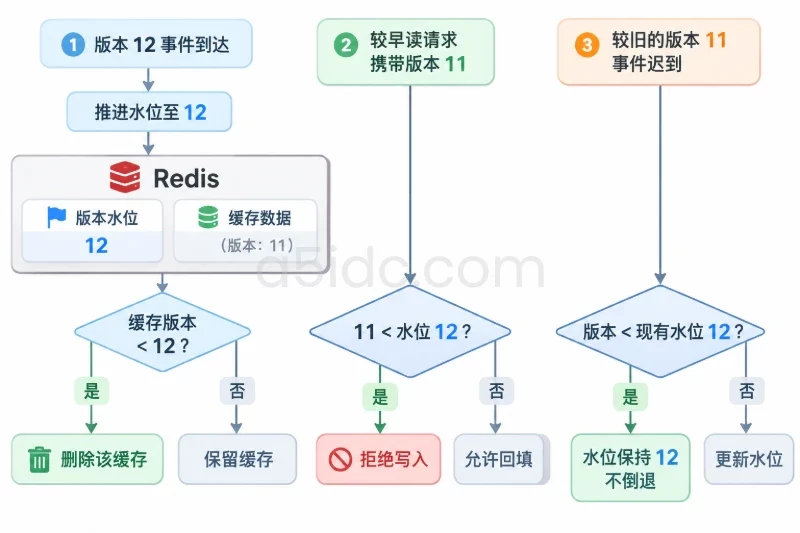
更新事件中的版本号为 12 时,mark_item_version 会把水位推进到 12,并删除低于 12 的缓存。若有一个较早的读请求随后拿着版本 11 执行 fill_item_cache,Lua 脚本会拒绝写入。版本 11 的事件晚于版本 12 到达时,水位也不会倒退。
缓存查询路径应遵循这个顺序:
outbox 投递应采用“Redis 成功后再标记事件完成”的顺序。Redis 调用超时时,客户端无法确定脚本是否已执行:可能是请求未到达,也可能是脚本已执行但响应丢失。按原版本重试是安全的,因为推进水位和删除低版本缓存都是幂等操作。
进程在数据库提交后、调用 Redis 前退出时,待处理事件仍保留在 outbox 中;进程在 Redis 成功后、确认事件前退出时,重复投递也不会回退水位。多投递器并发处理时,可使用数据库支持的租约或行锁领取事件,但不应在持有长时间数据库事务的同时等待 Redis 网络请求。
缓存 TTL 是内存占用和异常情况下的兜底,不是防止旧数据回填的主要机制。水位键若提前过期或被内存淘汰,旧读请求就可能再次通过校验;需要版本栅栏时,应确保水位不会独立于缓存数据被随意淘汰,并监控 Redis 内存和淘汰策略。永久保留水位会增加键数量,若要清理,必须先明确旧请求最长执行时间、事件最大延迟和可接受的一致性边界。
删除记录时也要考虑旧请求回填:应让删除操作产生更高版本的墓碑或等价事件,而不是只删除数据库行后再清缓存。否则,删除前读取到的旧数据仍可能在稍后重新进入缓存。
洛杉矶服务器只是部署位置,缓存失效语义取决于应用、数据库和 Redis 的实际拓扑。多个应用实例应使用同一套 Redis 主写入口;若还使用进程内缓存,Redis 删除不会自动清理其他实例的本地副本,需要额外的版本检查或失效通知。跨区域异步复制的缓存也可能在失效传播期间读到旧值,严格读后写场景应避免从尚未确认新版本的副本读取。
针对文中涉及的洛杉矶部署环境,A5数据可提供美国独立服务器资源,其中包括合作供应的洛杉矶节点;相关配置涵盖锐龙、EPYC等平台,并有不同内存容量与NVMe存储方案,可为应用及数据服务提供相应的计算和存储资源。各机型的硬件与节点配置按对应方案提供。
上线前可用少量并发测试区分关键分支:
生产监控至少应关注 outbox 待处理数量与最老事件延迟、Redis 脚本错误和超时、旧版本回填拒绝次数,以及缓存命中率。判断方案是否生效时,关键不是只看命中率,而是确认数据库提交、Redis 水位推进和读请求回填三者的先后关系符合预期。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9908.html