香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


知识库编辑器处理粘贴内容时,可以保留段落、标题、列表、粗体、链接和基础表格,同时删除脚本、事件属性、内联样式及不需要的嵌入内容。实现上不要把剪贴板里的 HTML 直接写入编辑区:浏览器端先按白名单清理并插入,服务端保存前再清理一次,页面展示时只渲染经过处理的内容。
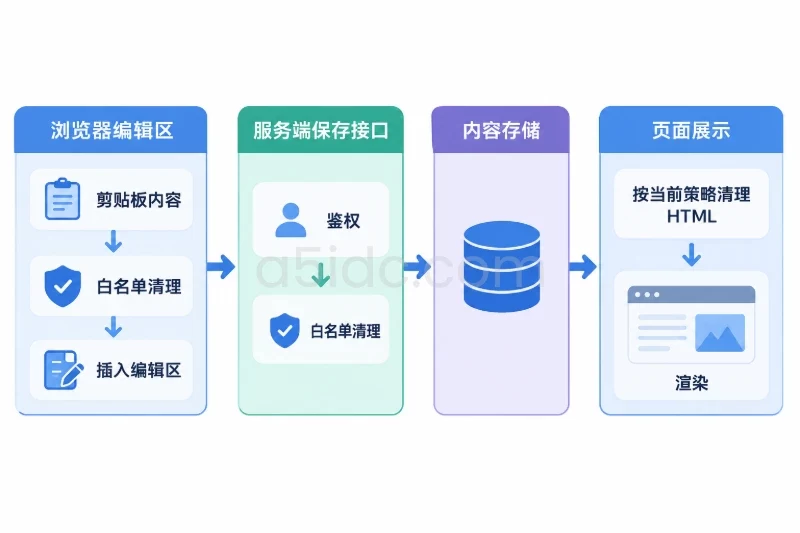
下面用原生 contenteditable 展示粘贴流程,配合 DOMPurify 做浏览器端过滤、sanitize-html 做服务端过滤。白名单由业务需要决定;示例保留常用文档格式,不允许粘贴图片、视频、表单或 iframe。若编辑器已使用 TipTap、ProseMirror 等框架,应将插入操作改为该框架的事务或命令接口,避免直接操作 DOM 与编辑器内部状态冲突。
富文本的安全边界由允许的标签和属性构成。标签白名单控制内容结构,属性白名单则控制链接、表格跨行跨列等必要行为。不要通过“删除几个已知危险标签”的方式过滤,因为未知标签和属性仍可能带来风险。
示例策略保留:
http、https 和 mailto;colspan、rowspan。示例策略不保留 style、class、事件处理属性、图片和嵌入式内容。粘贴内容里的字体、颜色、背景、字号等样式可能携带冗余标记或造成不一致,因此这里只保留结构化格式。若产品确实需要字号或颜色,应增加受控的格式枚举,并将其转换为编辑器支持的样式,而不是放行任意 CSS。
安装 DOMPurify:
npm install dompurify
以下代码放在编辑器前端模块中。示例只接管编辑器区域内的粘贴操作:优先读取剪贴板 HTML,经过清理后再插入;没有 HTML 时,将纯文本按换行转换为 <br>。插入过程使用 DOM 节点,不把剪贴板内容交给 innerHTML。
import DOMPurify from 'dompurify';

const editor = document.querySelector('#kb-editor');

const pastePolicy = {
  ALLOWED_TAGS: [
    'p', 'br', 'div',
    'h2', 'h3', 'h4',
    'strong', 'b', 'em', 'i', 'u', 's',
    'ul', 'ol', 'li',
    'blockquote', 'pre', 'code',
    'a',
    'table', 'thead', 'tbody', 'tr', 'th', 'td'
  ],
  ALLOWED_ATTR: ['href', 'title', 'colspan', 'rowspan'],
  ALLOW_DATA_ATTR: false,
  RETURN_DOM_FRAGMENT: true
};

function isAllowedHref(value) {
  if (typeof value !== 'string') return false;

  const href = value.trim();
  if (!href || href.startsWith('//')) return false;

  const hasScheme = /^[a-z][a-z\d+.-]*:/i.test(href);

  try {
    const parsed = new URL(href, 'https://paste.invalid/');
    const allowedProtocols = new Set(['http:', 'https:', 'mailto:']);

    if (!allowedProtocols.has(parsed.protocol)) return false;

    // 相对地址只能解析到示例基准域名,避免把特殊写法当成本地路径。
    if (!hasScheme && parsed.origin !== 'https://paste.invalid') {
      return false;
    }

    return true;
  } catch {
    return false;
  }
}

function sanitizeClipboardHtml(html) {
  const fragment = DOMPurify.sanitize(html, pastePolicy);

  fragment.querySelectorAll('a').forEach((link) => {
    const href = link.getAttribute('href');

    if (!isAllowedHref(href)) {
      link.removeAttribute('href');
    }
  });

  fragment.querySelectorAll('td, th').forEach((cell) => {
    for (const attr of ['colspan', 'rowspan']) {
      const value = cell.getAttribute(attr);
      if (value === null) continue;

      const number = Number(value);
      if (!Number.isInteger(number) || number < 1 || number > 20) {
        cell.removeAttribute(attr);
      } else {
        cell.setAttribute(attr, String(number));
      }
    }
  });

  return fragment;
}

function plainTextToFragment(text) {
  const fragment = document.createDocumentFragment();
  const lines = text.split(/\r\n?|\n/);

  lines.forEach((line, index) => {
    if (index > 0) fragment.appendChild(document.createElement('br'));
    fragment.appendChild(document.createTextNode(line));
  });

  return fragment;
}

function insertFragment(fragment) {
  const selection = window.getSelection();
  if (!selection || selection.rangeCount === 0) return;

  const range = selection.getRangeAt(0);
  if (!editor.contains(range.commonAncestorContainer)) return;

  range.deleteContents();

  const lastNode = fragment.lastChild;
  range.insertNode(fragment);

  if (lastNode) {
    range.setStartAfter(lastNode);
    range.collapse(true);
    selection.removeAllRanges();
    selection.addRange(range);
  }
}

editor.addEventListener('paste', (event) => {
  const clipboard = event.clipboardData;
  const selection = window.getSelection();

  if (!clipboard || !selection || selection.rangeCount === 0) return;
  if (!editor.contains(selection.anchorNode)) return;

  const html = clipboard.getData('text/html');
  const text = clipboard.getData('text/plain');

  let fragment;

  if (html) {
    fragment = sanitizeClipboardHtml(html);

    // HTML 被白名单全部移除时,仍可退回到安全的纯文本。
    if (fragment.childNodes.length === 0 && text) {
      fragment = plainTextToFragment(text);
    }
  } else {
    fragment = plainTextToFragment(text);
  }

  event.preventDefault();
  insertFragment(fragment);
});
编辑区域可以用简单的 HTML 骨架承载:
<div id="kb-editor" contenteditable="true" aria-label="知识库正文"></div>
这段示例用于说明粘贴过滤的关键路径。原生 contenteditable 的撤销历史、光标边界、输入法行为和复杂表格编辑需要额外验证;生产环境若已有编辑器框架,应通过其 API 读取和插入剪贴板内容。不要同时让框架的粘贴插件和这段监听器重复处理同一次粘贴。
浏览器端清理不能代替服务端校验。请求可以绕过网页直接提交,旧客户端也可能没有当前策略。服务端应当在鉴权通过后,对收到的 HTML 再做一次过滤;请求体大小也应设置上限,避免超大粘贴内容占用过多资源。
安装 sanitize-html:
npm install sanitize-html
下面的函数可放在 Node.js 服务端的内容处理模块中。表格单元格只接受 1 到 20 的整数跨行或跨列值;不安全链接会变成无属性的 span,随后因不在白名单内而被移除,链接文字仍保留。
import sanitizeHtml from 'sanitize-html';

function isAllowedHref(value) {
  if (typeof value !== 'string') return false;

  const href = value.trim();
  if (!href || href.startsWith('//')) return false;

  const hasScheme = /^[a-z][a-z\d+.-]*:/i.test(href);

  try {
    const parsed = new URL(href, 'https://paste.invalid/');
    const allowedProtocols = new Set(['http:', 'https:', 'mailto:']);

    if (!allowedProtocols.has(parsed.protocol)) return false;

    if (!hasScheme && parsed.origin !== 'https://paste.invalid') {
      return false;
    }

    return true;
  } catch {
    return false;
  }
}

function safeCellAttributes(attributes) {
  const result = {};

  for (const attr of ['colspan', 'rowspan']) {
    const value = attributes[attr];
    if (value === undefined) continue;

    const number = Number(value);
    if (Number.isInteger(number) && number >= 1 && number <= 20) {
      result[attr] = String(number);
    }
  }

  return result;
}

const knowledgeHtmlPolicy = {
  allowedTags: [
    'p', 'br', 'div',
    'h2', 'h3', 'h4',
    'strong', 'b', 'em', 'i', 'u', 's',
    'ul', 'ol', 'li',
    'blockquote', 'pre', 'code',
    'a',
    'table', 'thead', 'tbody', 'tr', 'th', 'td'
  ],
  allowedAttributes: {
    a: ['href', 'title'],
    th: ['colspan', 'rowspan'],
    td: ['colspan', 'rowspan']
  },
  allowedSchemes: ['http', 'https', 'mailto'],
  allowProtocolRelative: false,
  disallowedTagsMode: 'discard',
  transformTags: {
    a: (_tagName, attributes) => {
      if (!isAllowedHref(attributes.href)) {
        return { tagName: 'span', attribs: {} };
      }

      const safeAttributes = { href: attributes.href };
      if (typeof attributes.title === 'string') {
        safeAttributes.title = attributes.title;
      }

      return { tagName: 'a', attribs: safeAttributes };
    },
    th: (_tagName, attributes) => ({
      tagName: 'th',
      attribs: safeCellAttributes(attributes)
    }),
    td: (_tagName, attributes) => ({
      tagName: 'td',
      attribs: safeCellAttributes(attributes)
    })
  }
};

export function sanitizeKnowledgeHtml(input) {
  const dirtyHtml = typeof input === 'string' ? input : '';
  return sanitizeHtml(dirtyHtml, knowledgeHtmlPolicy);
}
在保存接口中,先验证调用者是否有权编辑目标知识库,再清理正文。权限判断不能放在浏览器里,也不能依赖请求中由客户端传来的角色字段。
app.post('/api/knowledge/:id', async (req, res) => {
  const article = await loadArticle(req.params.id);

  if (!article || !canEdit(req.user, article)) {
    return res.sendStatus(403);
  }

  const cleanHtml = sanitizeKnowledgeHtml(req.body.content);
  await saveArticleContent(article.id, cleanHtml);

  return res.sendStatus(204);
});
实际项目应按框架设置请求体大小限制,例如为正文接口配置合适的上限,并结合知识库内容类型和存储方式调整。若系统保存编辑器 JSON,应优先验证 JSON 的节点类型、属性和嵌套深度,再由受控渲染器生成 HTML;不要因为数据是 JSON 就默认其可信。若保存 HTML,则页面展示前也要使用当前策略重新清理,尤其要考虑策略升级后已有内容的处理。
假设剪贴板中包含以下内容:
<h2>维护说明</h2>
<p><strong>操作窗口</strong>:周三 20:00
<a href="alert(1)" onclick="alert(2)">查看步骤</a>
</p>
<img src="https://example.invalid/pixel.png" onerror="alert(3)">
经过示例白名单后,标题、段落和粗体保留;链接地址和事件属性被移除,图片不进入编辑区。链接文字仍作为普通文本显示。过滤关注的是内容结构和可执行属性,不负责判断链接指向的网站是否可信,编辑者仍需确认业务文档中链接的来源。
上线前可以用以下核对项确认处理链路:
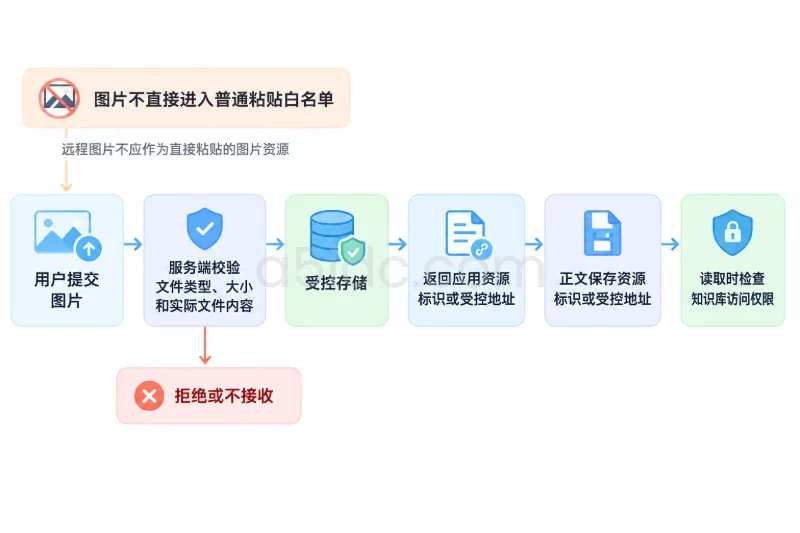
onclick 等事件属性不会进入编辑区或保存结果。style、class、图片、iframe 等不在白名单内的内容不会被保留。把图片标签列入粘贴白名单,不等于图片就安全。远程图片可能暴露访问者的网络请求信息,也可能因第三方资源失效而无法显示。需要图片时,应将粘贴图片转换为单独的上传流程:服务端校验文件类型、大小和实际文件内容,图片存入受控存储位置,返回应用自己的资源标识;知识库正文只保存该资源标识或受控地址。图片读取还应遵循知识库的访问权限,不能因文件地址可猜测而绕过正文权限。
同样,若业务需要颜色、字号或表格合并单元格等格式,应按编辑器能力定义有限规则,并在浏览器和服务端保持一致。例如字号只允许预设的几个级别,颜色只允许经产品确认的色值;表格跨度限制为小范围整数。任何新增属性都要同时评估浏览器解释方式、服务端过滤规则和历史内容兼容性。
这样处理后,编辑者可以从网页或办公文档粘贴常见结构化内容,知识库仍能保留阅读所需的格式;而不受信任的脚本、属性和嵌入内容不会因为“看起来只是粘贴”就直接进入存储和展示链路。
知识库富文本链路中的内容清洗、保存与图片资源管理,需要后台服务和相应存储资源作为基础。A5idc数据提供香港、美国、日本等地区的物理服务器,涵盖常规建站、AMD计算及存储型方案,可按业务负载和数据规模配置处理器、内存及SSD、NVMe或大容量机械存储,为知识库应用、接口服务和内容文件存放提供基础设施选择;多地区资源也便于结合业务部署区域安排服务。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9900.html