香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


抢占式实例可能在任务完成前被回收,因此恢复能力不能只依赖实例本地文件或进程退出时的清理逻辑。可行的做法是把处理进度、必要的运行状态和已提交结果保存到实例之外的持久存储,并在恢复时从最近一次有效检查点继续;检查点之间尚未保存的工作仍可能重做。
设计时要同时确定四件事:哪些状态必须保存、多久保存一次、检查点与业务结果如何保持一致,以及保留多久、怎样验证能够恢复。若任务可以拆成独立且可重复处理的小单元,通常用“已完成单元的位置 + 幂等输出”恢复较简单;若任务依赖长时间累积的内存状态,则还要保存状态本身,或设计可重放的输入日志。
检查点不是任务输出的简单副本,而是让程序能够从一个明确位置继续执行的一组状态。它至少要回答:处理到哪里、使用的是哪一版输入、恢复时需要哪些参数,以及检查点对应的结果是否已经可靠写入。
适合放入检查点的内容取决于任务类型:
如果任务只记录“已处理到第 1000 条”,却没有绑定输入版本,输入文件发生变化后从第 1001 条继续,可能把两版数据混在一起。检查点应包含可校验的输入标识,例如对象版本号、文件摘要或数据集快照标识;恢复时不匹配就应停止并要求选择正确输入,而不是默默续跑。
检查点也不一定需要复制所有数据。可以将大型输入和输出保存在持久存储中,检查点只保存定位信息和状态摘要。关键是被引用的数据在检查点保留期间不能先于检查点过期。
典型的数据路径可以拆成五个环节:
最重要的顺序是“结果先可靠提交,进度后推进”。如果先把进度写到第 101 条,再写第 100 条的业务结果,实例恰好在两步之间退出,恢复时会跳过未完成的结果。反过来,如果业务结果已提交、检查点还没更新,恢复后可能再次处理第 100 条。因此,除非结果与进度在同一事务中提交,否则通常应按至少一次处理来设计:允许重做,但通过幂等写入让重做不会重复计费、重复发通知或生成重复记录。
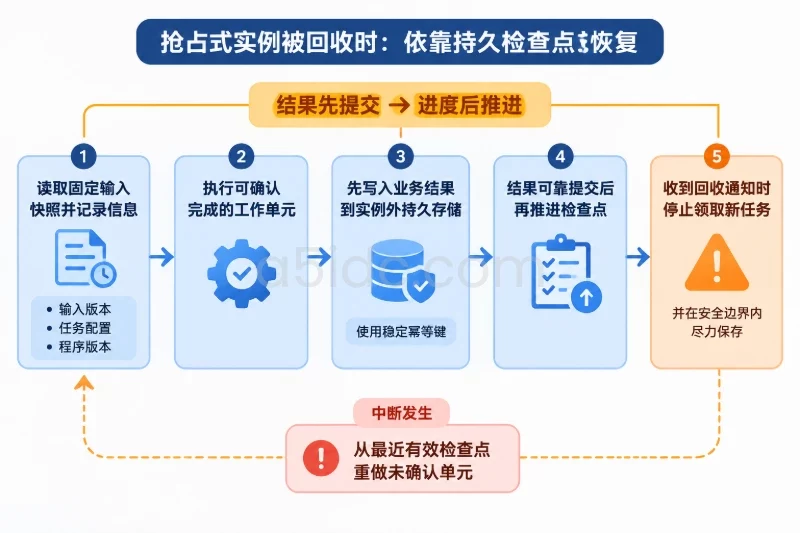
对于数据库结果,可以在同一数据库事务中同时写业务数据与消费位置;对于跨数据库、对象存储或外部接口的流程,往往无法获得单一原子事务,应使用幂等键、去重表、事务性发件箱或可重放日志,明确处理重复提交窗口。若外部接口不支持幂等,也没有查询或补偿方式,就不能仅凭一个检查点保证副作用恰好执行一次。
保存越频繁,单次中断后需要重做的工作通常越少,但检查点本身会占用计算、网络和存储资源。可先用业务允许的重做时间确定一个候选间隔,再根据实测的检查点耗时和回收频率调整。
例如,某任务每 10 分钟保存一次,单次保存约 8 秒。若中断大致均匀发生在两个检查点之间,平均需要重做的计算时间约为间隔的一半,即约 5 分钟;最坏情况下接近 10 分钟。仅从保存耗时看,8 秒相对 10 分钟约为 1.3%,但这还没有计入状态序列化、上传、校验和存储请求的额外负担。
在故障近似随机、检查点开销稳定的简化模型中,可用下面的估算辅助起步:
这只是简化估算,不是通用最佳值。抢占概率可能随实例类型、区域、时段和容量变化;检查点耗时也可能随状态大小增长。实际配置应结合任务允许的最大重做时间、检查点失败率、存储成本及中断记录验证。以下场景可采用不同策略:
| 任务特征 | 检查点策略 | 需要关注的边界 |
|---|---|---|
| 单个单元耗时短、可幂等重做 | 每批或每若干单元保存 | 避免每条记录都触发昂贵的远程写入 |
| 单个单元耗时长 | 按时间周期保存,并在安全阶段保存 | 单元内部状态若不可恢复,仍可能损失整个单元 |
| 状态体积大、序列化慢 | 保存增量或阶段性快照 | 增量必须能与正确的基线配套恢复 |
| 中断损失代价高 | 缩短间隔,或拆分任务降低单次工作量 | 频繁保存不能弥补不一致或不可恢复的格式 |
可以记录“检查点生成耗时、上传耗时、大小、最近成功时间、恢复后重做时长”。如果保存耗时持续逼近设定间隔,或任务经常从较早位置重做,应先排查状态是否过大、存储链路是否拥塞,再决定是否缩短间隔。
检查点需要有明确的一致性边界。对独立任务,边界可以是单个工作单元提交完成;对多个分片并行处理的任务,则需要保存每个分片的位置,并确保这些位置对应一组可恢复的结果状态。不能只保存一个看似最新的全局偏移量,却遗漏某个较慢分片尚未提交的数据。
分布式训练或多节点计算通常还需要同步点:所有参与节点在同一轮次或同一训练步达到一致状态后,才生成可恢复快照。若只保存部分节点参数,恢复时将这些参数拼接起来,可能得到内部不一致的状态。保存时应有代次或快照 ID,清楚标明参数、优化器状态和训练位置属于同一代。
并发恢复也要防止两个实例同时消费同一任务。常见做法是使用租约、条件写入或具备 fencing token 的任务所有权机制:新实例取得更高代次后,旧实例即使延迟恢复,也不能覆盖新实例写入的状态。只有时间戳而没有所有权校验,可能发生旧检查点覆盖新检查点的竞态。
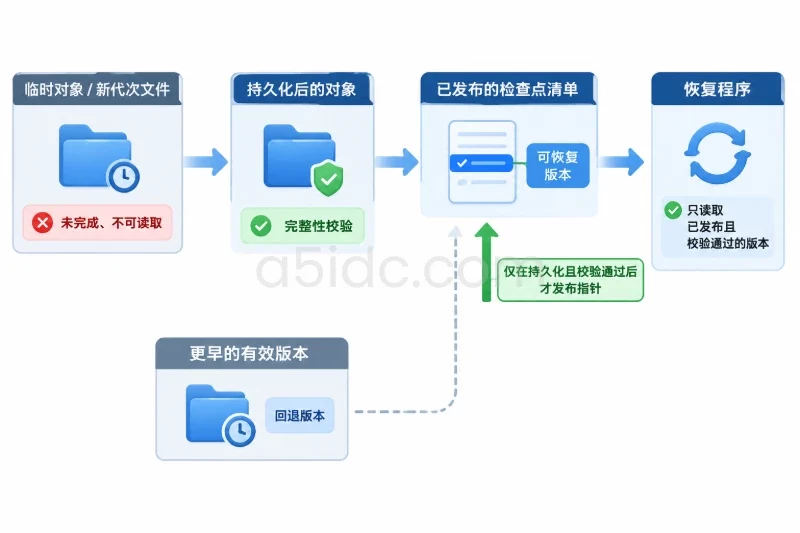
对检查点文件,应先写入临时对象或新代次文件,完成持久化和完整性校验后,再发布一个指向该代次的清单或当前版本指针。恢复程序只读取已发布且校验通过的版本,不读取仍在上传的临时文件。保留至少一个较早的有效版本,可以避免最新版本损坏后无路可退。
下面的示例假设检查点目录位于实例回收后仍可访问的持久卷上,而不是实例临时盘。commit_output 代表业务结果的持久化接口,应使用 task_id 和记录标识实现幂等;如果改用对象存储,需按对应存储服务的语义实现“上传新版本、校验、最后发布清单”,不能直接假定本地文件操作可用于对象存储。
import json
import os
import signal
import tempfile
from pathlib import Path

CHECKPOINT = Path("/mnt/durable/task/checkpoint.json")
TASK_ID = "daily-import-v3"
INPUT_VERSION = "dataset-2025-03-08"
SAVE_EVERY = 500

stop_requested = False


def request_stop(signum, frame):
    # 信号处理函数只记录请求,不在这里执行耗时写入。
    global stop_requested
    stop_requested = True


signal.signal(signal.SIGTERM, request_stop)
signal.signal(signal.SIGINT, request_stop)


def load_checkpoint():
    if not CHECKPOINT.exists():
        return {"next_index": 0, "input_version": INPUT_VERSION}

    state = json.loads(CHECKPOINT.read_text(encoding="utf-8"))
    if state.get("input_version") != INPUT_VERSION:
        raise RuntimeError("检查点对应的输入版本不匹配,停止续跑")
    return state


def save_checkpoint(next_index):
    CHECKPOINT.parent.mkdir(parents=True, exist_ok=True)
    state = {
        "task_id": TASK_ID,
        "input_version": INPUT_VERSION,
        "next_index": next_index,
    }

    fd, temp_name = tempfile.mkstemp(
        prefix="checkpoint.",
        suffix=".tmp",
        dir=CHECKPOINT.parent,
    )
    try:
        with os.fdopen(fd, "w", encoding="utf-8") as f:
            json.dump(state, f, ensure_ascii=False)
            f.flush()
            os.fsync(f.fileno())

        os.replace(temp_name, CHECKPOINT)

        # 尽可能确保目录项更新也落盘;具体持久化保证仍取决于文件系统。
        dir_fd = os.open(CHECKPOINT.parent, os.O_RDONLY)
        try:
            os.fsync(dir_fd)
        finally:
            os.close(dir_fd)
    finally:
        if os.path.exists(temp_name):
            os.unlink(temp_name)


def commit_output(idempotency_key, result):
    """
    替换为实际的持久化逻辑。
    同一个 idempotency_key 重试时应覆盖同一结果或被安全去重。
    """
    raise NotImplementedError


def process_record(record):
    # 替换为实际业务处理。
    return {"value": record}


def run(records):
    state = load_checkpoint()
    next_index = state["next_index"]

    for index in range(next_index, len(records)):
        record = records[index]
        result = process_record(record)

        # 先提交结果,再推进检查点;提交接口需支持幂等重试。
        key = f"{TASK_ID}:{INPUT_VERSION}:{index}"
        commit_output(key, result)
        next_index = index + 1

        if next_index % SAVE_EVERY == 0:
            save_checkpoint(next_index)

        if stop_requested:
            # 只在当前单元已提交后保存;若硬中断发生在提交期间,
            # 重启时可能重做该单元,因此幂等键不可省略。
            save_checkpoint(next_index)
            return

    save_checkpoint(next_index)
代码中的原子替换只解决同一文件系统上的部分写入问题,不代表检查点已经可靠复制到其他故障域。若持久卷本身可能随实例一起释放,或任务需要跨实例、跨节点恢复,应把检查点放到独立的持久存储,并验证上传成功后再更新可见的检查点清单。还应保存格式版本和必要的代码、依赖或参数版本;格式升级后,恢复程序应明确兼容、迁移或拒绝旧格式。
检查点恢复链路需要计算资源承载任务,也需要合适的存储空间留存状态文件与中间数据。A5idc数据提供香港、美国、日本等地区的物理服务器,涵盖Xeon、AMD EPYC等平台,并有NVMe及大容量硬盘配置,可为批处理任务部署、检查点保存和数据留存提供相应的计算与存储资源。
实例平台可能提供回收通知或终止信号,但通知提前量和可用性取决于具体平台及实例类型。即使收到通知,也可能只剩很短时间,或者进程在完成上传前被强制结束。因此通知适合用来触发一次“尽力保存”,不适合替代定期检查点。
回收通知到达后,程序可停止领取新任务,等待当前安全工作单元完成;在剩余时间允许时保存检查点并退出。若当前单元耗时不可控,应在业务逻辑中增加阶段性保存,或把任务切分成更小的单元。不要在信号处理函数里直接做网络上传、复杂序列化或获取锁,这些操作可能阻塞或在进程退出前无法完成。
恢复程序应区分几类结果:
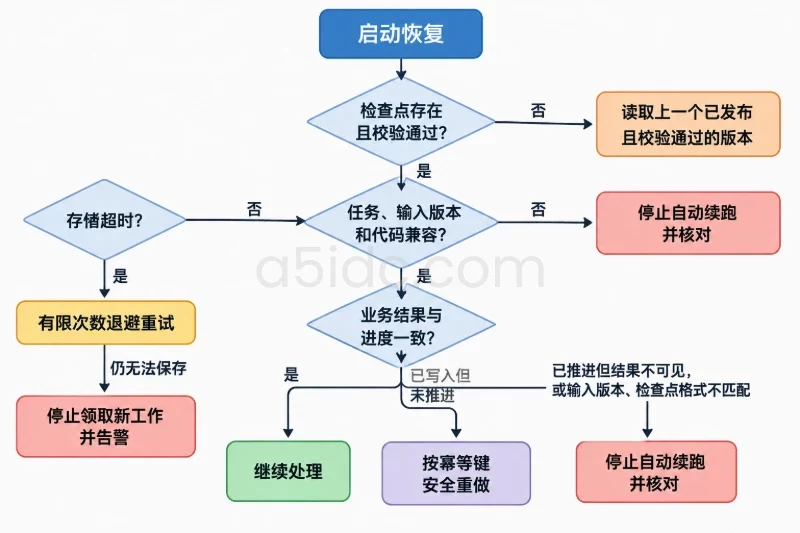
检查点保留时间至少应覆盖任务最长运行时间、预计的故障发现和处理时间,以及可能需要的人工核对窗口。保留太短,任务中断几天后可能找不到兼容状态;保留太长,则会增加存储成本,也可能积累不再需要的敏感数据。可以按检查点代次清理,但应先确认新版本可读、校验通过且恢复演练成功,再删除旧版本。若检查点引用输入快照或中间文件,这些依赖也必须至少保留到对应检查点过期。
检查点中可能包含业务数据、模型参数、访问令牌或内部路径。只保存恢复必需的信息;密钥应放在专用密钥管理设施中,而不是写入 JSON 检查点。存储访问权限按任务最小化授予,并评估传输与静态加密、审计记录和跨故障域备份要求。删除策略需要考虑版本化对象、快照和回收站机制,避免以为删除了清单就已清除所有副本。
恢复演练不能只验证“文件存在”。定期在隔离环境中选取一个保留中的检查点,执行以下核验:
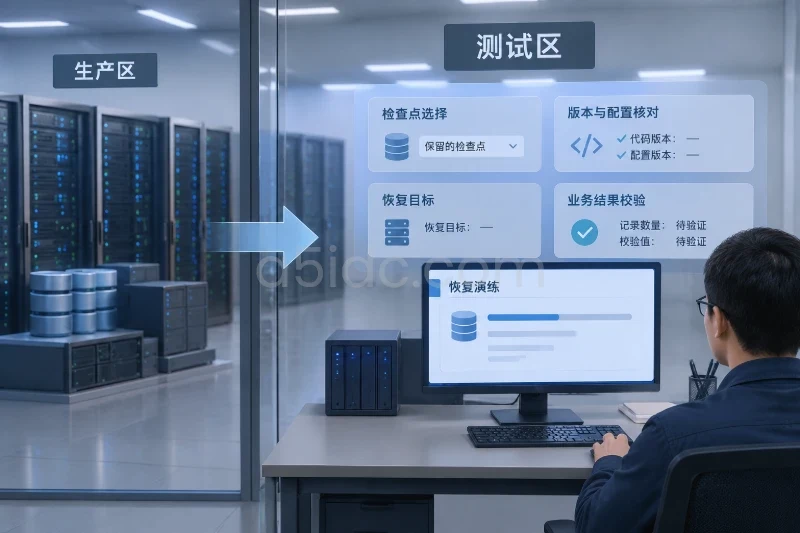
如果任务要求在中断后几分钟内恢复,应同时测量检查点读取、输入准备、实例启动和业务预热时间;检查点本身很小,并不意味着端到端恢复一定很快。下一步应先用一次受控中断验证“结果提交顺序、检查点读取、重复执行处理”这三项,再根据允许的重做时间和实际保存耗时确定检查点间隔与保留周期。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9879.html


