香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


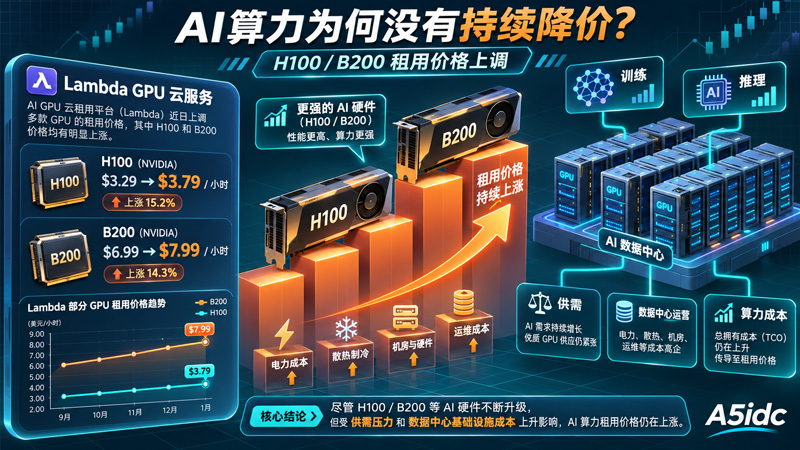
AI算力越来越强,租用价格却未必越来越便宜。11月16日,美国GPU云服务商Lambda正式执行新一轮按需实例价格调整,NVIDIA H100、B200等主力GPU的租用报价出现上涨。其中,单卡H100 PCIe每小时价格从3.29美元提高至3.79美元,B200则从6.99美元上涨至7.99美元。
这次调整值得关注的地方,不只是部分GPU实例涨价约14%至15%,而是它打破了一种看似合理的预期:随着新一代GPU不断推出、AI计算效率持续提高,算力租用成本应该逐渐下降。
实际市场显然没有这么简单。GPU芯片性能提升,并不必然带来云服务租金下降。数据中心建设成本、供需关系、设备利用率,以及AI训练和推理需求的变化,都可能影响最终报价。
A5数据在分析此次Lambda调价时发现,更值得讨论的问题是:当AI硬件技术不断进步,为什么GPU租用价格仍有上涨空间?对企业而言,继续按小时租用GPU,还是转向长期租用、独立GPU服务器,成本判断又该如何变化?
根据Lambda官方价格页面公布的信息,新一轮按需GPU实例价格从11月16日08:00起生效,覆盖单卡及多卡实例的部分GPU规格。
此次调整并非当天突然发布的临时通知。Lambda此前已经在公开价格页面标注生效日期,11月16日是新价格正式执行的时间。
对照官网此前显示的同规格报价,三款具有代表性的单GPU实例价格变化如下:
GPU型号 | 原价格 | 新价格 | 涨幅 |
|---|---|---|---|
H100 PCIe 80GB | $3.29/小时 | $3.79/小时 | 15.2% |
H100 SXM 80GB | $4.29/小时 | $4.89/小时 | 14.0% |
B200 SXM6 180GB | $6.99/小时 | $7.99/小时 | 14.3% |
以上均为单GPU按需实例的公开小时报价,未包含可能适用的税费。实际费用还需结合实例运行时间、所选配置及具体服务条款计算。
从调整幅度看,Lambda对上述GPU实例的提价比较集中,单卡每小时增加0.50至1.00美元。
虽然单小时差价看起来不算特别大,但对于需要长期运行的AI业务,累计成本就会明显增加。
以单卡B200为例,如果按每月持续运行720小时计算,原价格对应的理论费用为5032.80美元,新价格则达到5752.80美元,单月增加720美元。
相同运行条件下,H100 SXM的单月理论费用增加432美元,H100 PCIe增加360美元。
如果将GPU数量扩大到多卡甚至集群级别,价格变化带来的预算压力还会进一步放大。不过,Lambda为不同GPU数量的实例提供了不同的单卡报价,不能简单将单卡价格直接乘以8作为八卡实例的实际费用。
例如,新价格下,八卡HGX B200实例的单GPU小时报价为7.69美元,八卡HGX H100为4.59美元,均低于相应单卡实例的单GPU价格。
值得注意的是,Lambda并没有将所有GPU型号统一上调。其价格页面显示,A100 40GB、A10及部分专业显卡实例仍维持原有公开价格。这说明本轮变化具有一定的产品针对性,不能据此认定整个GPU云计算市场都在同步涨价。
从技术进步的角度看,新一代GPU通常能够在特定AI任务中提供更高的计算吞吐量、更大的显存容量,以及更先进的数据传输能力。
以H100与B200为例,H100常见配置具有80GB显存,而B200提供180GB显存,并针对大规模AI计算进行了架构和性能优化。
按照直觉,新硬件的单位计算效率不断提高,云服务商似乎应该以更低的成本提供相同数量的计算任务。
但这里存在一个容易被忽略的问题:GPU计算效率提高,与GPU每小时租金下降,本来就不是同一个概念。
对云服务商而言,GPU服务器不是单独购买一张显卡就能对外出租的业务。
一套可用于AI训练和推理的GPU服务器,还需要CPU、系统内存、企业级SSD、高速网络、电源和散热系统。如果部署多GPU集群,还涉及节点间高速互联、网络交换设备、存储吞吐能力及集群调度系统。
特别是在高密度AI服务器环境中,GPU功耗和机柜散热要求明显高于许多传统服务器。建设和运行数据中心所需的供电设施、冷却系统以及配套网络,同样需要长期投入。
Lambda本身也在持续扩大AI基础设施规模。11月4日,该公司宣布计划在美国阿拉巴马州建设大型数据中心园区,项目预计投资约331亿美元,相关建设预计于2027年第一季度开始,并可能持续数年。
这项投资计划说明,AI算力服务商不仅在采购GPU,还在承担大规模数据中心基础设施建设。
不过,需要明确的是,Lambda目前公开的调价页面并未充分解释此次H100和B200涨价的具体原因,因此不能直接认定数据中心投资增加就是本轮调价的原因。
A5数据分析认为,GPU租用价格最终取决于计算能力、供应数量、用户需求和运营成本之间的关系。即使新一代GPU计算效率更高,只要市场对高性能算力的需求依然旺盛,服务商就未必需要通过持续降价来吸引客户。
谈到GPU算力需求,很多人首先想到的是大模型训练。
训练大型AI模型通常需要大量GPU同时运行,对显存容量、计算性能和节点间网络带宽都有较高要求。但随着AI模型逐渐进入实际应用,推理业务也开始成为GPU算力的重要需求来源。
相比阶段性开展的模型训练,面向用户提供服务的AI推理系统往往需要长期保持运行。
例如,企业部署在线AI客服、代码生成、文档分析或多模态应用时,需要根据用户请求量配置持续可用的推理资源。如果业务规模扩大,还可能增加GPU实例数量,以维持响应速度和服务稳定性。
这意味着GPU的使用场景正在发生变化。
训练任务通常以完成某个模型版本为目标,而在线推理更接近持续运营的基础设施。模型投入生产后,每天有多少请求、峰值并发是多少、平均响应延迟能否满足要求,都会影响GPU资源需求。
当然,这并不意味着所有AI推理业务都必须使用H100或B200。
一些经过量化、优化的模型可以在显存容量较小的GPU上运行。对于负载不高的业务,合理配置推理服务、采用批处理或选择适合的GPU型号,可能比直接租用最新高端GPU更经济。
我们认为,这也是理解GPU租用市场的关键:高端GPU的价格受到大型模型训练和高性能推理需求影响,但不同业务对算力的需求差异很大,市场不会因为某一类产品涨价就让所有AI应用的成本同步上升。
另外,AI推理需求增长只是可能影响高端GPU供需关系的行业因素之一。现阶段没有足够证据证明Lambda此次涨价主要由推理业务增长直接驱动。
对于真正使用GPU服务器的企业来说,还有一个比每小时报价更重要的指标:完成实际计算任务需要多少成本。
假设两种GPU实例分别用于运行相同的AI模型,第一种每小时收费4美元,第二种每小时收费8美元。
单看价格,第二种明显更贵。
但如果第二种GPU在相同质量和服务要求下,每小时能够处理第一种三倍的有效请求量,那么它分摊到每次请求上的GPU计算费用反而可能更低。
反过来,如果实际业务规模较小,GPU大部分时间处于空闲状态,即使选择性能更强的设备,也无法充分利用其计算能力,实际单位任务成本可能更高。
因此,不能简单根据H100和B200的租用价格高低判断哪个更划算。
实际比较时,至少需要考虑三个因素。
首先是模型是否能够正常运行,包括模型参数规模、显存占用和上下文长度要求。如果模型需要的显存超过GPU能够提供的容量,即使小时价格很低,也可能无法满足部署需求。
其次是实际吞吐量和响应速度。同样的模型在不同GPU上运行,性能差异会受到量化精度、推理框架、批处理大小以及软件优化程度影响,不能直接根据GPU理论算力计算成本。
最后是资源利用率。GPU长期保持高负载运行与每天只使用几个小时,其合适的租用方式可能完全不同。
A5数据建议,企业比较GPU服务器时,应尽量通过实际模型测试得到每秒生成Token数量、请求延迟、并发能力和GPU利用率,再结合小时租金评估成本。
真正需要降低的是单位有效计算任务的成本,而不只是GPU每小时的标价。
此次Lambda调价,对偶尔使用GPU的开发者和需要持续运行算力的企业,影响并不相同。
对于模型测试、短期微调、科研实验等业务,按小时租用仍具有明显优势。用户无需承担昂贵的GPU硬件采购费用,也不必自行维护机房供电、散热和硬件故障。
如果使用时间不稳定,能够及时释放不再需要的计算实例,按需模式可以减少闲置资源带来的成本。
但对于7×24小时运行的AI推理、模型服务和企业内部AI平台,情况就有所不同。
长期连续运行的业务,在比较成本时不能只看单小时报价,还需要计算月度总费用,以及长期合同能否提供更稳定的价格和资源保障。
此外,独立GPU服务器租赁也值得纳入比较范围。
与按小时计费的共享云资源相比,独立GPU服务器通常按月或按合同周期提供固定配置,适合资源使用率较高、希望持续控制运行环境的业务。不过,其实际成本优势取决于GPU型号、硬件配置、带宽、服务等级及租赁合同,并非所有独立服务器都比云GPU更便宜。
企业还需要考虑算力交付形式带来的差异。
GPU云实例通常便于快速创建、扩容和释放资源,但可用GPU型号及数量可能受到平台库存和区域限制。独立GPU服务器则有利于长期固定部署,并能根据具体服务方案提供相对稳定的硬件环境,但扩容灵活性和交付周期需要事先确认。
如果选择自行采购GPU服务器,还需承担硬件折旧、电力、机柜空间、网络、维护及设备更新成本。对于缺少专业运维能力的团队,这些费用和管理负担同样不能忽略。
在A5数据看来,Lambda此次调价实际上提醒企业重新审视算力采购策略:当GPU使用需求趋于稳定时,持续使用按小时计费的实例是否仍然合算,值得通过真实账单重新计算。
尤其是已经运行数月、资源利用率较高的AI业务,更应定期比较不同部署方案的总体成本,而不是默认最初采用的云服务模式始终最经济。
Lambda并不是近期唯一公布GPU云服务价格调整的厂商。
另一家AI云服务商Crusoe也已在官方价格页面列出计划于12月1日执行的新报价。其中,H100 HGX实例从每GPU小时3.90美元上调至4.50美元,H200 HGX从4.29美元提高至5.40美元。
需要注意,Crusoe的新价格尚未生效,而且两家服务商的配置、服务能力及计费条件存在差异,不能简单将它们视为完全相同的GPU租赁产品。
不过,两家厂商接连公布部分高性能GPU的涨价安排,至少说明高端AI算力租用价格并不总是沿着持续下降的方向变化。
从产业规律看,硬件租用市场始终存在两股相互作用的力量。
一方面,GPU架构升级、软件优化和规模化部署有机会降低单位计算成本。随着旧型号设备逐步折旧,其价格也可能面临下降压力。
另一方面,新增AI需求、先进GPU及配套系统的采购成本、数据中心电力和建设条件,又可能对特定型号的租用价格形成支撑。
最终价格取决于不同因素在具体时间和市场中的作用,而不是GPU发布了新一代产品,旧一代租金就一定下降。
从本轮Lambda价格表也可以看到,A100等部分型号并未同步调整。这种差异说明,不同GPU的市场定位和定价策略并不完全一致。
因此,现阶段更准确的判断是:部分高性能GPU云实例出现明确涨价,但还不足以认定全球GPU算力市场已经全面进入价格上涨周期。
Lambda此次上调H100与B200租用价格,表面上是一次云服务价格调整,背后却反映了AI基础设施市场越来越复杂的成本结构。
高性能GPU并不缺少技术进步,但需求增长、数据中心投资和算力服务模式的变化,使得硬件性能提升不一定立即转化为租赁价格下降。
对于GPU云服务商而言,能否持续提供稳定的高性能算力、提高设备利用率,并控制供电、散热、网络和运维成本,将影响其长期竞争能力。
对于使用AI算力的企业,判断标准也需要随之改变。
GPU租用价格当然重要,但更关键的是能否以合理的总体成本完成实际业务。相同预算下,选择适合的GPU型号、提高资源利用率、优化模型推理效率,以及合理搭配按需和长期租用资源,可能比单纯寻找最低小时报价更有价值。
未来GPU硬件还会继续升级,算力供应也会不断扩大,但这并不意味着每一种GPU的租赁价格都会持续下跌。
当AI应用逐渐从技术实验走向长期运营,企业真正需要关注的,已经不只是GPU每小时多少钱,而是每投入一美元算力费用,究竟能够完成多少有效计算工作。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9840.html