香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


恢复联网后,离线队列中的请求可能被发送不止一次:客户端发出请求后超时,无法判断服务端是否已经处理;应用重启也可能重新读取尚未确认完成的任务。因此,不能只靠“联网后发送一次”来保证不重复。常见做法是让客户端对同一业务操作始终使用同一个幂等键,并由服务端在处理业务写入时原子地记录该键和处理结果。
客户端队列负责可靠保存、重试和展示状态,服务端幂等负责避免重复产生业务效果。两者缺一不可:客户端无法仅凭超时判断请求有没有成功,服务端也无法替客户端恢复未持久化的操作。设计时还要区分“同一操作的重复投递”和“用户确实又做了一次相同操作”,因为两者的请求内容可能完全相同。
例如,用户离线提交一笔订单后,应用发出请求但没有收到响应。服务端可能已创建订单,也可能没有收到请求。客户端若换一个新请求标识再试,服务端就可能创建第二笔订单;若始终沿用原标识,服务端则可以返回第一次处理的结果,而不再执行一次创建。
幂等键应表示一次明确的业务意图,而不是请求内容的指纹:
因此,键通常在用户确认提交、客户端创建待办操作时生成。不要在每次网络重试时生成,也不要简单地用请求体哈希代替:两次合法的相同提交可能具有相同请求体,却代表两次独立操作。
一条可靠的离线提交路径可以分为四段:创建本地操作、持久化队列项、发送请求、确认处理结果。每一段都要能恢复原来的操作身份。
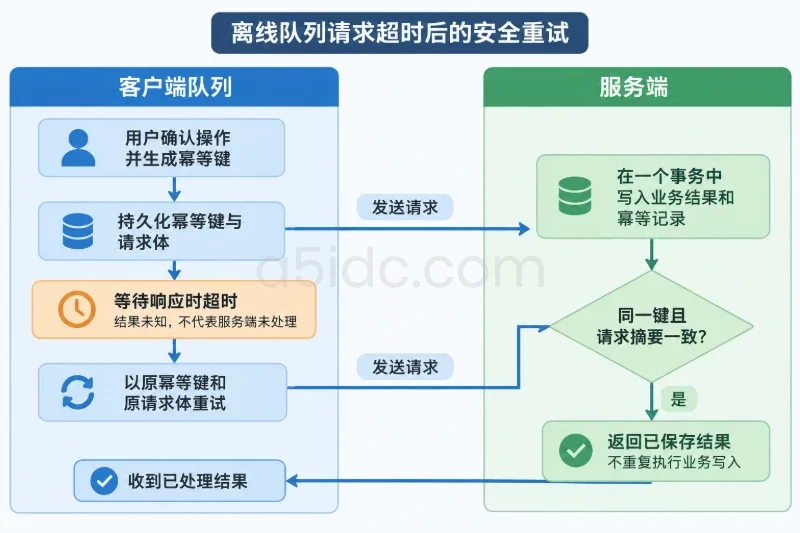
用户点击提交后,客户端应立即为这次业务操作生成幂等键,并把键、请求体和必要的业务上下文写入本地持久化存储,例如 SQLite。写入成功后,界面可显示“待同步”或“提交中”。这不等于服务端已经受理,更不应提前显示为最终完成。
建议队列项至少包含:
| 字段 | 用途 |
|---|---|
operation_id | 客户端内部标识,便于查找和更新本地记录 |
idempotency_key | 同一业务操作所有重试共用的键 |
payload | 本次提交的固定请求内容 |
aggregate_id | 关联的订单、文档或其他业务对象 |
sequence | 同一对象下的本地操作顺序 |
status | 待发送、发送中、等待重试、成功或需人工处理 |
attempts、next_attempt_at | 控制重试次数和时间 |
created_at | 排序、排查和清理时使用 |
队列项应以事务方式保存。不要只放在内存中,也不要等网络恢复后才写入:应用若在那之前被系统回收,用户已经确认的操作可能丢失。敏感请求内容是否加密存储,应根据数据类型、设备风险和应用已有的安全方案决定;清理队列时也要避免把尚未确认的操作误删。
请求体在第一次可能发送之后应视为不可变。否则会出现同一个幂等键对应不同请求内容的情况,服务端无法判断客户端是在重试,还是错误地复用了键。若业务需要修改已提交内容,应创建新的业务命令,或调用具有明确更新语义的接口。
系统报告网络已连接,不代表目标服务可访问,也不代表 DNS、认证或业务接口正常。反过来,网络状态监听偶尔延迟,也不应成为队列恢复的唯一条件。可以把连通性变化当作“尝试唤醒同步器”的信号,并在应用启动、页面恢复或定时调度时再次检查待处理任务;真正的可用性仍由 HTTP 请求结果判断。
同步器应避免同一进程中重复启动多个消费者。跨进程或多设备场景则不能只依靠客户端互斥锁,因为客户端锁只约束本地运行实例,不能替代服务端幂等。队列读取和“标记为发送中”最好在同一个本地事务中完成,并给发送中的记录设置租约或超时,应用崩溃后过期记录才可以重新进入待发送状态。
下面的 Dart 代码展示核心控制流,QueueRepository 的读写需要由本地数据库实现;关键在于重试时不变更 idempotencyKey 和 payload。
enum QueueStatus {
  pending,
  sending,
  retryWaiting,
  succeeded,
  needsReview,
}

class QueueItem {
  const QueueItem({
    required this.id,
    required this.idempotencyKey,
    required this.payload,
    required this.attempts,
  });

  final String id;
  final String idempotencyKey;
  final Map<String, Object?> payload;
  final int attempts;
}

abstract interface class QueueRepository {
  /// 在本地事务内领取一个可发送项目,并设置发送租约。
  Future<QueueItem?> claimNext(DateTime now);

  Future<void> markSucceeded(String id, Object? response);

  Future<void> scheduleRetry(
    String id, {
    required int attempts,
    required DateTime nextAttemptAt,
    required String reason,
  });

  Future<void> markNeedsReview(String id, String reason);
}

abstract interface class SubmitApi {
  Future<Object?> submit(
    Map<String, Object?> payload, {
    required String idempotencyKey,
  });
}

class SyncWorker {
  SyncWorker(this.repository, this.api);

  final QueueRepository repository;
  final SubmitApi api;
  bool _running = false;

  Future<void> run() async {
    if (_running) return;
    _running = true;

    try {
      while (true) {
        final item = await repository.claimNext(DateTime.now());
        if (item == null) break;

        try {
          final response = await api.submit(
            item.payload,
            idempotencyKey: item.idempotencyKey,
          );
          await repository.markSucceeded(item.id, response);
        } on RetryableSubmitException catch (error) {
          final attempts = item.attempts + 1;
          await repository.scheduleRetry(
            item.id,
            attempts: attempts,
            nextAttemptAt: DateTime.now().add(_retryDelay(attempts)),
            reason: error.message,
          );
        } on PermanentSubmitException catch (error) {
          await repository.markNeedsReview(item.id, error.message);
        }
      }
    } finally {
      _running = false;
    }
  }

  Duration _retryDelay(int attempts) {
    final exponent = attempts.clamp(0, 8);
    final baseSeconds = 2 * (1 << exponent);
    final cappedSeconds = baseSeconds.clamp(2, 300);
    // 实际项目可再加入少量随机抖动,避免大量设备同时重试。
    return Duration(seconds: cappedSeconds);
  }
}

class RetryableSubmitException implements Exception {
  RetryableSubmitException(this.message);
  final String message;
}

class PermanentSubmitException implements Exception {
  PermanentSubmitException(this.message);
  final String message;
}
示例中的异常类型由 API 层按实际响应分类。网络超时通常属于“结果未知”,应按可重试处理,并使用原幂等键;不能因为客户端没拿到响应就认定服务端没有执行。claimNext 还需考虑租约恢复、到期重试时间和同一业务对象的顺序,不能仅凭示例代码中的循环假定数据库已经提供这些保证。
离线队列的重试与去重需要服务端接口和业务数据有相应的计算、存储资源承载。A5idc数据提供香港、美国、日本等地区的物理服务器,涵盖Xeon Gold、AMD EPYC等处理器平台及SSD、NVMe存储,并提供不同线路方案,可用于部署业务后台、接口服务和数据库,为幂等记录保存与请求处理提供硬件和网络资源基础。
如果服务端先执行创建订单,之后才单独写入幂等记录,中间发生进程崩溃,重试时仍可能再次创建。反过来,先标记幂等键已处理,再执行订单写入,也可能留下“记录显示成功、业务数据却没写入”的不一致。
对同一数据库中的业务写入,通常应在一个事务中完成以下工作:
幂等键通常需要按租户、账号或 API 调用主体划分作用域,避免不同用户偶然使用相同键时互相影响。服务端表可以有类似的约束:
CREATE TABLE idempotency_records (
  principal_id   TEXT NOT NULL,
  idempotency_key TEXT NOT NULL,
  request_hash   TEXT NOT NULL,
  status         TEXT NOT NULL,
  response_body  JSONB,
  created_at     TIMESTAMPTZ NOT NULL DEFAULT now(),
  PRIMARY KEY (principal_id, idempotency_key)
);
并发请求可能同时带着同一个键到达。唯一约束负责阻止重复登记,但处理冲突的代码仍需正确等待或读取最终记录,并确保不会让两个请求都执行实际业务写入。若同一键对应不同请求摘要,应返回明确的冲突错误,而不是把新请求误认为第一次操作的重试。服务端还应定义幂等记录的保留时间;保留期至少要覆盖客户端可能离线、重试和恢复的业务窗口。若旧记录已清理,过期客户端再次发送旧操作仍可能造成重复,因此清理策略应与业务风险相匹配。
若业务写入还会触发邮件、支付、库存服务或其他外部系统,单个数据库事务无法原子覆盖这些系统。可在事务中写入待发送的 outbox 事件,再由后台任务投递;消费端也要有自己的去重标识。仅仅在 HTTP 接口加幂等键,并不能自动让所有后续副作用也变成幂等。
不能把所有失败都当作“稍后再试”。错误分类决定队列是继续等待、停止重试,还是提示用户处理。
| 结果 | 常见处理方式 | 关键判断 |
|---|---|---|
| 连接失败、超时、连接中断 | 延迟后重试,沿用原键 | 服务端可能已处理,属于结果未知 |
| 服务端限流或临时不可用 | 按服务端建议或退避策略重试 | 可结合 Retry-After,避免密集重试 |
| 参数校验失败、业务规则拒绝 | 停止自动重试,展示可理解的原因 | 同一请求不变时重试通常不会变好 |
| 认证失效 | 先处理重新认证,再决定是否重试 | 避免用失效凭据无限循环 |
| 幂等键与请求体不匹配 | 标记异常并调查客户端逻辑 | 不要自动换新键掩盖身份错误 |
| 版本冲突或资源已变化 | 拉取当前状态,按业务规则合并或请求用户选择 | 直接重放可能覆盖他人更新 |
退避时间可以逐步增加,例如第 1 次等待约 2 秒、第 2 次约 4 秒,随后继续增长并设上限;加入少量随机抖动可降低大量设备同时恢复联网时的请求峰值。达到某个重试上限后,不宜简单删除操作。可以转为“需要处理”状态,保留错误信息和原始操作标识,供用户重试、编辑或取消。重试上限与保留期限应结合业务时效设置,而不是所有队列共用一个固定值。
幂等只解决“同一操作被重复处理”,不自动保证多条不同操作的先后关系。如果同一份文档先离线改标题,再离线删除,两个请求乱序到达可能产生意外结果。可按业务对象维护序号,只允许该对象较早的未完成操作发送;不同对象之间则可并行,以减少无关等待。
服务端可要求客户端携带对象版本号或 ETag,并在更新时校验版本。若本地基于版本 8 修改,而服务端已到版本 9,应返回冲突,由业务决定合并、覆盖、重新编辑或放弃。对于计数、支付、库存变更等操作,优先使用语义明确的命令接口,例如“增加数量”或“扣减指定数量”,不要把过期的整份对象快照直接覆盖到服务端。
队列也可能包含可合并的操作,但合并条件必须由业务语义定义。例如尚未发送的同一草稿可以只保留最终编辑结果;已经发出但结果未知的提交不能随意与后续编辑合并,因为服务端可能已经处理了旧版本。需要合并时,应创建新的队列状态或新操作,并保留可追踪的关联关系。
客户端可以乐观显示用户刚输入的内容,但要把本地状态和服务端状态区分开。比如列表可显示“待同步”,收到服务端成功响应并将结果可靠写回本地后,再显示“已提交”。若应用在服务端成功后、写入本地成功状态前崩溃,重启后仍会重发;服务端应通过原键返回第一次的结果,客户端再据此补记成功。
本地标记成功和保存响应也应尽量使用数据库事务。队列记录清理则可延后到成功状态稳定写入之后,并保留足够的诊断信息。对于需要用户确认的失败,不要把错误只写入日志后从界面消失;应让用户知道操作仍待处理,并提供适当的恢复路径。
调试时可记录 operation_id、幂等键的安全摘要、尝试次数、队列状态变化、服务端请求标识和响应类别。不要把认证令牌、完整支付信息或其他敏感请求内容写入普通日志。客户端与服务端分别记录同一操作的关联信息,才能分辨“客户端重发但服务端去重”“请求未到服务端”和“服务端处理成功但客户端未收到响应”等情况。
重点测试的不只是正常联网提交,还包括这些状态切换:
判断实现是否可靠,核心不是恢复联网后请求发得多快,而是每个业务操作是否有稳定身份、队列能否在崩溃后恢复、服务端能否原子去重,以及结果未知时能否安全重试。先用故障注入验证“服务端已成功、客户端未确认”这一窗口,再检查并发、顺序和冲突处理,通常比单纯观察网络恢复后的发送速度更能发现重复请求问题。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9825.html