香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


命令行程序要把执行结果交给脚本或其他服务处理时,关键不只是把数据转成 JSON,还要让输出结构稳定:成功结果和失败结果有明确区分,标准输出只包含一份 JSON,诊断信息则写入标准错误。下面用 Rust 实现一个简单的问候命令,支持 --json、名称和重复次数,并将成功或运行错误序列化后输出。
实现中使用 serde 定义可序列化的数据结构,使用 serde_json 写出 JSON。命令行参数由 clap 解析;当用户请求 JSON 时,参数错误和业务校验错误也返回统一格式,进程仍通过退出码标识成功或失败。
先创建项目:
cargo new greet-json
cd greet-json
在 Cargo.toml 中添加依赖:
[dependencies]
clap = { version = "4", features = ["derive"] }
serde = { version = "1", features = ["derive"] }
serde_json = "1"
输出格式先确定,再写业务逻辑。成功时返回 ok 和 data;失败时返回 ok 和 error。这样调用方可以先检查 ok,再读取对应的数据,而不用根据一段可读文本猜测执行状态。
成功结果示例:
{
  "ok": true,
  "data": {
    "messages": ["你好,A5IDC!", "你好,A5IDC!"],
    "count": 2
  }
}
失败结果示例:
{
  "ok": false,
  "error": {
    "code": "INVALID_REPEAT",
    "message": "--repeat 必须在 1 到 100 之间"
  }
}
code 适合供脚本判断,message 用来说明问题。后续即使调整提示文字,调用方仍可依赖稳定的错误码。避免把内部调试信息、敏感路径或密钥直接放进错误消息。
将以下代码放入 src/main.rs:
use clap::{error::ErrorKind, Parser};
use serde::Serialize;
use std::{
    io::{self, Write},
    process::ExitCode,
};

#[derive(Parser)]
#[command(name = "greet-json", version, about = "输出问候信息")]
struct Args {
    /// 以 JSON 格式输出
    #[arg(long)]
    json: bool,

    /// 接收问候的名称
    #[arg(long, default_value = "Rust")]
    name: String,

    /// 输出次数,范围为 1 到 100
    #[arg(long, default_value_t = 1)]
    repeat: u32,
}

#[derive(Serialize)]
struct Success {
    ok: bool,
     SuccessData,
}

#[derive(Serialize)]
struct SuccessData {
    messages: Vec<String>,
    count: usize,
}

#[derive(Serialize)]
struct Failure {
    ok: bool,
    error: ErrorBody,
}

#[derive(Serialize)]
struct ErrorBody {
    code: &'static str,
    message: String,
}

fn write_json<T: Serialize>(value: &T) -> io::Result<()> {
    let stdout = io::stdout();
    let mut output = stdout.lock();

    serde_json::to_writer(&mut output, value)
        .map_err(|err| io::Error::new(io::ErrorKind::Other, err))?;

    output.write_all(b"\n")
}

fn report_failure(
    json: bool,
    code: &'static str,
    message: String,
    status: ExitCode,
) -> ExitCode {
    if json {
        let response = Failure {
            ok: false,
            error: ErrorBody { code, message },
        };

        if let Err(err) = write_json(&response) {
            eprintln!("写入 JSON 错误结果失败:{err}");
            return ExitCode::FAILURE;
        }
    } else {
        eprintln!("{code}: {message}");
    }

    status
}

fn main() -> ExitCode {
    let raw_args: Vec<String> = std::env::args().collect();
    let json_requested = raw_args.iter().any(|arg| arg == "--json");

    let args = match Args::try_parse_from(raw_args) {
        Ok(args) => args,
        Err(err) => {
            let status = ExitCode::from(u8::try_from(err.exit_code()).unwrap_or(1));

            // 帮助和版本信息沿用 clap 的常规输出,不包装成运行结果。
            if matches!(
                err.kind(),
                ErrorKind::DisplayHelp | ErrorKind::DisplayVersion
            ) {
                let _ = err.print();
                return status;
            }

            // 指定了 --json 时,将命令行解析错误也包装成 JSON。
            if json_requested {
                return report_failure(
                    true,
                    "ARGUMENT_ERROR",
                    err.to_string(),
                    status,
                );
            }

            let _ = err.print();
            return status;
        }
    };

    if args.name.trim().is_empty() {
        return report_failure(
            args.json,
            "INVALID_NAME",
            "--name 不能为空".to_string(),
            ExitCode::from(2),
        );
    }

    if !(1..=100).contains(&args.repeat) {
        return report_failure(
            args.json,
            "INVALID_REPEAT",
            "--repeat 必须在 1 到 100 之间".to_string(),
            ExitCode::from(2),
        );
    }

    let name = args.name.trim();
    let messages: Vec<String> = (0..args.repeat)
        .map(|_| format!("你好,{name}!"))
        .collect();

    let response = Success {
        ok: true,
         SuccessData {
            count: messages.len(),
            messages,
        },
    };

    if args.json {
        if let Err(err) = write_json(&response) {
            eprintln!("写入 JSON 结果失败:{err}");
            return ExitCode::FAILURE;
        }
    } else {
        let stdout = io::stdout();
        let mut output = stdout.lock();

        for message in &response.data.messages {
            if let Err(err) = writeln!(output, "{message}") {
                eprintln!("写入问候信息失败:{err}");
                return ExitCode::FAILURE;
            }
        }
    }

    ExitCode::SUCCESS
}
这里的 Success、SuccessData、Failure 和 ErrorBody 都派生了 Serialize。serde_json::to_writer 根据这些类型生成 JSON,不需要手动拼接花括号、引号或逗号。名称中即使包含引号、反斜杠等特殊字符,序列化库也会负责正确转义。
write_json 直接将结果写入标准输出,并在末尾追加换行。JSON 仍然是一个完整文档;末尾的换行方便终端阅读,也便于将多次程序输出逐行保存。成功结果和 JSON 模式下的错误结果都经过同一个函数输出,因此不会因分支不同而出现两套编码方式。
不指定 --json 时,程序面向终端输出普通文本:
cargo run -- --name "A5IDC" --repeat 2
结果为:
你好,A5IDC!
你好,A5IDC!
指定 --json 后,程序输出一份 JSON:
cargo run --quiet -- --json --name "A5IDC" --repeat 2
结果为:
{"ok":true,"data":{"messages":["你好,A5IDC!","你好,A5IDC!"],"count":2}}
可以把结果交给 jq 检查或提取字段:
cargo run --quiet -- --json --name "A5IDC" --repeat 2 | jq '.data.count'
该命令会读取 JSON 中的 data.count,输出 2。如果后续脚本需要判断执行是否成功,可检查 .ok;需要处理问候内容,则读取 .data.messages。
--quiet 是传给 Cargo 的参数,-- 后面的参数才会交给 Rust 程序。直接运行已经构建好的可执行文件时,不需要 Cargo 分隔符,例如:
./target/debug/greet-json --json --name "A5IDC" --repeat 2
输入合法但不符合业务要求时,程序调用 report_failure。例如重复次数超出范围:
cargo run --quiet -- --json --repeat 0
标准输出为:
{"ok":false,"error":{"code":"INVALID_REPEAT","message":"--repeat 必须在 1 到 100 之间"}}
这类错误的退出码是 2,成功时是 0。因此,调用方既可以解析 JSON 里的 ok 和 error.code,也可以检查进程退出状态。退出码不应替代 JSON 中的错误信息:退出码适合做粗粒度成功或失败判断,错误码则能区分具体问题。
参数格式错误也会按同一思路处理:
cargo run --quiet -- --json --repeat abc
由于命令行解析阶段还没有得到完整的 Args,代码提前从原始参数中判断是否出现 --json。如果出现,便把 clap 的解析错误包装成 ARGUMENT_ERROR。该错误的 message 可能包含解析器生成的用法提示,因此不要把它当作稳定接口;自动化程序应依赖 error.code,而不是匹配完整提示文字。
帮助和版本请求则保留 clap 的常规行为,例如 --help 会显示帮助文本,不会被包装成一次失败的 JSON 执行结果。这样可以区分“程序在处理任务时返回的数据”和“命令行工具自身的帮助信息”。
如果程序会被管道、调度脚本或其他服务调用,标准输出应只放机器需要读取的结果。不要在输出 JSON 前后使用 println! 写入“开始执行”“处理完成”等日志;只要标准输出里混入普通文字,严格的 JSON 解析器就可能无法读取整个结果。
日志和诊断信息应写到标准错误。示例中,JSON 模式的业务错误本身写入标准输出,而 JSON 写入失败等程序级诊断使用 eprintln!。这样调用方可以分别处理结果和日志:
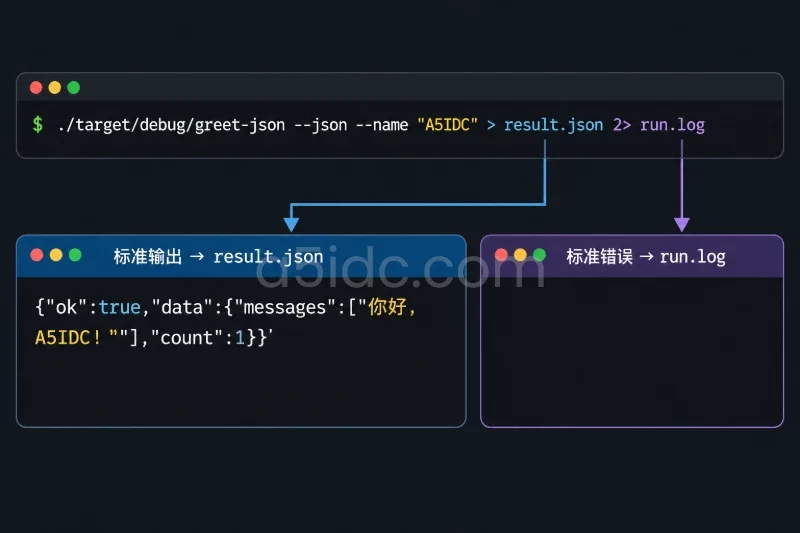
./target/debug/greet-json --json --name "A5IDC" > result.json 2> run.log
result.json 保存 JSON,run.log 保存标准错误信息。需要同时关注两者时,也可以让脚本读取进程退出码。需要注意的是,若标准输出被重定向到已关闭的管道,写入仍可能失败;代码会将这类情况报告到标准错误并以失败状态退出。
如果命令要返回更多业务信息,可以将字段加到 SuccessData,例如运行耗时、处理条数或结果摘要。字段应有明确含义和固定类型;时间、数量等值尽量使用数值或标准化字符串,不要有时输出数字、有时输出带单位的文本。
可选字段也应提前考虑调用方的处理方式。Option<T> 默认可能序列化为 null,如果希望字段缺省时完全不出现在 JSON 中,可以使用 Serde 属性:
#[derive(Serialize)]
struct SuccessData {
    messages: Vec<String>,

    #[serde(skip_serializing_if = "Option::is_none")]
    detail: Option<String>,
}
这两种形式对调用方而言并不相同:"detail": null 表示字段存在但没有值;完全省略字段则表示该字段不适用于当前结果。选定一种语义后,尽量保持一致。
实现 JSON 输出时,建议先定好成功和错误的数据结构,再让业务逻辑生成这些结构,最后统一交给 serde_json 序列化。这样终端输出、脚本调用和错误处理都有清楚的边界;业务结果变化时,也能通过调整类型定义明确管理输出格式。
A5idc数据提供香港、美国、日本等地区的物理服务器租用,覆盖Xeon与AMD平台,并有SSD、NVMe等存储配置及不同线路方案,可为Rust命令行程序的部署运行提供计算与存储资源。对于批处理、数据转换和后台任务,程序输出的结构化JSON可衔接脚本与业务服务;多地区资源也能适配不同区域的业务部署需求。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9797.html