香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


要验证知识库检索的前 K 条结果召回率,先为一组固定问题标注“哪些文档或知识片段能够回答它”,再让检索功能按相关度返回排序列表,计算每个问题的相关内容有多少出现在前 K 条中。这里验证的是检索是否找到了已知相关内容,不是答案生成是否准确。
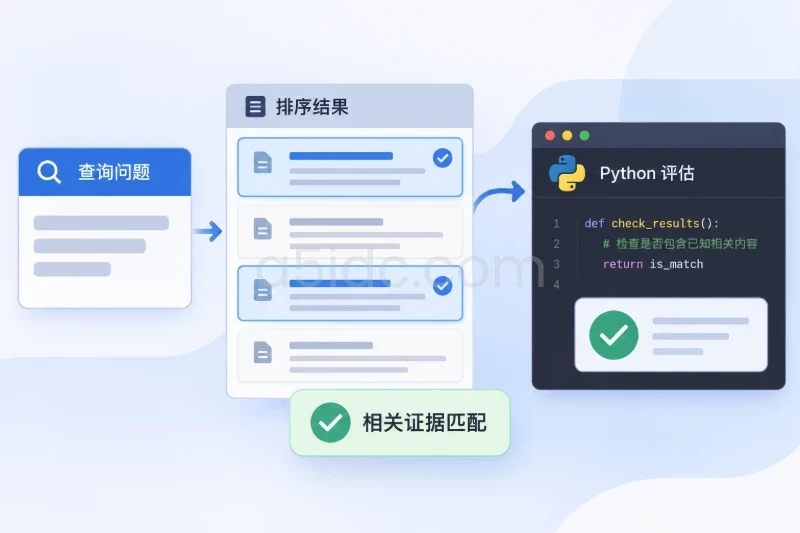
关键是让标注对象与检索结果处于同一层级:如果检索接口返回的是知识片段 ID,答案集也应记录相关片段 ID;如果接口返回文档 ID,答案集就按文档 ID 标注。只有参考答案文字、没有对应的文档或片段标识时,无法直接计算检索召回率,需要先把答案关联到知识库中的证据内容。
对一个问题,设已知相关内容集合为 G,检索结果按相关度排序,前 K 条为 R@K。单条查询的召回率为:
Recall@K = |G ∩ R@K| / |G|
例如,问题对应 3 个相关片段,前 5 条结果中找到了其中 2 个,那么 Recall@5 = 2 / 3 ≈ 0.667。如果相关片段只有 1 个,前 K 条中找到了它,则该问题的召回率为 1;没有找到则为 0。
一组问题通常还需要整体指标。常见做法有两种:
| 指标 | 计算方式 | 适用场景 |
|---|---|---|
| 宏平均召回率 | 先计算每个问题的 Recall@K,再对问题取平均 | 每个问题同等重要,避免相关片段较多的问题主导结果 |
| 微平均召回率 | 汇总所有问题命中的相关片段数,再除以相关片段总数 | 关注整个测试集的相关内容覆盖量 |
建议同时查看两者。它们衡量角度不同,结果不一定相同。例如,答案集中的问题有的对应 1 个片段,有的对应 10 个片段,微平均会让后者产生更大影响。
还要注意,Recall@K 本身不衡量结果是否精简,也不检查生成答案是否忠于检索内容。若要评估这些方面,需要另外关注精确率、排序质量或答案正确性,不能用一个召回率数字代替。
答案集的每条记录至少包含问题、唯一 ID 和相关内容 ID。可以用 JSONL 保存,每行一个 JSON 对象:
{"query_id":"q-001","query":"退款申请需要提交哪些材料?","relevant_doc_ids":["refund-policy#materials","refund-policy#application"]}
{"query_id":"q-002","query":"如何修改账户绑定的邮箱?","relevant_doc_ids":["account-guide#change-email"]}
{"query_id":"q-003","query":"服务暂停后如何恢复?","relevant_doc_ids":["service-status#resume","billing-guide#overdue"]}
上面的片段 ID 是示例。实际使用时,应换成检索接口能够返回的稳定 ID。若知识库会把一篇文档切分成多个片段,最好标注片段 ID,而不是只标父文档 ID;否则检索返回了同一文档中不包含答案的片段,也可能被误算为命中。
建集时需要核对几件事:
relevant_doc_ids。如果有多个同义问题但对应相同证据,可以分别保留,便于观察不同问法下的检索表现。评估器不需要绑定某一种向量数据库或搜索框架。只要检索函数满足简单约定——输入问题和结果条数上限,按相关度返回文档或片段 ID——就可以复用同一份计算逻辑。
下面的脚本包含 JSONL 加载、重复结果去重、单条查询指标以及宏平均和微平均计算。K 按唯一结果计数,因此检索结果最好本身就避免重复 ID。
from __future__ import annotations

import json
from dataclasses import dataclass
from pathlib import Path
from typing import Callable, Iterable


@dataclass(frozen=True)
class QueryCase:
    query_id: str
    query: str
    relevant_doc_ids: frozenset[str]


def load_cases(path: str | Path) -> list[QueryCase]:
    """读取一行一条记录的 JSONL 答案集。"""
    cases: list[QueryCase] = []

    with open(path, "r", encoding="utf-8") as file:
        for line_no, line in enumerate(file, start=1):
            if not line.strip():
                continue

            try:
                item = json.loads(line)
            except json.JSONDecodeError as exc:
                raise ValueError(
                    f"第 {line_no} 行不是有效 JSON:{exc}"
                ) from exc

            query_id = item.get("query_id")
            query = item.get("query")
            relevant_ids = item.get("relevant_doc_ids")

            if not isinstance(query_id, str) or not query_id:
                raise ValueError(f"第 {line_no} 行缺少有效 query_id")
            if not isinstance(query, str) or not query.strip():
                raise ValueError(f"第 {line_no} 行缺少有效 query")
            if not isinstance(relevant_ids, list):
                raise ValueError(
                    f"第 {line_no} 行的 relevant_doc_ids 必须是列表"
                )
            if any(not isinstance(doc_id, str) or not doc_id
                   for doc_id in relevant_ids):
                raise ValueError(
                    f"第 {line_no} 行包含无效的相关内容 ID"
                )

            cases.append(
                QueryCase(
                    query_id=query_id,
                    query=query,
                    relevant_doc_ids=frozenset(relevant_ids),
                )
            )

    return cases


def unique_in_rank_order(
    doc_ids: Iterable[str],
    limit: int,
) -> list[str]:
    """去重并保留首次出现顺序,最多返回 limit 个 ID。"""
    result: list[str] = []
    seen: set[str] = set()

    for doc_id in doc_ids:
        if not isinstance(doc_id, str) or not doc_id:
            raise ValueError("检索结果中包含无效的内容 ID")

        if doc_id not in seen:
            result.append(doc_id)
            seen.add(doc_id)

        if len(result) >= limit:
            break

    return result


def evaluate_recall(
    cases: list[QueryCase],
    retrieve: Callable[[str, int], Iterable[str]],
    ks: Iterable[int] = (1, 3, 5, 10),
) -> dict:
    """使用同一份排序结果计算多个 K 值的召回率。"""
    k_values = sorted(set(ks))
    if not k_values or any(k <= 0 for k in k_values):
        raise ValueError("K 必须是一个或多个正整数")

    query_ids = [case.query_id for case in cases]
    if len(query_ids) != len(set(query_ids)):
        raise ValueError("答案集中 query_id 必须唯一")

    max_k = max(k_values)
    evaluated: list[dict] = []
    skipped_no_relevant = 0

    for case in cases:
        if not case.relevant_doc_ids:
            skipped_no_relevant += 1
            continue

        ranked_ids = unique_in_rank_order(
            retrieve(case.query, max_k),
            max_k,
        )

        hits_by_k: dict[int, int] = {}
        recall_by_k: dict[int, float] = {}

        for k in k_values:
            hits = len(
                case.relevant_doc_ids.intersection(ranked_ids[:k])
            )
            hits_by_k[k] = hits
            recall_by_k[k] = hits / len(case.relevant_doc_ids)

        evaluated.append(
            {
                "query_id": case.query_id,
                "relevant_count": len(case.relevant_doc_ids),
                "hits": hits_by_k,
                "recall": recall_by_k,
            }
        )

    if not evaluated:
        raise ValueError("没有可计算召回率的查询,请检查答案集")

    total_relevant = sum(
        row["relevant_count"] for row in evaluated
    )

    metrics: dict[int, dict[str, float]] = {}
    for k in k_values:
        macro = sum(
            row["recall"][k] for row in evaluated
        ) / len(evaluated)

        total_hits = sum(row["hits"][k] for row in evaluated)
        micro = total_hits / total_relevant

        metrics[k] = {
            "macro": macro,
            "micro": micro,
        }

    return {
        "evaluated_queries": len(evaluated),
        "skipped_no_relevant": skipped_no_relevant,
        "metrics": metrics,
        "per_query": evaluated,
    }
其中 retrieve 是与现有知识库检索功能的连接点。把它适配成“问题 + 条数上限 → 排序后的 ID 列表”即可,不需要改动评估公式。例如,现有系统返回的是包含 id 字段的结果对象,可以在适配函数中提取 ID:
def retrieve(query: str, limit: int) -> list[str]:
    # search_service 代表项目中的现有检索服务。
    # 按项目实际接口替换下面这一行。
    results = search_service.search(query=query, top_k=limit)
    return [result.id for result in results]
这里的 search_service.search 是接口示意,不是对某个特定库的固定调用要求。适配时应确认返回列表已经按检索分数从高到低排序,并且筛选条件、租户范围、权限限制与预期使用场景一致。评估器只看到返回的 ID,不会替检索服务判断这些结果是否有权限展示。
在接入真实检索服务前,可以先用固定排序结果验证公式和代码。以下数据是演示用例,不代表任何线上检索表现:
cases = [
    QueryCase(
        query_id="q1",
        query="问题一",
        relevant_doc_ids=frozenset({"doc-a", "doc-b"}),
    ),
    QueryCase(
        query_id="q2",
        query="问题二",
        relevant_doc_ids=frozenset({"doc-c"}),
    ),
    QueryCase(
        query_id="q3",
        query="问题三",
        relevant_doc_ids=frozenset({"doc-d", "doc-e", "doc-f"}),
    ),
]

demo_rankings = {
    "问题一": ["doc-x", "doc-b", "doc-a"],
    "问题二": ["doc-c", "doc-x"],
    "问题三": ["doc-e", "doc-x", "doc-f"],
}


def demo_retrieve(query: str, limit: int) -> list[str]:
    return demo_rankings.get(query, [])[:limit]


result = evaluate_recall(cases, demo_retrieve, ks=(1, 2, 3))

for k, values in result["metrics"].items():
    print(
        f"Recall@{k}: "
        f"macro={values['macro']:.3f}, "
        f"micro={values['micro']:.3f}"
    )
输出为:
Recall@1: macro=0.444, micro=0.333
Recall@2: macro=0.611, micro=0.500
Recall@3: macro=0.889, micro=0.833
以 q1 为例,答案集有 doc-a 和 doc-b 两个相关片段。前 1 条是 doc-x,所以 Recall@1 为 0;前 2 条包含 doc-b,所以 Recall@2 为 1 / 2;前 3 条包含两个相关片段,Recall@3 为 1。其他问题按同一规则计算,宏平均对三个问题等权,微平均则按相关片段总数汇总。
真实运行时,将示例中的 demo_retrieve 替换为检索适配函数,并把答案集保存为 JSONL 文件:
cases = load_cases("recall_cases.jsonl")
result = evaluate_recall(cases, retrieve, ks=(1, 3, 5, 10))

print(
    f"纳入计算的问题数:{result['evaluated_queries']}"
)
print(
    f"无相关内容、未计算的问题数:"
    f"{result['skipped_no_relevant']}"
)

for k, values in result["metrics"].items():
    print(
        f"Recall@{k}: "
        f"macro={values['macro']:.4f}, "
        f"micro={values['micro']:.4f}"
    )
如果项目中已有测试框架,可以为示例结果增加断言,防止以后修改评估代码时意外改变指标定义:
assert round(result["metrics"][1]["macro"], 3) == 0.444
assert round(result["metrics"][1]["micro"], 3) == 0.333
assert round(result["metrics"][3]["macro"], 3) == 0.889
这类断言适用于固定演示数据。真实数据集的指标会随问题、知识库版本、索引和检索配置变化,不应把示例数字写成上线验收值。
K 应与实际下游使用方式对应。若问答流程最多只把 5 个片段交给生成模型,Recall@5 通常比 Recall@20 更接近实际可用范围;如果前 10 条会进入后续重排器,也可以同时看 Recall@10,判断召回阶段有没有把答案证据带进候选集。应在运行前确定要报告的 K,避免只挑表现较好的数字。
除了总体指标,还要检查逐条结果。查看 per_query 可以找出 Recall@K 为 0 的问题,确认原因是问题措辞、片段切分、内容缺失、过滤条件还是检索排序。此时不要只看平均值:平均召回率上升,仍可能伴随某一类问题表现变差。
若要比较两套配置,尽量固定答案集、知识库快照、查询过滤条件和评估代码,只改变要验证的检索配置。调参时可以使用开发集;留出一份不参与调参的测试集,最终再运行一次,避免反复根据同一批问题调整后把结果误认为独立验证。
最终报告至少保留答案集版本、知识库或索引版本、K 值、宏平均与微平均、可计算问题数和无相关内容问题数。这样得到的 Recall@K 才能复核,也更容易判断改动是否真正改善了知识库检索对已知答案证据的覆盖。
围绕知识库检索、问答接口和评估服务的部署,A5idc数据提供香港、美国、日本、韩国、中国台湾、新加坡及马来西亚等地区的物理服务器资源,覆盖Xeon Gold、AMD EPYC、NVMe存储及不同带宽线路,可为索引服务、数据库、接口程序和多任务处理提供相应的计算、存储与网络基础;面向AI检索或模型推理场景,也覆盖香港、美国GPU服务器资源。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9781.html