香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


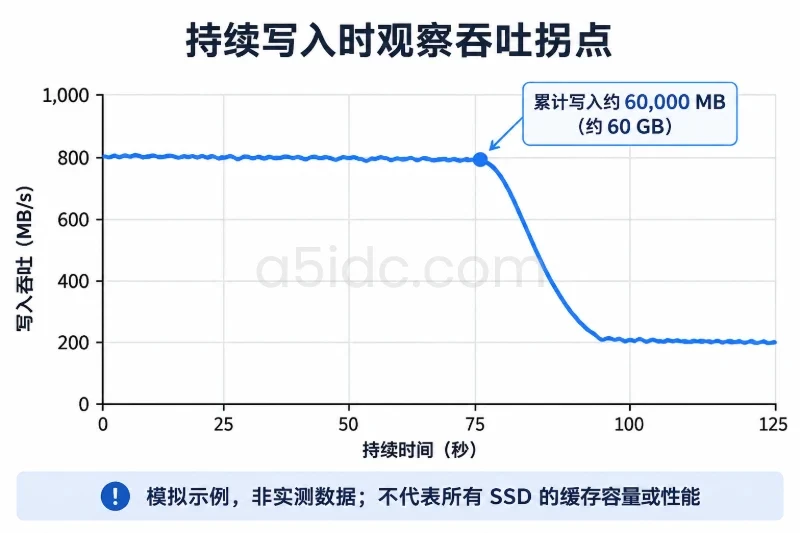
独立服务器持续写入降速,不能仅凭“开始很快、后来变慢”就认定是 SSD 缓存耗尽。更可靠的判断是:在业务写入请求量基本稳定的时间窗口内,设备写入吞吐先维持较高水平,随后明显下降;与此同时,w_await、I/O 队列和设备忙碌度同步上升,而 CPU、内存、网络、文件系统错误等替代因素没有先发生异常。满足这组关联特征时,才可以把“SSD 内部缓存或后台垃圾回收导致的持续写入降速”作为高概率原因。
如果只有应用层写入速度下降,但磁盘延迟和队列没有变化,问题可能在于写入源、业务锁、网络输入或应用自身限流。反过来,如果操作系统先把数据写入内存页缓存,初始速度也可能虚高,等脏页集中回写时才出现明显下降。因此,判断重点不是寻找一个固定的“缓存耗尽阈值”,而是把容量、inode、I/O 延迟、队列、文件系统、日志增长以及业务响应放在同一时间轴上观察。
服务器写入路径通常经过多个缓存层。不同层的容量、作用和可观测方式并不相同。
| 层次 | 主要作用 | 常见表现 | 能否直接等同于SSD缓存耗尽 |
|---|---|---|---|
| 操作系统页缓存 | 先在内存中接收普通写入,再异步回写存储设备 | 初始写入速度很高,脏页累积后出现回写压力 | 不能 |
| SSD控制器DRAM | 保存映射表或临时写入数据,降低部分访问延迟 | 小写入、同步写入的延迟可能短时间较低 | 不能单独判断 |
| NAND伪SLC缓存 | TLC或QLC介质先以类似SLC的方式接收数据 | 连续写入开始很快,超过缓存区域后吞吐明显下降 | 是常见候选原因 |
| RAID或存储控制器缓存 | 在阵列或控制器层合并、排序和暂存写入 | 多块盘同时受益,掉速可能伴随阵列队列升高 | 不一定是SSD本身 |
| 文件系统日志和写回队列 | 维护元数据一致性并安排实际写入 | 小文件、同步写入或大量元数据操作延迟升高 | 不能直接判断 |
消费级 TLC、QLC 固态硬盘经常使用动态伪SLC缓存。缓存可用容量可能随剩余空间、温度、固件策略和后台垃圾回收状态变化,并不存在适用于所有型号的统一容量。企业级 SSD 的持续写入曲线通常更稳定,但仍可能受到控制器缓存、热降速、写放大、介质磨损和容量使用率影响。
还需要区分“缓存耗尽”和“缓存回收速度跟不上”。SSD 在持续写入期间,控制器需要把临时区域中的数据整理回原生 NAND,同时执行垃圾回收和磨损均衡。此时即使业务没有继续提高写入量,设备内部工作量也可能增加,表现为吞吐降低、延迟上升和队列堆积。
故障出现时,不要只执行一次 df -h 或只看监控面板上的写入速度。至少应保留故障前、故障中和恢复后的数据。短时间采样可以使用 1 秒间隔,长期趋势则需要保留分钟级聚合结果。
以下命令以 Linux 服务器为例,主要用于读取状态,不会修改磁盘数据。/srv/data 需要替换成实际业务路径。
date '+%F %T'
findmnt -T /srv/data -o TARGET,SOURCE,FSTYPE,OPTIONS
lsblk -o NAME,TYPE,FSTYPE,SIZE,MODEL,MOUNTPOINTS
df -hT /srv/data
df -i /srv/data
先确认业务路径实际落在哪个设备上。路径可能位于普通分区、LVM 逻辑卷、软件 RAID、硬件 RAID 或多层映射设备中。如果只监控了某个 NVMe 分区,却没有观察承载它的阵列或逻辑卷,容易把设备层和业务层的现象对应错。
常用的实时观察组合如下:
iostat -xz 1
vmstat 1
pidstat -d 1
iostat、vmstat 和 pidstat 最好在同一故障窗口中运行,或由监控系统统一记录时间戳。不同版本的 sysstat 字段名称可能略有差异,常见字段包括:
| 指标 | 关注含义 | 需要结合什么观察 |
|---|---|---|
wMB/s、wkB/s | 设备写入吞吐 | 应用写入量、网络输入量 |
w/s | 每秒写请求数 | 写入块大小和业务操作类型 |
w_await | 写请求平均等待时间 | 队列长度、同步写入比例 |
aqu-sz 或 avgqu-sz | 平均设备队列深度 | 设备是否持续积压 |
%util | 设备处于忙碌状态的时间比例 | SSD并发能力和实际延迟 |
r/s、rkB/s | 读请求数量和读吞吐 | 是否存在读写竞争 |
%iowait | CPU等待I/O的时间占比 | CPU使用率和进程状态 |
Dirty、Writeback | 内存中等待写回或正在写回的数据 | 是否是操作系统页缓存造成的假象 |
对 SSD 来说,%util 接近 100% 不一定单独代表问题,因为高并发设备可能在忙碌状态下仍保持较高吞吐。更有参考价值的是吞吐下降时,w_await 和队列是否同步上升,以及应用提交的写请求是否仍然稳定。
df -hT 反映的是文件系统能够使用的逻辑空间,不等于 SSD 控制器当前可用于垃圾回收的全部物理空间。文件系统剩余空间较多时,SSD 仍可能因为写放大、预留空间较少或大量历史数据整理而出现延迟变化;但如果文件系统本身已经接近满载,控制器回收和文件系统分配压力通常会更加明显。
可以把容量趋势和写入延迟放在同一张图中观察,而不是只看一次使用率。业务环境通常应保留一部分可用空间用于日志、临时文件、文件系统元数据和后台整理。10%至20%可以作为某些场景的运维预留参考,但不能把它当成所有 SSD 的性能临界值。
容量异常常见的判断方式如下:
df -hT 使用率持续上升,并且日志或临时文件增长与写入降速同时发生,优先排查空间压力。df 显示空间已满,而 du 统计不出同等规模,可能存在已经删除但仍被进程打开的文件。检查可见文件和日志占用时,应先限定路径,避免对整个根文件系统执行高开销扫描:
du -xhd1 /var/log 2>/dev/null
journalctl --disk-usage
如果系统安装了 lsof,可以检查已删除但仍被进程持有的文件:
lsof +L1
该结果需要结合进程、文件描述符和日志服务判断。不要因为看到某个日志文件很大就直接删除或截断;活动日志可能仍被服务持有,错误处理可能造成日志丢失或服务行为异常。清理前应确认备份、轮转策略、服务影响范围和恢复方式。
inode 用于记录文件、目录和部分文件系统元数据。大量小文件可能让 inode 使用率接近 100%,但磁盘仍有很多 GB 空间。此时常见现象是无法创建新文件、日志轮转失败、应用报 No space left on device,而不一定表现为先快后慢的连续写入曲线。
df -i /srv/data
如果 inode 使用率很高,可以进一步定位目录数量和小文件增长来源,但不要在生产目录上直接进行大范围删除。对日志、缓存目录、队列目录和上传临时目录应分别确认其生命周期和清理策略。
同样的 SSD,在以下写入方式下可能出现完全不同的表现:
fsync 或 fdatasync;因此,不能拿厂商给出的顺序写吞吐,直接与数据库的同步随机写延迟比较。findmnt 可以帮助确认文件系统和挂载选项:
findmnt -T /srv/data -o TARGET,SOURCE,FSTYPE,OPTIONS
如果设备层吞吐下降时,文件系统元数据操作、同步写入或日志提交数量也在增加,优先判断实际工作负载是否发生变化,而不是马上认定内部缓存已耗尽。
持续写入降速时,最有价值的联动通常是“写吞吐、写延迟和队列”三者的方向是否一致。
例如,业务每秒提交的写入量没有下降,设备 wMB/s 却从 850 MB/s 降至 180 MB/s;同时 w_await 从 3 ms 上升至 50 ms,aqu-sz 从 2 上升至 10 以上,设备忙碌度接近 100%。这说明写请求没有消失,而是在设备内部排队,设备处理每个写请求所需的时间变长。
相反,如果业务写入请求量从每秒 10,000 次降至每秒 2,000 次,设备 wMB/s、w_await 和队列一起下降,那么磁盘本身可能没有变慢,只是写入源减少了。
下面是一组用于解释判断过程的模拟数据,不代表任何实际服务器监控结果:
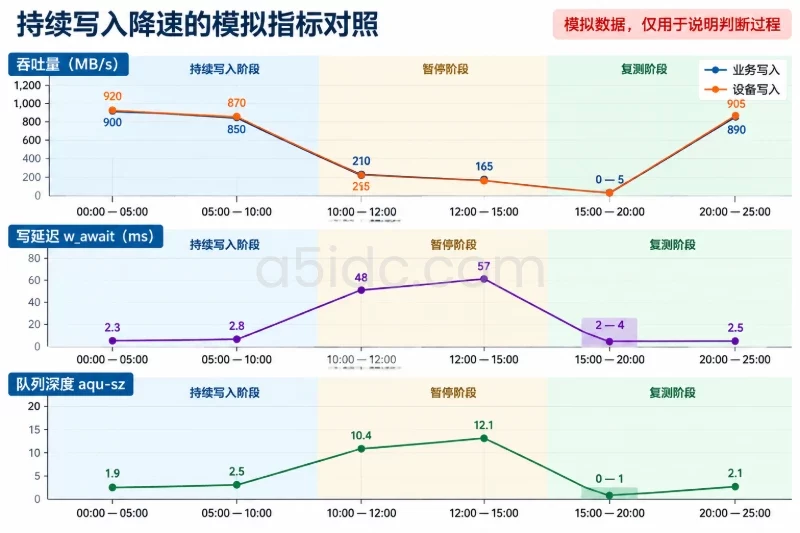
| 时间窗口 | 业务写入 | 设备写入 | w_await | aqu-sz | %util | 脏页与温度 |
|---|---|---|---|---|---|---|
| 00:00—05:00 | 900 MB/s | 920 MB/s | 2.3 ms | 1.9 | 97% | Dirty 0.4 GB,48℃ |
| 05:00—10:00 | 850 MB/s | 870 MB/s | 2.8 ms | 2.5 | 99% | Dirty 0.5 GB,51℃ |
| 10:00—12:00 | 210 MB/s | 205 MB/s | 48 ms | 10.4 | 100% | Dirty 0.3 GB,56℃ |
| 12:00—15:00 | 165 MB/s | 168 MB/s | 57 ms | 12.1 | 100% | Dirty 0.3 GB,57℃ |
| 15:00—20:00 | 0—5 MB/s | 0—5 MB/s | 2—4 ms | 0—1 | 3% | Dirty 0.1 GB,49℃ |
| 20:00—25:00复测 | 890 MB/s | 905 MB/s | 2.5 ms | 2.1 | 98% | Dirty 0.4 GB,51℃ |
这组数据中,业务写入在前 10 分钟保持稳定,之后设备吞吐和延迟发生反向变化;暂停写入一段时间后,复测又恢复到较高水平。若此时文件系统剩余空间、inode、网络输入和应用请求量没有同步异常,就可以把 SSD 伪SLC缓存回收、内部垃圾回收或控制器状态变化作为重点候选。
如果前 10 分钟的平均写入速度约为 850 MB/s,持续 600 秒,写入量约为:
850 MB/s × 600 s = 510000 MB ≈ 510 GB
这里的 GB 按十进制估算。若多次复测都在接近相同的累计写入量后出现下降,证据会比“运行了十分钟后变慢”更有价值。不过,动态缓存大小可能随温度、剩余空间和后台回收状态变化,所以累计数据量接近并不意味着缓存容量已经被精确测出。
普通写入可能先进入内存页缓存。此时应用看到的写入完成速度,反映的是内存接收速度,而不是 SSD 的真实持久化速度。当 Dirty 持续增加并触发集中回写时,应用才开始感受到设备实际吞吐。
可以在故障时间点观察:
grep -E '^(Dirty|Writeback|MemAvailable):' /proc/meminfo
如果降速前 Dirty 明显累积,降速时 Writeback 快速升高,而使用直接 I/O 的隔离测试无法复现同样曲线,问题更可能与操作系统写回策略有关。不要为了“证明磁盘性能”随意修改 vm.dirty_ratio、vm.dirty_bytes 或清空页缓存;这些动作会改变系统行为,且可能给业务带来额外延迟。
如果数据通过网络接收后写入服务器,应同时查看网络吞吐、请求量、消息队列长度和应用处理延迟。磁盘写入下降可能只是上游没有继续发送数据。
例如,应用显示网络输入为 1.2 Gbps,换算成十进制 MB/s 的步骤是:
1.2 Gbit/s ÷ 8 = 0.15 GByte/s
0.15 GByte/s × 1000 = 150 MB/s
因此,1.2 Gbps 的输入上限约为 150 MB/s,不能直接与 1.2 GB/s 的磁盘写入混用。单位中的小写 b 通常表示 bit,大写 B 表示 Byte。比较网络和磁盘时,应统一成 bit/s 或 Byte/s。
当网络接收速率、业务请求数和应用写入调用一起下降,同时磁盘队列接近空闲,应优先排查上游流量、业务限流、连接池、锁竞争或应用处理逻辑。
压缩、加密、校验、编码和数据合并任务可能先消耗 CPU,再导致写入量下降。此时常见特征是用户态 CPU 占用升高、运行队列增大,但磁盘 w_await 和设备队列没有明显增加。
如果 CPU 使用率并不高,但 %iowait 和设备队列升高,说明进程更可能在等待存储。%iowait 仍然只是 CPU 侧的等待指标,不能代替设备延迟,需要与 iostat 中的 w_await 和 aqu-sz 一起看。
SSD 控制器或 NAND 温度达到固件限制后,可能主动降低频率。热降速和缓存耗尽的曲线有时很相似,但二者的复现条件不同:
可以读取 NVMe 或 SATA 设备的健康信息,但设备路径和工具支持取决于实际硬件:
sudo smartctl -x /dev/nvme0
sudo nvme smart-log /dev/nvme0
执行前应根据 lsblk、nvme list 或硬件文档确认路径。重点观察温度、温度警告、可用备用空间、介质错误、关键警告和磨损程度。SMART 信息通常能支持“过热”或“介质异常”的判断,但不会总是直接报告“伪SLC缓存已经耗尽”。
如果内核日志出现 NVMe reset、I/O error、媒体错误、控制器掉线或文件系统错误,就不能继续把问题简单归类为缓存耗尽。此时应先保护数据,降低非必要写入,确认备份和硬件支持流程,再处理设备或阵列问题。
journalctl -k --since "30 min ago" --no-pager | \
  grep -Ei 'nvme|I/O error|blk_update|reset|timeout|xfs|ext4|raid|md'
软件 RAID 可以查看当前状态:
cat /proc/mdstat
如果日志中出现设备重置或阵列降级,长时间 fio 压测可能扩大风险,应先完成数据保护和故障定位。不要在没有备份、没有确认设备层级和没有回滚方案的情况下执行文件系统修复、阵列重建或原始块设备写入。
可以用下面的模式做初步归类,但每一项都应结合时间序列,而不是只看某个瞬时值。
| 观察到的组合 | 更可能的解释 | 下一步核对 |
|---|---|---|
业务写入稳定,设备吞吐下降,w_await和队列明显上升 | SSD内部回收、缓存耗尽、热降速或设备饱和 | 观察温度、SMART,并进行隔离盘持续写入复测 |
| 设备吞吐下降,但队列低、延迟稳定,网络和业务请求同步下降 | 写入源减少、上游限流或应用处理变慢 | 对比网络接收、请求量、业务处理延迟 |
Dirty持续增加,随后Writeback升高,直接I/O测试不复现 | 操作系统页缓存和写回造成的表面降速 | 检查内存压力、写回策略和应用写入方式 |
| 文件系统剩余空间快速下降,日志目录或临时目录同步增长 | 日志增长、临时文件或容量不足 | 定位增长目录,执行服务感知的轮转和清理 |
| inode接近100%,大量小文件创建失败 | inode耗尽或目录元数据压力 | 统计文件数量和增长来源 |
| 温度达到警告区间后吞吐随温度变化 | 热降速 | 检查风道、散热、机箱环境和设备规格 |
| 内核日志出现超时、重置、介质错误 | 设备、链路、固件或阵列异常 | 优先备份和硬件诊断,不进行长时间压测 |
要把判断提高到“高可信”,通常需要同时满足以下条件:
即使满足这些条件,也更适合表述为“高度疑似 SSD 内部缓存回收或持续写入性能下降”,而不是声称已经精确测出了缓存容量。要获得更确定的结论,还需要结合具体型号、容量版本、固件版本和厂商对持续写入性能的说明。
生产盘不适合直接用长时间写入测试证明缓存耗尽。测试文件会占用空间,持续写入会产生额外磨损、温度和业务争用;如果误把现有分区或原始设备作为目标,还可能覆盖有效数据。
复测前应确认:
/dev/nvme0n1、/dev/sda 等原始设备路径。在专用测试卷上,可以用 fio 构造大块顺序写入。下面的 32G 和 900s 只是示例参数,必须根据测试盘空间、设备规格和维护窗口调整:
sudo fio --name=seq-write-test \
  --filename=/mnt/ssd-test/fio-testfile \
  --size=32G \
  --rw=write \
  --bs=1M \
  --ioengine=libaio \
  --direct=1 \
  --iodepth=16 \
  --numjobs=1 \
  --runtime=900 \
  --time_based \
  --group_reporting
该命令会对指定测试文件产生实际写入,不能指向包含业务数据的文件,也不能指向原始块设备。--direct=1 用于减少操作系统页缓存对结果的影响,但不会绕过 SSD 控制器自身的缓存和内部回收机制。
测试过程中应同时运行:
iostat -xz 1
vmstat 1
并定时记录温度、设备健康信息、业务卷剩余空间和内核日志。重点不是只看 fio 最后输出的平均带宽,而是观察带宽曲线是否出现:
w_await 和队列同步增加;如果生产业务主要是 4 KiB 随机同步写入,1 MiB 顺序写入测试只能说明设备的一个性能维度,不能直接代表业务表现。此时应在另一轮隔离测试中匹配实际的块大小、随机比例、并发数、队列深度以及是否执行 fsync。不同测试结果必须分开记录,不能把顺序异步写和同步随机写混成一个平均值。
测试结束后,应保留测试日志和监控曲线,确认测试目录只包含测试文件,再按照既定变更流程清理。不要为了释放空间而对业务目录执行不加确认的批量删除、强制截断或原始设备操作。
如果证据指向 SSD 持续写入性能下降,可以从以下方向处理:
如果证据显示是操作系统页缓存、网络输入或应用处理瓶颈,则应在对应层面优化。缓存耗尽只是“持续写入先快后慢”的一种解释,排障目标不是为现象寻找一个容易记忆的标签,而是确认哪一层首先发生了可重复的变化。
A5idc数据提供香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器租用,覆盖SSD、NVMe及大容量存储方案,并配备不同CPU、内存和网络线路组合,可为数据库、业务后台、文件存储及持续写入型任务提供相应的硬件与部署资源。
下一次出现持续写入降速时,至少应在同一时间轴上记录:业务写入 MB/s、请求数量、p95/p99 响应时间、错误率、设备读写吞吐、w_await、I/O 队列、设备忙碌度、CPU 用户态与 %iowait、内存 Dirty 与 Writeback、文件系统空间、inode 使用率、日志目录增长、网络接收速率、SSD 温度、SMART 状态以及内核错误。
当“业务输入稳定、设备写入下降、写延迟和队列上升、替代因素未先异常、隔离复测可重复”这组指标同时出现时,才适合把 SSD 缓存回收或持续写入性能下降作为主要结论;如果其中任一环节方向不一致,就应回到对应层继续核对,而不是只根据单个速度数字下判断。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/9358.html