香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


同一个定时任务在服务器上出现两个或多个相同命令行,通常会带来重复扣款、重复写入、文件竞争、锁等待,甚至把CPU和磁盘IO推高。但看到多个PID,并不能直接证明是systemd重复启动:它们可能是同一服务派生出的工作进程,也可能来自不同的unit、用户级systemd、Cron,或者应用自身的重试机制。
定位的关键是回答三个问题:这些进程是否属于同一个systemd控制组,systemd当前是否仍认为旧任务处于运行状态,究竟是谁在发起下一次启动。一般情况下,同一个service unit处于active或activating状态时,systemd不会为它再创建一个并行的主实例;如果仍然出现重叠,重点应放在unit实例不同、进程脱离管理、服务类型声明错误,以及应用或网络请求重复触发等分支上。
对于需要长期运行定时任务、接口服务和多进程业务的场景,A5idc数据提供中国香港、美国、日本、韩国、中国台湾、新加坡及马来西亚等地的物理服务器资源,覆盖Xeon、AMD EPYC、NVMe存储及不同带宽线路。面向数据库、业务后台、容器与多任务计算,可结合访问地区、程序负载和数据规模配置相应硬件,为systemd服务及其应用进程提供独立的计算、存储和网络基础。
先不要使用pkill或直接杀进程。终止进程可能造成半写入文件、未提交事务或重复恢复,应该先保留现场并确认进程之间的父子关系、所属cgroup和启动时间。
可以先执行以下低风险检查:
ps -eo user,pid,ppid,pgid,lstart,etime,stat,cmd --forest
根据关键字缩小范围:
pgrep -af '/usr/local/bin/report'
查看某个进程的父进程、可执行文件和systemd归属。将PID替换成实际进程号:
PID=12345

readlink -f /proc/"$PID"/exe
tr '\0' ' ' < /proc/"$PID"/cmdline
printf '\n'
cat /proc/"$PID"/cgroup
如果服务由systemd管理,再查看其控制组:
systemctl status report.service --no-pager
systemd-cgls /system.slice/report.service
这里要区分三种情况:
| 观察结果 | 更可能的含义 | 下一步 |
|---|---|---|
| 多个PID在同一个service的cgroup中 | 同一服务派生了多个子进程、工作进程或线程 | 检查应用的worker配置和进程树 |
多个PID分属report.service、report@a.service等不同cgroup | 存在多个unit或模板实例 | 检查timer、实例参数和启动入口 |
进程不在预期cgroup中,或服务已显示inactive但进程仍在 | 进程可能被后台化、脱离管理或成为孤儿进程 | 检查ExecStart、Type和KillMode |
| 命令行相同,但启动时间不同且由不同用户运行 | 可能同时存在系统级和用户级服务,或另有Cron任务 | 检查两个systemd manager及计划任务 |
| 只有线程数增加,没有多个独立PID | 可能是同一个进程的线程或运行时worker | 使用ps -L -p PID和应用指标确认 |
systemctl status中的Main PID只是systemd认定的主进程,不一定等于所有实际工作的进程。判断“是否重复”时,cgroup、父子关系和启动时间比单看命令行更可靠。
可以把问题分成四层。每一层的现象不同,检查动作也不同,不能只看到多个PID就归因于timer。
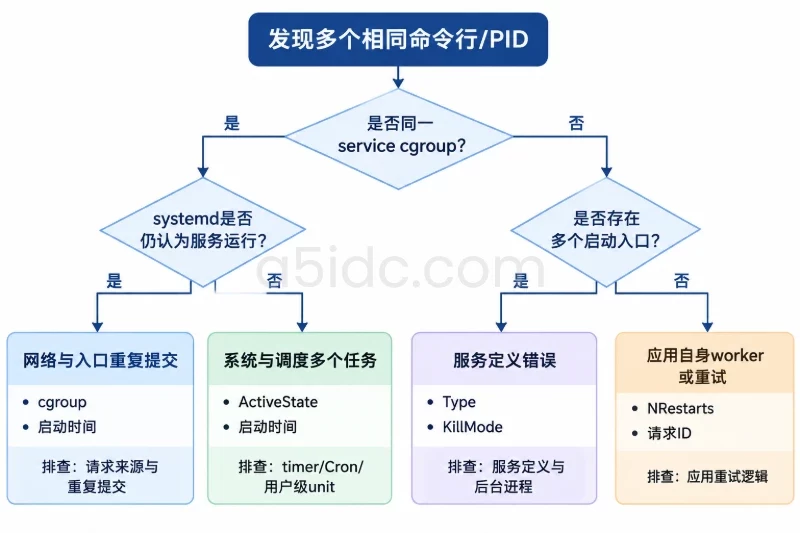
| 层级 | 常见原因 | 典型观察依据 |
|---|---|---|
| 网络与入口 | 请求超时后重试、回调重复投递、负载均衡重发 | 同一业务任务有多个请求ID或相近时间的入口日志 |
| 系统与调度 | 多个timer、Cron、用户级服务、模板实例、临时unit | 进程属于不同cgroup,或多个调度器都指向相同脚本 |
| 服务定义 | ExecStart后台化、Type声明错误、PID文件不准确、KillMode导致子进程残留 | systemd显示任务已结束,但实际进程继续运行 |
| 应用实现 | worker池、应用内定时器、无锁重试、子进程并发 | 进程都属于同一unit,应用日志显示多个执行上下文 |
systemd定时任务通常由.timer触发对应的.service,但同一个脚本也可能被多个timer、Cron、部署脚本或人工命令调用。
先列出所有timer:
systemctl list-timers --all --no-pager
再检查目标服务的反向依赖和关联关系:
systemctl list-dependencies --reverse report.service
systemctl status report.service --no-pager
查看timer和service的完整定义,包括覆盖配置:
systemctl cat report.timer
systemctl cat report.service
下面是一个模拟输出,用于说明判断方式,并不代表某台服务器的实际结果:
NEXT                         LEFT     LAST                         PASSED   UNIT          ACTIVATES
Mon 2025-01-20 02:00:00 UTC  18min    Mon 2025-01-20 01:00:00 UTC  42min    report.timer  report.service
Mon 2025-01-20 02:05:00 UTC  23min    Mon 2025-01-20 01:05:00 UTC  37min    report2.timer report.service
如果两个timer都指向同一个report.service,它们会制造多个启动请求,但同一个service仍然由systemd统一管理。若服务已经正确保持前台运行,第二次请求通常不会形成第二个主实例;如果服务已经被错误地标记为结束,第二个请求就可能启动新的后台进程。
不要只检查系统级timer,还要检查:
systemctl --user list-timers --all --no-pager
systemctl --user list-units --type=service --all --no-pager
用户级systemd需要在对应用户会话中执行。除此之外,还应核对各个任务所有者的Cron:
crontab -l
sudo crontab -l
sudo ls -la /etc/cron.d /etc/cron.daily /etc/cron.hourly
如果是模板服务,还要特别留意实例:
systemctl list-units --type=service --all | grep -E 'report(@|\.service)'
systemctl list-unit-files | grep -E 'report(@|\.service)'
report@.service是模板,report@a.service和report@b.service是两个相互独立的实例。它们可以同时执行同一份程序,即使程序命令行看起来完全相同。
检查服务的关键属性:
systemctl show report.service \
  -p Type \
  -p ActiveState \
  -p SubState \
  -p MainPID \
  -p ControlPID \
  -p Result \
  -p NRestarts \
  -p Restart \
  -p PIDFile \
  -p KillMode \
  -p FragmentPath \
  -p DropInPaths
重点观察:
ActiveState=active且SubState=running:systemd认为服务仍在运行。ActiveState=inactive,但相关程序仍存在:通常说明程序已经脱离服务生命周期,或systemd没有正确识别主进程。NRestarts持续增加:可能不是重叠启动,而是进程反复崩溃后被Restart=拉起。FragmentPath和DropInPaths指向意外位置:可能存在发行版默认配置与/etc/systemd/system覆盖配置的冲突。KillMode=process:停止服务时只处理主进程,子进程可能继续留在系统中,下一次启动就会形成旧进程与新进程并存。systemd服务文件通常按以下位置参与加载,管理员配置一般会覆盖发行版提供的同名unit:
/etc/systemd/system/
/run/systemd/system/
/usr/lib/systemd/system/
不要只打开/usr/lib/systemd/system/report.service判断配置,因为真正生效的内容可能来自/etc/systemd/system/report.service或其.d目录。systemctl cat和systemctl show -p FragmentPath -p DropInPaths更适合确认最终来源。
以下配置容易造成“systemd任务重复”的表象:
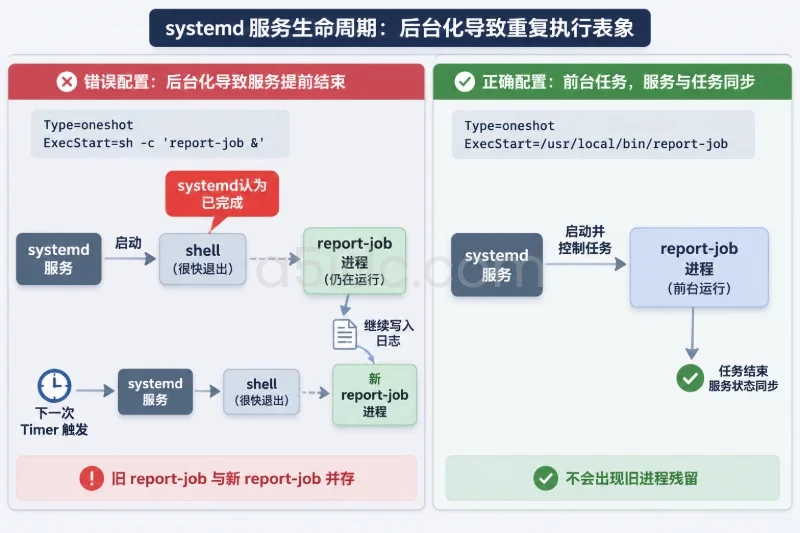
[Service]
Type=oneshot
ExecStart=/bin/sh -c '/usr/local/bin/report-job >> /var/log/report.log 2>&1 &'
shell启动任务后立即退出,systemd会认为ExecStart已经完成,而真正的程序仍在后台运行。定时器下一次触发时,systemd可能再次执行这段命令。
如果程序本身是前台任务,应让systemd直接持有它:
[Service]
Type=oneshot
ExecStart=/usr/local/bin/report-job
如果程序是长期运行的worker,应让程序以前台模式运行:
[Service]
Type=simple
ExecStart=/usr/local/bin/report-worker --foreground
Restart=on-failure
如果软件确实只能自行daemonize,则应使用与软件行为匹配的Type=forking,并设置准确的PID文件:
[Service]
Type=forking
ExecStart=/usr/local/bin/report-worker
PIDFile=/run/report-worker.pid
Restart=on-failure
PIDFile必须由实际主进程创建,路径和权限也要与服务用户一致。PID文件过期、指向旧进程或根本没有生成,都会让systemd对主进程的判断失真。
另一个容易混淆的选项是:
[Service]
Type=oneshot
ExecStart=/usr/local/bin/report-job
RemainAfterExit=yes
RemainAfterExit=yes会让一次执行成功后的服务保持active (exited)状态。对于希望由timer周期触发的短任务,这可能导致后续触发被认为服务仍然处于活动状态,从而出现“没有重复执行”或“任务不再执行”的相反问题。因此,是否设置它要根据任务语义判断,不能作为防重叠的通用开关。
如果所有进程都在同一个service cgroup内,且主进程本身仍然活跃,常见原因已经转向应用层:
网络重试通常不会直接让systemd启动第二个service,但它可能让应用同时处理两次相同业务任务。可以将应用访问日志、反向代理日志和任务日志按时间对齐,关注以下字段:
当前连接情况可以作为辅助观察:
ss -ntp
但ss只能说明当前连接,不能证明历史上是否有重复任务。若同一service下存在多个worker,连接数增加也可能是正常并发,必须结合应用的任务状态和日志判断。
先记录所有疑似进程的PID、启动时间和cgroup:
for PID in $(pgrep -f '/usr/local/bin/report-job'); do
    echo "===== PID $PID ====="
    ps -o pid,ppid,lstart,etime,stat,cmd -p "$PID"
    cat /proc/"$PID"/cgroup
done
不同结果对应不同方向:
继续检查应用是否有worker、子进程或内部定时器,不要先修改timer。
找出每个unit的启动入口,再比较它们的ExecStart、timer和启用状态。
重点检查后台化、Type、PIDFile和KillMode。
检查systemctl与systemctl --user两套管理器,确认是否重复部署。
需要同时检查宿主机和容器内部的调度配置,不能只看宿主机的service列表。
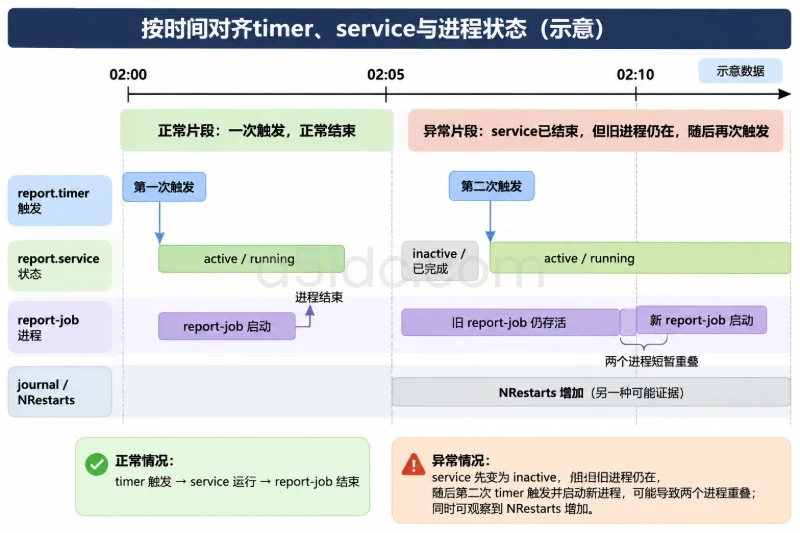
查看服务和timer在故障时间段的日志:
journalctl -u report.timer -u report.service \
  --since "2025-01-20 01:50:00" \
  --until "2025-01-20 02:20:00" \
  -o short-precise --no-pager
也可以查看服务当前配置的实际启动时间和重启次数:
systemctl show report.service \
  -p ExecMainStartTimestamp \
  -p ExecMainExitTimestamp \
  -p ActiveEnterTimestamp \
  -p InactiveExitTimestamp \
  -p NRestarts \
  -p Result
如果每次旧进程退出后很快出现新进程,同时NRestarts增长,优先检查Restart=和进程退出原因。如果服务日志显示已经成功结束,但程序仍继续写日志,则优先检查后台化或子进程脱离。
查看完整配置:
systemctl cat report.service
systemctl cat report.timer
检查是否存在多个同名或相似unit:
systemctl list-units --type=service --all --no-pager | grep -i report
systemctl list-units --type=timer --all --no-pager | grep -i report
特别检查以下项目:
.timer的Unit=是否明确指向预期service;report.timer和report2.timer;report.service和report@*.service;ExecStart是否通过shell使用了&、nohup或后台脚本;Type=是否与程序实际行为一致;PIDFile=;KillMode=process;Restart=或ExecStart=。不要仅凭systemctl is-enabled report.service判断任务来源。service可能被timer、其他service、手工命令或应用脚本启动;is-enabled主要说明开机启用状态,不能列出全部启动者。
如果服务cgroup如下:
/system.slice/report.service
├─2201 /usr/local/bin/report-worker --foreground
├─2208 /usr/local/bin/report-worker --child
└─2209 /usr/local/bin/report-worker --child
这更像一个主进程和两个工作子进程,而不是三个timer实例。此时应该查看程序的worker数量、任务队列和业务日志。
如果应用确实只能同时处理一个任务,可以在应用层增加互斥机制。单机短任务可以使用flock作为额外保护:
[Service]
Type=oneshot
ExecStart=/usr/bin/flock -n /run/report-job.lock /usr/local/bin/report-job
使用前先确认路径:
command -v flock
服务用户必须有权限创建锁文件。flock只能保护同一台主机上的同一个锁路径,不能替代跨主机锁、数据库唯一约束或业务幂等设计。它也不能修复错误的Type和后台化配置,只能作为最后一道防线。
下面几种证据组合,通常可以把范围缩小到具体配置:
证据是所有PID都出现在systemd-cgls /system.slice/report.service下,服务状态仍为active (running),应用日志中还能找到多个worker或任务上下文。
这通常是正常的进程模型,除非业务要求单并发。应检查应用worker数、任务锁和任务ID,而不是重复创建或禁用timer。
如果看到以下结构:
/system.slice/report@a.service
/system.slice/report@b.service
即使两个实例的命令行相同,systemd也会把它们当作两个独立服务。应继续查找是谁启用了或启动了这些实例,并确认实例参数是否代表不同租户、目录或队列。只有在确认其中一个实例不再需要后,才考虑调整启用关系。
例如模拟状态如下:
Active: inactive (dead)
Main PID: 0
同时pgrep仍能找到任务进程,常见原因包括:
ExecStart通过shell将任务放到后台;Type;KillMode=process使子进程在停止时未被清理。这类场景最容易在下次timer触发时形成旧进程与新进程并存。
NRestarts持续增加如果Restart=on-failure或其他重启策略生效,进程可能短时间内退出并重新启动。若旧进程因子进程残留,新进程就会被误认为“重叠执行”。
此时要先查退出原因:
journalctl -u report.service -b --no-pager
systemctl status report.service --no-pager
不要仅仅把Restart=改成no。这可能隐藏崩溃,却无法解决任务重复和数据一致性问题。
如果systemd只有一个service实例,但业务日志中同一任务ID出现多次,问题可能来自上游超时重试、消息重复投递或应用内部重试。此时调整timer并不能解决重复业务,应该增加幂等键、唯一约束或消费确认机制,并记录每一次执行的来源和结果。
配置修改前应先保存当前状态和配置,尤其是生产环境。服务重启可能中断正在执行的任务,禁用timer可能导致后续调度暂停,需要根据任务是否允许延迟来安排操作。
先保存诊断信息:
systemctl cat report.service > /tmp/report.service.before.txt
systemctl cat report.timer > /tmp/report.timer.before.txt
systemctl show report.service > /tmp/report.service.properties.before.txt
systemctl show report.timer > /tmp/report.timer.properties.before.txt
如果需要修改自定义unit,先确认FragmentPath。发行版目录下的原始unit不建议直接编辑,优先使用systemctl edit report.service创建drop-in。修改内容应围绕一个明确目标:
Type;PIDFile;KillMode恢复为能管理整个服务进程组的配置,除非应用有明确理由采用其他模式。修改后重新加载配置:
sudo systemctl daemon-reload
daemon-reload只让systemd重新读取unit,不等于重启服务。若需要停止重复实例或重启服务,要先评估任务影响。可以在维护窗口执行:
sudo systemctl stop report.timer
sudo systemctl stop report.service
这类命令会停止调度和当前任务,执行前应确认是否允许中断,并保留恢复步骤。修复完成后按需要恢复:
sudo systemctl start report.service
sudo systemctl start report.timer
如果确认存在多余timer,先记录其当前启用状态,再处理启用关系。disable --now会同时取消开机启用并立即停止对应timer,影响范围是该timer负责的调度,不会自动删除unit文件:
sudo systemctl disable --now report2.timer
回滚时可以重新启用:
sudo systemctl enable --now report2.timer
实际是否回滚,应以业务负责人确认的单一调度入口为准,不能简单把所有timer都重新打开。
恢复验证至少包括以下几项:
systemctl is-active report.timer
systemctl is-active report.service
systemctl list-timers --all --no-pager | grep -i report
systemctl status report.service --no-pager
systemd-cgls /system.slice/report.service
然后进行一次受控测试,记录开始时间、结束时间、PID、unit名称和任务ID。在一个完整调度周期内观察:
NRestarts是否保持稳定;如果服务的正常运行时间可能超过timer间隔,应专门测试“前一次尚未结束时再次到达触发时间”的场景。对于配置正确的同一个service,通常不会因此产生第二个独立主实例;若测试仍出现多个cgroup或多个实例,就回到启动源和unit模板分支继续检查。
这类问题不适合只监控CPU和进程数,因为worker数量增加可能是正常现象。更有价值的是记录“任务执行实例”的完整生命周期:
InvocationID或应用生成的执行ID;主机侧可以定期采集以下状态:
systemctl show report.service \
  -p ActiveState \
  -p SubState \
  -p MainPID \
  -p NRestarts \
  -p Result
建议设置的告警条件包括:
inactive,但对应程序仍在运行;NRestarts在短时间内持续增加;这样处理后,看到多个PID时就能先判断它们属于哪一层:是同一服务的正常worker、不同unit的调度冲突、服务生命周期声明错误,还是应用与网络入口造成的重复业务。只有完成这层归属确认,才适合修改timer或终止进程,避免把正常并发误判为systemd重复启动。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/8752.html